
Was ist der Browser-Voice-Fingerprint? Wie die Sprachliste von SpeechSynthesis Ihre Umgebung verrät
Kernaussage: Der Voice-Fingerprint liest, welche synthetischen Stimmen auf dem Gerät installiert sind. Diese Konfigurationsliste hängt am Betriebssystem und ändert sich weder durch einen Proxy-Wechsel noch durch das Löschen von Cookies. Wenn Sie die Signal-Konsistenz mehrerer Konten prüfen, ist sie nach Canvas und AudioContext der Punkt, der am ehesten übersehen wird.
„Der Proxy ist gewechselt, die Cookies sind gelöscht, und trotzdem stimmt die Umgebungserkennung nicht?" Wer Konten prüft, findet die Antwort oft in Parametern auf Geräteebene. Die Sprache gehört zu den am leichtesten übersehenen davon. Websites brauchen weder Zugriff aufs Mikrofon noch müssen sie irgendeinen Ton abspielen: Ein einziger API-Aufruf liefert eine Liste, die viel über die Systemkonfiguration verrät.
Diese Liste wird vom Betriebssystem und den Sprachpaketen bestimmt und folgt dem Gerät. Auch ein neuer IP lässt sie unberührt. MostMate ist ein Anti-Detect-Browser für genau solche Fälle und richtet für jedes Konto eine eigene Browser-Umgebung ein. Auch die Parameter auf Geräteebene liegen im Verwaltungsbereich, die Sprache gehört dazu.
Was ist ein Voice-Fingerprint? Und wie unterscheidet er sich von der Voiceprint-Erkennung?
Voice-Fingerprinting liest Konfigurationsdaten, keine Aufnahmen.
Trennen Sie zunächst drei Begriffe. Sprachsynthese meint die Fähigkeit des Browsers, Text in Sprache umzuwandeln, also das System hinter der Vorlesefunktion. Die Sprachliste umfasst die Stimmen, die dieser Funktion in der aktuellen Umgebung zur Verfügung stehen. Laut der MDN-Dokumentation gibt getVoices() eine Liste der auf dem Gerät verfügbaren Voice-Objekte zurück. Als Voice-Fingerprint bezeichnet man es, wenn eine Website Merkmale aus dieser Liste als Signal zur Umgebungserkennung nutzt. Jeder Begriff ist einen Grad konkreter als der vorherige.
Der Vergleich mit der Voiceprint-Erkennung macht den Unterschied schnell klar: Dort braucht es eine Aufnahme, eine Berechtigung und tatsächlich gesprochene Worte. Der Voice-Fingerprint bleibt durchgehend stumm und fragt nichts an. Die Website liest das Menü, nicht die Stimme. Genau darin liegt der Unterschied, und genau darin auch der Grund, warum er oft übersehen wird: Ohne Popup und ohne dass jemand etwas merkt, sind die Daten bereits übergeben.
Wie gibt SpeechSynthesis die Sprachliste an Websites weiter?
Websites lesen die Liste über speechSynthesis.getVoices() aus; ein einziger Aufruf liefert den vollständigen Bestand.
Jedes Voice-Objekt trägt fünf Felder. Ihre Bedeutung zeigt die Tabelle:
| Feld | Bedeutung | Typische Werte |
|---|---|---|
| name | Name der Stimme | Microsoft David, Samantha |
| lang | Sprach-Tag | en-US, zh-CN |
| localService | Lokale Synthese oder Cloud-Dienst | true = lokal, false = online |
| default | Standard-Stimme | höchstens eine pro Sprache |
| voiceURI | Kennung des Sprachdienstes | kann interne Systemmarken enthalten |
Der Name ist oft nur ein Personenname; die eigentlichen Informationen stecken in voiceURI. Bei Firefox unter macOS sieht der Wert etwa so aus: urn:moz-tts:osx: plus eine interne Systemkennung. Über eine öffentliche Schnittstelle geben Browser auf diese Weise private Registrierungsdaten des Systems preis.
Ein weiteres Detail beeinflusst das Ergebnis. In Chrome, Edge und Firefox liefert der erste Aufruf häufig ein leeres Array; erst nachdem das voiceschanged-Ereignis gefeuert hat, ist die Liste vollständig. Schon der Ladezeitpunkt ist ein Signal: Manche Browser feuern sofort, andere mit Verzögerung, wieder andere gar nicht mehr, wenn alles bereits geladen war. In der Web Speech API Spezifikation steckt dieser Teil bis heute im Entwurfsstatus; maßgeblich ist das Verhalten der jeweiligen Browser-Implementierung.
Welche vier Arten von Umgebungsmerkmalen gibt die Sprachliste preis?
Eine einzelne Stimme sagt wenig aus; die Zusammensetzung der Liste ist es, die unterscheidet.
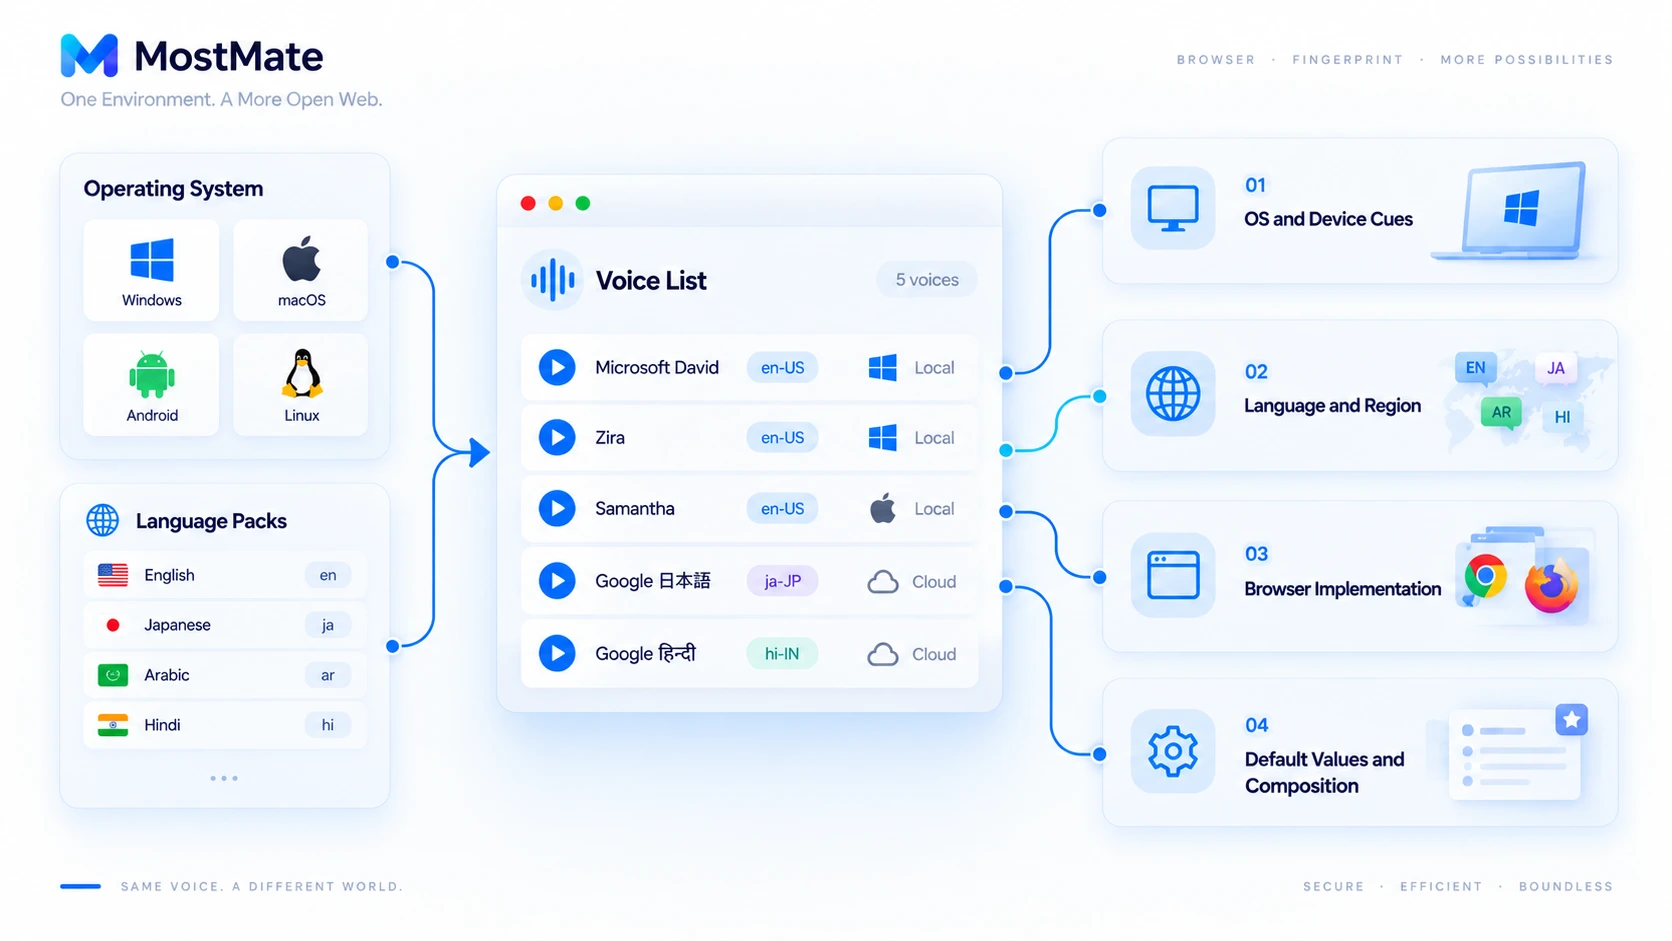
Erste Art: Betriebssystem und Gerät. Die Stimmen kommen vom Sprachdienst des Systems. Unter Windows tauchen Namen wie Microsoft David oder Zira auf, unter macOS Samantha oder Daniel, auf Android-Handys das Set des Google-Sprachdienstes. Auf Linux-Desktops ohne installierten Sprachdienst bleibt die Liste oft leer.
Zweite Art: Sprach- und Regionaleinstellungen. Die Kombination der lang-Tags zeigt, welche Sprachpakete auf dieser Maschine einmal installiert wurden. Eine Liste mit japanischen, arabischen und Hindi-Stimmen meldet der Website einen mehrsprachigen Hintergrund, an den sich die Nutzer selbst kaum noch erinnern.
Dritte Art: Unterschiede zwischen Browsern. Chrome legt über die Systemstimmen hinaus die Cloud-Stimmen von Google oben drauf. Über localService lässt sich lokale Synthese von Onlinediensten trennen. Dieselbe Maschine liefert in Chrome und Firefox unterschiedlich zusammengesetzte Listen.
Vierte Art: Standardwerte und Gesamtkombination. Anzahl, Reihenfolge, Sprach-Tags und Standard-Stimme ergeben zusammen ein Umgebungssignal mit hoher Trennschärfe. Eine Grenze gehört dazu: Es bleibt ein Hinweis unter mehreren, und erst aus vielen Signalarten zieht eine Website Schlüsse. Eine einzelne Sprachliste identifiziert keine konkrete Person.
Wo liegt der Unterschied zwischen Voice-, AudioContext- und Canvas-Fingerprint?
Alle drei werden oft in einem Atemzug genannt, doch jedes Verfahren beobachtet etwas völlig anderes. Zuerst der Überblick:
| Erkennungsmethode | Beobachtungsgegenstand | Verfahrensweise |
|---|---|---|
| SpeechSynthesis-Voice-Fingerprint | verfügbare Sprachliste samt Feldern | Konfigurationsliste lesen, ganz ohne Ton |
| AudioContext-Fingerprint | Ergebnis von Audio-Berechnungen | rechnen und Ausgabedifferenzen vergleichen |
| Canvas-Fingerprint | Merkmale der Grafikausgabe | Bild rendern und Pixel vergleichen |
| Font-Fingerprint | im System installierte Schriften | Verfügbarkeit von Schriften abfragen |
Sprachliste aufzählen und Audio rendern sind zwei getrennte Wege: Der eine liest eine statische Bestandsliste, der andere rechnet ein dynamisches Ergebnis aus. Beides darf man nicht verwechseln. Im Artikel zum AudioContext-Fingerprint geht es um Prinzip und Einstellungen des zweiten Wegs. Der Font-Fingerprint gehört wie die Sprachliste zur Kategorie der statischen Bestandslisten, also zu direkten Ablesungen dessen, was das Gerät installiert hat.
Wie prüfen Sie, welche Sprachdaten Ihr Browser preisgibt?
Dafür genügt ein Blick in die Entwicklertools; in fünf Minuten haben Sie die Liste, die auch Websites sehen.
- Öffnen Sie die Konsole der Entwicklertools, geben Sie speechSynthesis.getVoices() ein, bestätigen Sie mit der Eingabetaste und sehen Sie sich die Rückgabe an.
- Klappen Sie die Voice-Objekte auf und notieren Sie die Werte von name, lang, localService und voiceURI.
- Laden Sie die Seite neu und fragen Sie sofort erneut ab: War das erste Ergebnis ein leeres Array? So bestätigen Sie das asynchrone Nachladen.
- Wiederholen Sie die Schritte auf einem anderen Rechner oder System und prüfen Sie, ob die Unterschiede vom System-Sprachdienst oder von der Browser-Implementierung stammen.
- Schalten Sie einen Proxy dazwischen und fragen Sie erneut ab. Meist bleibt die Liste unverändert, und genau das bestätigt: Es ist ein Signal der Geräteebene.
Bei der Deutung gelten zwei Einschränkungen. Eine leere Liste heißt nicht, dass es keinen Voice-Fingerprint gibt; die Leere selbst ist eine Information. Linux ohne Sprachdienst und manche Automatisierungsumgebungen liefern häufig ein leeres Array. Umgekehrt macht eine lange Liste niemanden leichter erkennbar. Entscheidend ist, ob die Umgebung als Ganzes stimmig wirkt, nicht die Zahl einzelner Parameter.
Wie steuert MostMate die Voice-Merkmale der Umgebung?
Die Sprachliste zählt zu den Parametern auf Geräteebene. Der Fingerprint-Browser nimmt sie deshalb in die Umgebungskonfiguration auf, statt sie sich selbst zu überlassen.
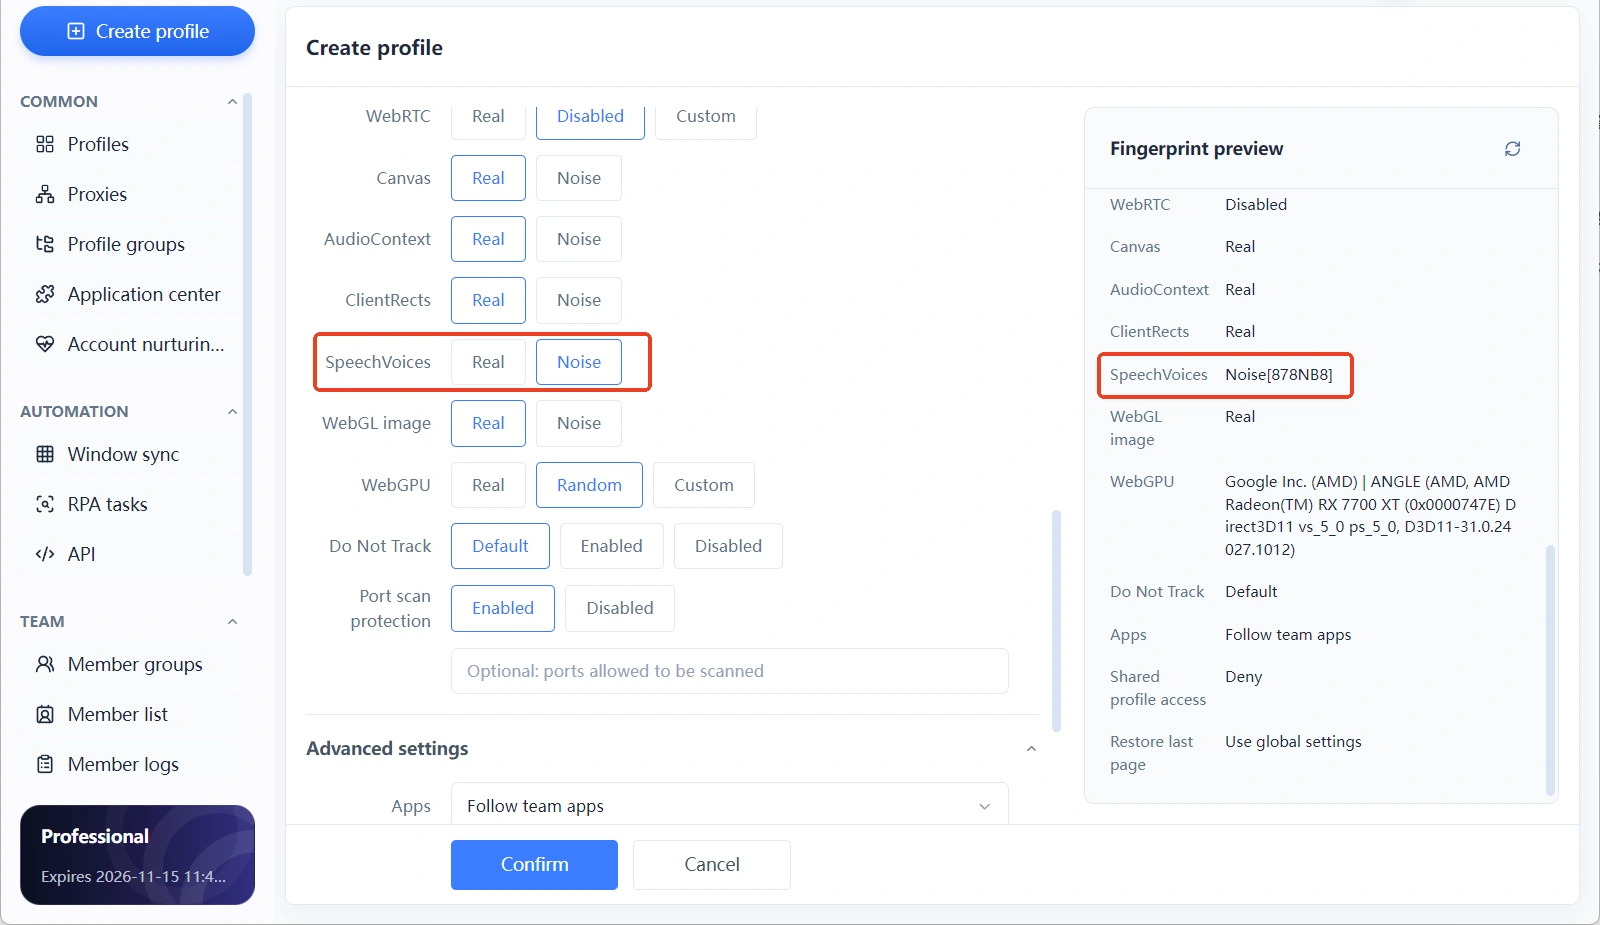
In den „Fingerprint-Einstellungen" (指纹设置) beim Anlegen oder Bearbeiten einer Umgebung in MostMate ist SpeechVoices ein eigenständiger Parameter neben Canvas, AudioContext, ClientRects und WebGL-Grafik. Es gibt die zwei Stufen Real und Noise, wobei Noise dem Rauschmodus entspricht.
Wählen Sie Noise, zeigt das Vorschau-Panel rechts in der Zeile SpeechVoices einen Wert mit sechsstelligem Code. Canvas und AudioContext haben jeweils eigene Codes, die sich nicht gegenseitig ersetzen. Der Code kennzeichnet nur die Noise-Konfiguration; welchen Hash die Umgebung tatsächlich exponiert, sehen Sie auf der Umgebungszugriffs-Testseite.
Stellen Sie Sprachparameter nie isoliert ein. Betriebssystem, Sprache und Zeitzone der Umgebung bestimmen, wie die Sprachliste aussehen sollte. Ein Windows-Profil mit einem Set aus macOS-Stimmen wäre ein offensichtlicher Widerspruch. Sinnvoll ist die Reihenfolge: erst System und Proxy festlegen, dann Parameter auf Geräteebene wie die Sprachliste abgleichen. Das ist verlässlicher, als einzelne Punkte blind durchzuprobieren.
Wenn Sie jeden Punkt einzeln steuern möchten, gehen Sie die Liste unter Manuelle Fingerprint-Einstellungen auf der Website durch. Um Zeit zu sparen, packen Sie beim Anlegen der Umgebung diese Parameter in die empfohlene Konfiguration und prüfen später einzelne Punkte nach. Auch die Grenze sei genannt: Der Fingerprint-Browser verwaltet die Umgebungskonfiguration, kann aber nicht garantieren, dass Websites die Umgebung nicht erkennen oder dass Konten keine Plattform-Verifizierung auslösen. Die Konten selbst müssen weiterhin die Regeln der jeweiligen Plattform einhalten.
Häufige Fragen
Zeichnet der Voice-Fingerprint meine Stimme auf?
Nein. Der gesamte Vorgang berührt weder das Mikrofon noch gibt er Ton wieder. Die Website erhält ausschließlich die Konfigurationsliste des System-Sprachdienstes. Voiceprint-Erkennung verlangt eine Aufnahmeberechtigung; der Voice-Fingerprint kommt ohne jede Berechtigung aus.
Warum unterscheiden sich die Sprachlisten zweier Computer?
Die Stimmen ergeben sich aus Betriebssystem, Sprachpaketen und Sprachdienst. Windows und macOS bringen unterschiedliche eingebaute Stimmen mit, die installierten Sprachpakete fallen anders aus, und die Cloud-Stimmen, die der Browser zusätzlich einblendet, sind ebenfalls nicht identisch. Dass beide Listen nicht übereinstimmen, ist also völlig normal.
Bedeutet eine leere Sprachliste, dass kein Voice-Fingerprint vorliegt?
Auch eine leere Liste ist eine Information. Linux ohne Sprachdienst und manche Automatisierungsumgebungen liefern häufig ein leeres Array. Für Websites ist das ein auffälliges Merkmal; Tarnung ist das keine.
Sind Voice-Fingerprint und AudioContext-Fingerprint dasselbe?
Nein. Der Voice-Fingerprint liest eine statische Konfigurationsliste, der AudioContext-Fingerprint rechnet ein dynamisches Audio-Ergebnis aus. Die Erkennungswege sind verschieden; prüfen Sie beide getrennt, wenn Sie eine Umgebung durchleuchten.
Kann MostMate die SpeechSynthesis-Sprachliste separat ändern?
Im Produkt entspricht das dem Parameter SpeechVoices in den Fingerprint-Einstellungen mit den beiden Stufen Real und Noise; wie fein die Steuerung möglich ist, zeigt die Client-Oberfläche. Kontrollieren Sie danach auf der Umgebungszugriffs-Testseite, welche Liste tatsächlich nach außen geht.
Fazit
Am Ende bleibt es dabei: Der Voice-Fingerprint meldet der Website, was auf diesem Gerät installiert ist. Er nimmt nichts auf, verlangt keine Rechte, folgt aber dem Betriebssystem. Auch ein neuer IP ändert daran nichts. Deshalb erklären sich viele gängige Gewohnheiten von selbst: Wer nur Cookies löscht oder nur den Proxy wechselt, sollte bei Unstimmigkeiten die Parameter auf Geräteebene mit abgleichen.
Auf der Produktseite führt MostMate SpeechVoices zusammen mit Canvas und AudioContext in den Fingerprint-Einstellungen; gesteuert wird über die beiden Stufen Real und Noise. Einen Überblick über die übrigen Funktionen verschaffen Sie sich am besten direkt auf der MostMate-Website.
Wollen Sie sehen, was Ihre Umgebung gerade preisgibt, gehen Sie die Sprachliste nach den Schritten aus Abschnitt fünf durch oder laden Sie MostMate herunter und bauen Sie eine Umgebung zum Vergleich auf.

MOSTMATE
Mehrere Konten sicher verwalten – ganz einfach
Starte mit deinem ersten Konto und gestalte mit MostMate sicherere, intelligentere und effizientere Mehrkontenabläufe.
- Unabhängige Profile. Konsistente Identitäten.
- KI-Automatisierung · Kontozustand · Teamarbeit



