
Ano ang browser voice fingerprint? Paano inilalantad ng voice list ng SpeechSynthesis ang mga katangian ng device
Buod: Ang binabasa ng voice fingerprint ay kung anong mga synthetic voice ang naka-install sa device; configuration list ito na sumusunod sa operating system, at hindi ito magbabago kahit magpalit ka ng proxy o mag-clear ng cookies. Sa pag-audit ng signal consistency sa multi-account environment, ito ang madalas malampasan na signal pagkatapos ng Canvas at AudioContext.
"Napalitan na ang proxy, na-clear na ang cookies, pero bakit hindi pa rin tugma ang environment detection?" Kapag nag-audit ng mga account, madalas nasa device-level parameters nakatago ang sagot. Kabilang rito ang voice, isa sa pinakamadaling makaligtaan. Hindi kailangan ng website ng access sa microphone, hindi rin nito kailangang magpatugtog ng kahit anong tunog. Isang API call lang at makukuha na nito ang isang listahan na may kinalaman sa system configuration.
Ang listahang ito ay tinutukoy ng operating system at mga language pack, kaya kasunod ito ng device. Kahit magpalit ka ng IP, hindi ito gumagalaw. Ang MostMate ay isang anti-detect browser na dinisenyo para sa ganitong klaseng problema; nagbibigay ito ng sariling browser environment para sa bawat account. Kasama sa pamamahala ang mga device-level parameter, at ang voice ay isa sa mga ito.
Ano ang voice fingerprint? At ano ang pagkakaiba nito sa voiceprint recognition
Ang laman ng voice fingerprint ay speech config, hindi voiceprint.
Ipaghiwalay muna natin ang tatlong konsepto. Ang speech synthesis ay ang kakayahan ng browser na gawing boses ang teksto; ito yung system sa likod ng read-aloud feature ng mga webpage. Ang voice list naman ay ang mga voice option na available sa kasalukuyang environment. Base sa dokumentasyon ng MDN, nagre-return ang getVoices() ng listahan ng mga voice object na available sa device. Ang voice fingerprint ay ang pagtrato ng website sa mga katangiang nasa listahang ito bilang isa sa mga signal para makilala ang environment. Papasikip nang papasikip ang saklaw ng tatlo.
Mas malinaw ito kung ikukumpara sa voiceprint recognition. Ang voiceprint ay nangangailangan ng recording, permission, at tunog na talagang lalabas. Ang voice fingerprint ay tahimik mula simula hanggang dulo at walang hininging permission. Ang nababasa ng website ay menu, hindi boses. Nandiyan ang pinagkaiba, at nandiyan din ang dahilan kung bakit madali itong makaligtaan: walang pop-up, walang nararamdaman, naipasa na pala ang data.
Paano ibinibigay ng SpeechSynthesis ang voice list sa mga website?
Ang reading entry point ng website ay ang speechSynthesis.getVoices(); isang call lang at kumpleto na ang listahan.
May limang field ang bawat voice object. Ganito ang mga kahulugan:
| Field | Kahulugan | Mga karaniwang halimbawa |
|---|---|---|
| name | Pangalan ng voice | Microsoft David, Samantha |
| lang | Language tag | en-US, zh-CN |
| localService | Local synthesis o cloud service | true kung local, false kung online |
| default | Kung default na voice | Isa lang bawat wika |
| voiceURI | Identifier ng voice service | Maaaring may internal system ID |
Ang pangalan ay madalas pangalan lang ng tao; sa voiceURI nakatago ang mas malalim na impormasyon. Kunyari sa Firefox sa macOS, anyong urn:moz-tts:osx: na may kasunod na internal system identifier ang value. Nagagawa nitong ilabas sa publikong interface ang private voice registration info ng system.
May detalye pa na nakakaapekto sa resulta ng pagbasa. Sa Chrome, Edge, at Firefox, madalas empty array ang balik ng unang tawag; mapupuno lang ang mga voice pagkatapos ma-trigger ang voiceschanged event. Ang loading timing mismo ay signal din. May browser na agad nagti-trigger, may naghihintay, at may hindi na nagti-trigger kapag tapos nang na-load. Hanggang ngayon, draft pa rin ang status ng interface na ito sa specification ng Web Speech API, kaya sa implementation ng bawat browser nakadepende ang aktwal na behavior.
Anong apat na uri ng environment feature ang nailalantad ng voice list?
Walang saysay ang iisang voice name; ang kombinasyon ng listahan ang may tunay na kakayahang makilala ang environment.
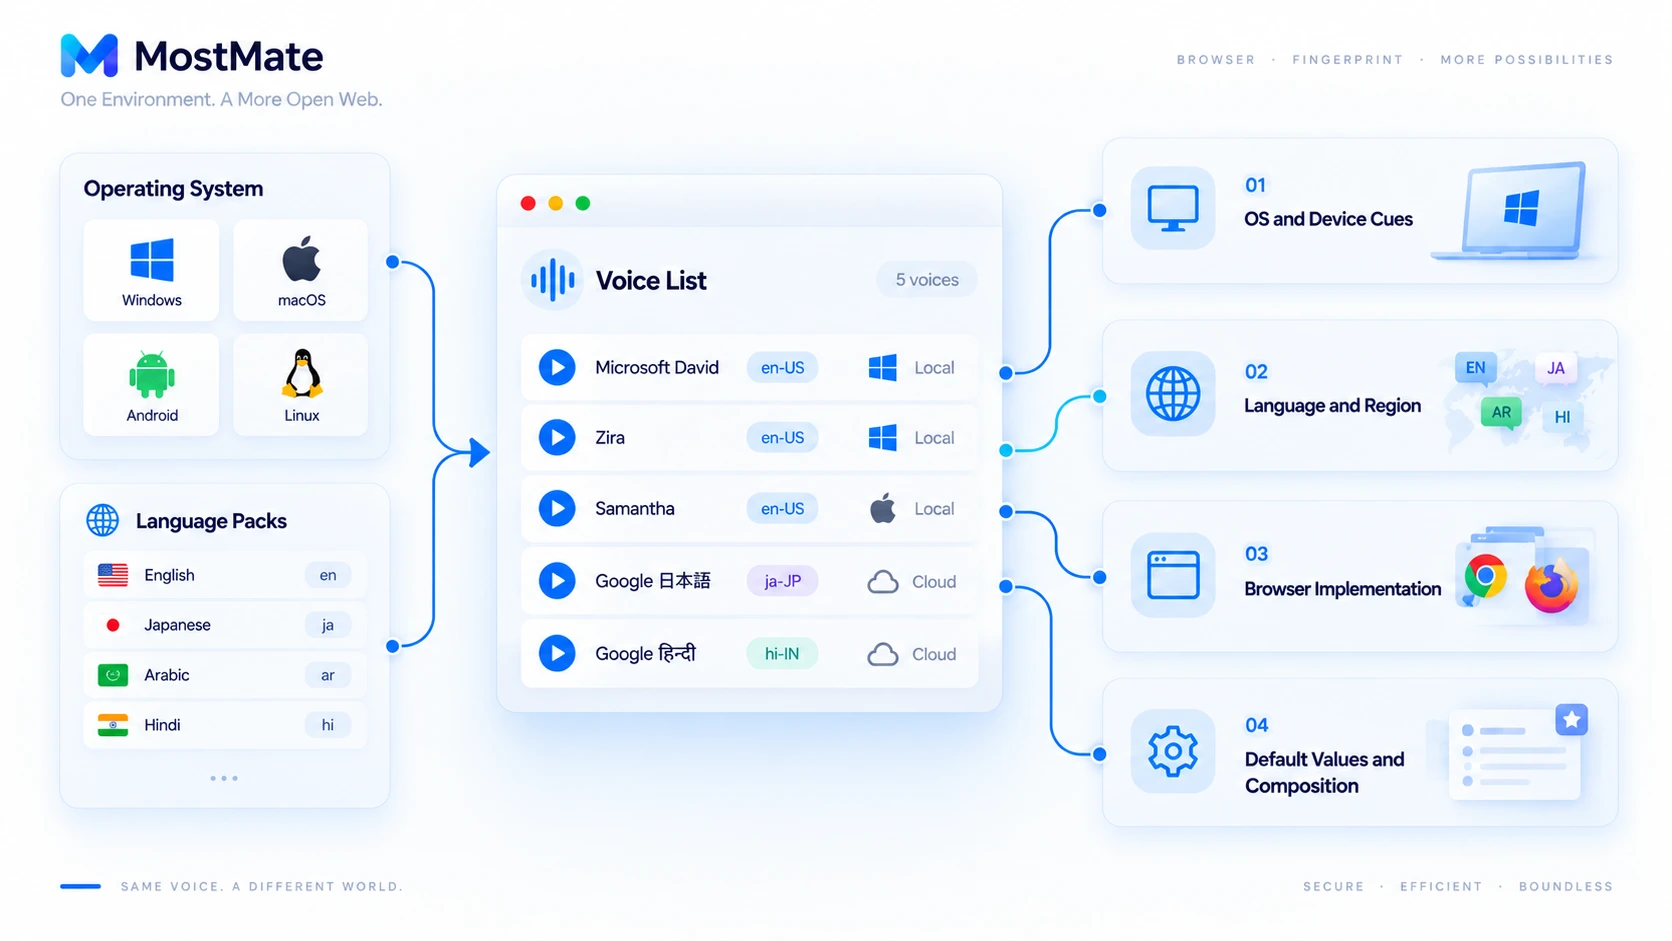
Una: mga clue sa operating system at device. Ang mga voice ay galing sa voice service ng system. Sa Windows, karaniwang nakikita ang mga pangalan tulad ng Microsoft David at Zira. Sa macOS, Samantha at Daniel. Sa mga Android phone, ang set mula sa Google voice service. Kung walang naka-install na voice service ang Linux desktop, madalas walang laman ang listahan.
Ikalawa: wika at rehiyon config. Ang kombinasyon ng mga lang tag ay nagpapakita kung anong mga language pack ang naka-install sa machine. Ang listahang may Japanese, Arabic, at Hindi voices ay parang pag-amin na multilingual ang gumagamit. Baka nga hindi maalala ng user mismo.
Ikatlo: mga pagkakaiba sa browser implementation. Nagdaragdag ang Chrome ng mga Google cloud voice sa ibabaw ng system voice. Sa localService, makikilala kung local synthesis ba o online service. Kahit iisang machine, posibleng magkaiba ang composition ng listahan ng Chrome at Firefox.
Ikaapat: default value at kabuuang kombinasyon. Ang bilang, order, mga lang tag, at default voice, kapag pinagsama-sama, ay bumubuo ng environment signal na mataas ang pagkakaiba. Isang linawin lang: isa lang ito sa mga clue; pinagsasama ng website ang maraming signal bago umabot sa konklusyon. Hindi makikilala ng isang voice list ang isang partikular na tao.
Ano ang pagkakaiba ng voice fingerprint sa AudioContext at Canvas fingerprint?
Madalas silang magkasamang binabanggit, pero magkaiba ang pinagmamasdan ng bawat isa. Tingnan muna ang paghahambing:
| Paraan ng detection | Pinagmamasdan | Katangian ng proseso |
|---|---|---|
| Voice fingerprint ng SpeechSynthesis | Available na voice list at fields | Pagbasa ng config list, tahimik lahat |
| AudioContext fingerprint | Resulta ng audio processing computation | May computation, kinukumpara ang outputs |
| Canvas fingerprint | Katangian ng graphics rendering output | Pag-render ng image, comparison ng pixel |
| Font fingerprint | Mga naka-install na font at rendering | Pagsusuri ng font availability |
Magkaibang landas ang voice list enumeration at audio rendering; ang isa ay pagbasa ng static na listahan, ang isa ay pagkalkula ng dynamic na resulta. Hindi dapat ihalo ang dalawa. Ang tungkol sa AudioContext fingerprint ay nagpapaliwanag ng prinsipyo at setting ng pangalawang landas. Ang font fingerprint naman ay kabilang sa static na listahan kagaya ng voice list; pareho silang direktsang basa ng mga naka-install sa device.
Paano susuriin kung anong voice information ang inilalantad ng browser?
Kailangan lang ng developer tools ang pagsusuri; sa loob ng limang minuto, hawak mo na ang listahang nakikita ng website.
- Buksan ang Console sa developer tools, i-type ang speechSynthesis.getVoices(), at pindutin ang Enter para makita ang resulta.
- I-expand ang mga voice object sa listahan at itala ang mga value ng name, lang, localService, at voiceURI.
- I-refresh ang page at agad na mag-query ulit; tingnan kung empty array ba ang unang balik para makita ang asynchronous loading behavior.
- Ulitin ang mga hakbang sa ibang computer o ibang operating system para malaman kung sa system voice service o sa browser implementation galing ang pagkakaiba.
- Maglagay ng proxy at subukan ulit; hindi magbabago ang listahan sa karamihan ng kaso, na mismo ang patunay na device-level signal ito.
Dalawang dapat tandaan sa pagbabasa ng resulta. Ang walang lamang listahan ay hindi ibig sabihing walang voice fingerprint; ang pagiging empty mismo ay isang impormasyon. Ang mga Linux na walang voice service at ilang automated environment ang madalas magbalik ng empty array. Hindi rin nangangahulugang mas madali kang makilala kapag mahaba ang listahan. Ang paghuhusga ay nakabatay sa kung magkakatugma ba ang buong environment, hindi sa bilang ng mga parameter.
Paano hinahandle ng MostMate ang mga voice environment feature?
Device-level parameter ang voice list; ang ginagawa ng anti-detect browser dito ay isama ito sa environment configuration, hindi na hayaan lang.
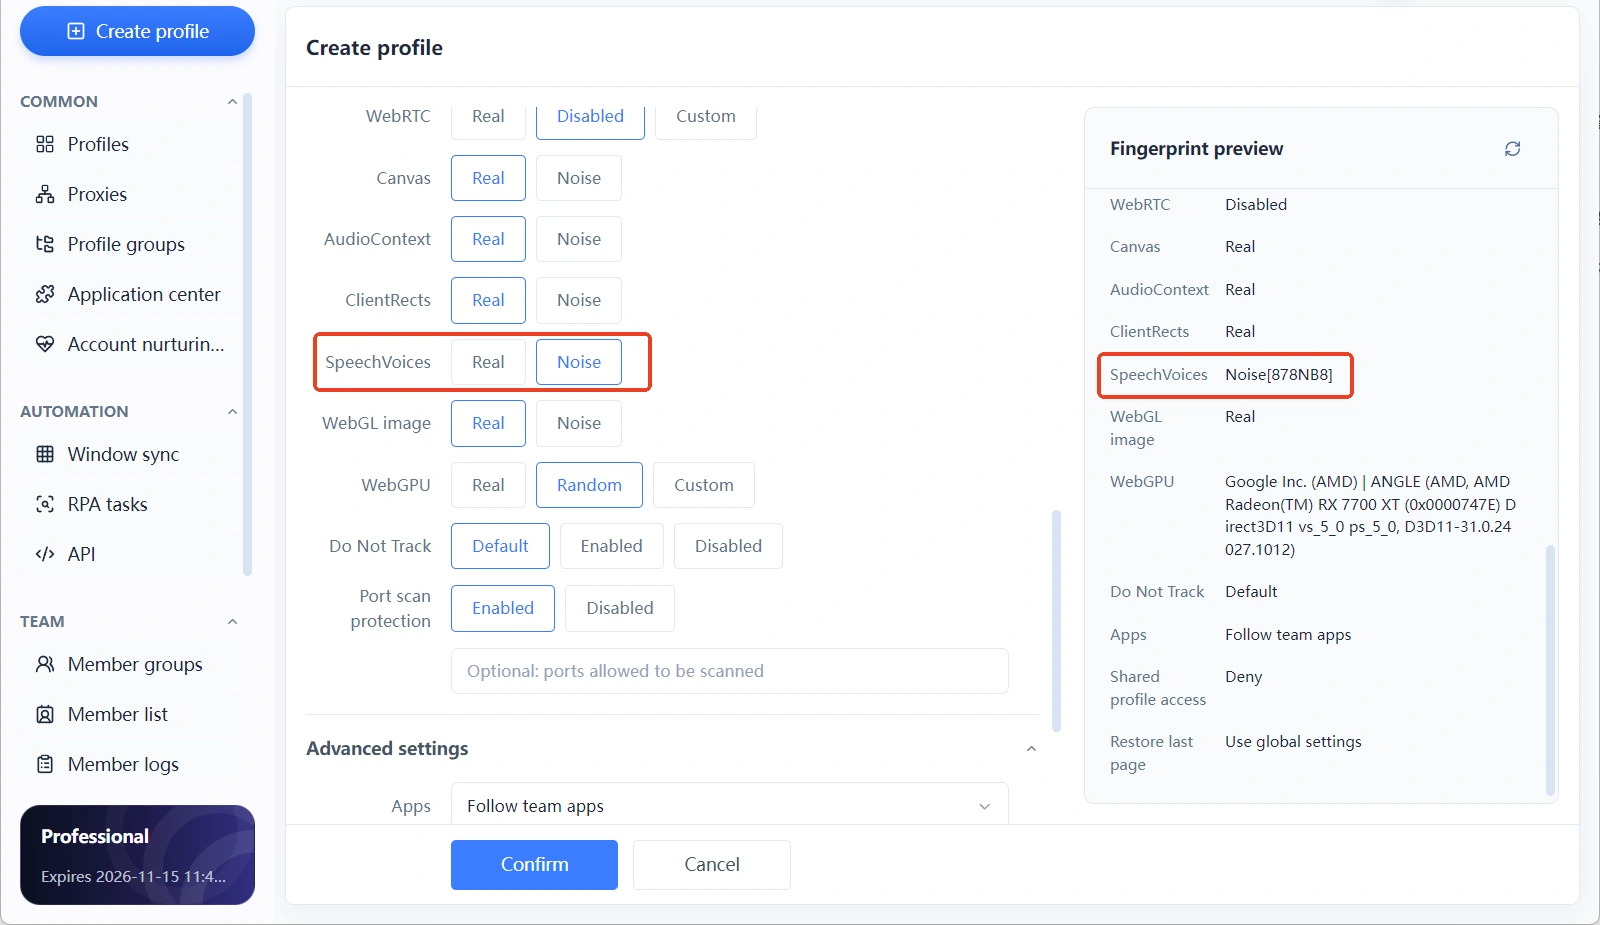
Sa paggawa o pag-edit ng environment sa MostMate, sa ilalim ng "Fingerprint Settings" (指纹设置), ang SpeechVoices ay sariling parameter na katabi ng Canvas, AudioContext, ClientRects, at WebGL image. Dalawa lang ang antas nito: Real at Noise; ang Noise ay ang noise mode.
Pagkatapos piliin ang Noise, ang SpeechVoices entry sa fingerprint preview panel sa kanan ay magpapakita ng value na may anim na digit na code. Magkakaiba ang code ng Canvas at AudioContext at hindi sila interchangeable. Ang code ay identifier ng noise configuration; ang aktwal na hash value na exposed ay makikita kapag binuksan ang environment at pinuntahan ang detection page.
Hindi dapat i-adjust ang voice parameter nang mag-isa. Ang operating system, wika, at timezone ng environment ang nagtatakda kung anong itsura dapat ang voice list. Windows environment na may set ng macOS voices? Malinaw na contradiction iyan. Ang inirerekomendang order: ayusin muna ang system at proxy, bago i-double check ang mga device-level parameter tulad ng voice. Mas maaasahan ito kaysa sa paisa-isang pagsubok.
Kung gusto mo ng item-by-item control, sundan ang manual fingerprint settings checklist sa opisyal na website. Para makatipid sa oras ng configuration, gamitin ang recommended configuration sa paggawa ng environment para mapagsama-sama ang mga parameter na ito, tapos i-review ang mga indibidwal. At isang linawin sa hangganan: ang hinahandle ng anti-detect browser ay environment configuration; hindi nito ginagarantiya na hindi makikilala ng website ang environment, at hindi rin ginagarantiya na hindi ma-trigger ng account ang platform verification. Ang account mismo ay dapat sumunod pa rin sa mga platform rule.
Mga madalas itanong
Nagre-record ba ng boses ko ang voice fingerprint?
Hindi. Walang mic na ginagamit at walang audio na pinapatakbo sa buong proseso. Ang nakukuha lang ng website ay configuration list ng system voice service. Ang voiceprint recognition ay nangangailangan ng recording permission; ang voice fingerprint ay walang hininging kahit anong permission.
Bakit magkaiba ang voice list ng dalawang computer?
Ang mga voice ay nakadepende sa operating system, language pack, at voice service. Magkaiba ang built-in voices ng Windows at macOS, magkaiba ang mga naka-install na language pack, at magkaiba rin ang cloud voices na idinadagdag ng browser. Natural lang na hindi magtugma ang mga listahan.
Walang laman ang voice list, ibig sabihin ba walang voice fingerprint?
Ang walang lamang listahan ay impormasyon din. Ang mga Linux na walang voice service at ilang automated environment ang madalas magbalik ng empty array. Para sa website, abnormal signal ito. Hindi ito stealth.
Iisa lang ba ang voice fingerprint at AudioContext fingerprint?
Hindi iisang kategorya. Ang voice fingerprint ay nagbabasa ng static na configuration list; ang AudioContext ay nagko-compute ng dynamic na resulta ng audio processing. Magkaiba ang detection path, kaya hiwalay na i-check kapag nag-audit ng environment.
Pwedeng baguhin ng MostMate ang SpeechSynthesis voice list nang hiwalay?
Sa produkto, ito ang SpeechVoices parameter sa ilalim ng Fingerprint Settings, na may Real at Noise na antas; ang gaano kagranular ang kayang i-adjust ay depende sa client interface. Pagkatapos mag-config, mainam na buksan ang environment at puntahan ang detection page para makita ang aktwal na listahang exposed.
Konklusyon
Sa pinakasimpleng salita, ibinibigay ng voice fingerprint sa website kung ano ang naka-install sa device na ito. Walang recording, walang hinihinging permission, pero sumusunod ito sa operating system. Kahit magpalit ka ng IP, hindi ito gumagalaw. Kaya mauunawaan mo kung bakit maraming karaniwang gawain ay may katwiran: paglinis lang ng cookies, pagpalit lang ng proxy. Kapag hindi tugma ang environment, kasama sa pag-align ang mga device-level parameter.
Sa product side, nilalagay ng MostMate ang SpeechVoices kasama ang Canvas at AudioContext sa loob ng Fingerprint Settings. Real at Noise lang ang dalawang antas. Para makita ang buong larawan ng ibang features, tingnan mo rin ang opisyal na website ng MostMate.
Para malaman kung ano ang inilalantad ng environment mo ngayon, sundan ang mga hakbang sa ikalimang section para i-check ang voice list, o i-download ang MostMate at gumawa ng environment para makapagkumpara.

MOSTMATE
Ligtas na Pamamahala ng Maraming Account, Pinadali
Magsimula sa unang account at gamitin ang MostMate upang bumuo ng mas ligtas, mas matalino, at mas mahusay na operasyon ng maraming account.
- Mga hiwalay na profile. Mga magkakatugmang identidad.
- AI Automation · Kalagayan ng Account · Mga Operasyon ng Team



