
Ce este amprenta vocală a browserului? Cum dezvăluie lista de voci din SpeechSynthesis mediul tău
Concluzia principală: amprenta vocală arată ce voci sintetizate sunt instalate pe un dispozitiv. Este o listă de configurare care merge odată cu sistemul de operare; schimbi proxy-ul, ștergi cookie-urile, ea rămâne la fel. Când verifici dacă semnalele unui mediu multi-cont se potrivesc, e elementul care se lasă cel mai ușor uitat, imediat după Canvas și AudioContext.
„Ai schimbat proxy-ul, ai șters cookie-urile, iar verificarea mediului tot nu se potrivește?" Cine analizează conturi găsește răspunsul de obicei în parametrii de la nivelul dispozitivului. Vocea e elementul cel mai des trecut cu vederea. Un site nu are nevoie de microfon și nu redă niciun sunet: o singură apelare de API îi aduce o listă legată de configurația sistemului.
Lista este stabilită de sistemul de operare și de pachetele de limbă și rămâne legată de dispozitiv. IP-ul se schimbă, lista nu. MostMate este un browser antidetect conceput exact pentru astfel de probleme: fiecare cont primește un mediu de browser separat. Parametrii de la nivelul dispozitivului intră și ei în gestiune, iar vocea este unul dintre ei.
Ce este amprenta vocală? Ce o deosebește de recunoașterea vocii prin înregistrare
Materia primei a amprentei vocale este configurația sintezei vocale; vocea înregistrată prin microfon este o cu totul altă poveste.
Desparte mai întâi trei noțiuni. Sinteza vocală este capacitatea browserului de a transforma text în sunet, tehnologia din spatele citirii cu voce tare a paginilor. Lista de voci este oferta de voci de care această funcție dispune în mediul curent. Conform documentației MDN, un apel getVoices() returnează lista obiectelor de voce disponibile pe dispozitiv. Amprenta vocală, la rândul ei, înseamnă că site-ul folosește trăsături din această listă ca semnal de identificare a mediului. De la o noțiune la alta, totul devine mai concret.
Pune-o lângă recunoașterea vocală și diferența sare imediat în ochi. O amprentă a vocii reale cere înregistrare, acord de utilizare și un sunet produs efectiv. Amprenta vocală rămâne silentioasă pe tot parcursul și nu cere nicio permisiune. Site-ul primește un meniu, nu un sunet. Aici stă diferența, și tot aici motivul pentru care trece neobservată: fără nicio fereastră care să ceară acordul, fără să simți nimic, datele au plecat deja.
Cum predă SpeechSynthesis lista de voci site-urilor?
Site-ul citește lista prin speechSynthesis.getVoices(): o singură apelare și inventarul complet e pe masă.
Fiecare obiect de voce poartă cinci câmpuri. Iată ce înseamnă:
| Câmp | Semnificație | Exemple de valori uzuale |
|---|---|---|
| name | numele vocii | Microsoft David, Samantha |
| lang | eticheta de limbă | en-US, zh-CN |
| localService | sinteză locală sau serviciu în cloud | true pentru local, false pentru online |
| default | voce implicită sau nu | cel mult una pe limbă |
| voiceURI | identificatorul serviciului de voce | poate conține coduri interne de sistem |
Numele e adesea doar un simplu nume de om; informația de fundal stă în voiceURI. De pildă, Firefox pe macOS returnează valori de forma urn:moz-tts:osx: urmate de un cod intern al sistemului. Astfel, înregistrarea privată a vocilor sistemului iese afară printr-o interfață publică.
Încă un detaliu influențează citirea. În Chrome, Edge și Firefox, prima apelare returnează des un array gol; lista se completează abia după declanșarea evenimentului voiceschanged. Chiar și momentul încărcării e un semnal: un browser declanșează imediat, altul cu întârziere, iar unul care a terminat încărcarea nu mai declanșează deloc. În specificația Web Speech API partea aceasta se află încă în stadiul de schiță; pentru detalii contează implementarea fiecărui browser.
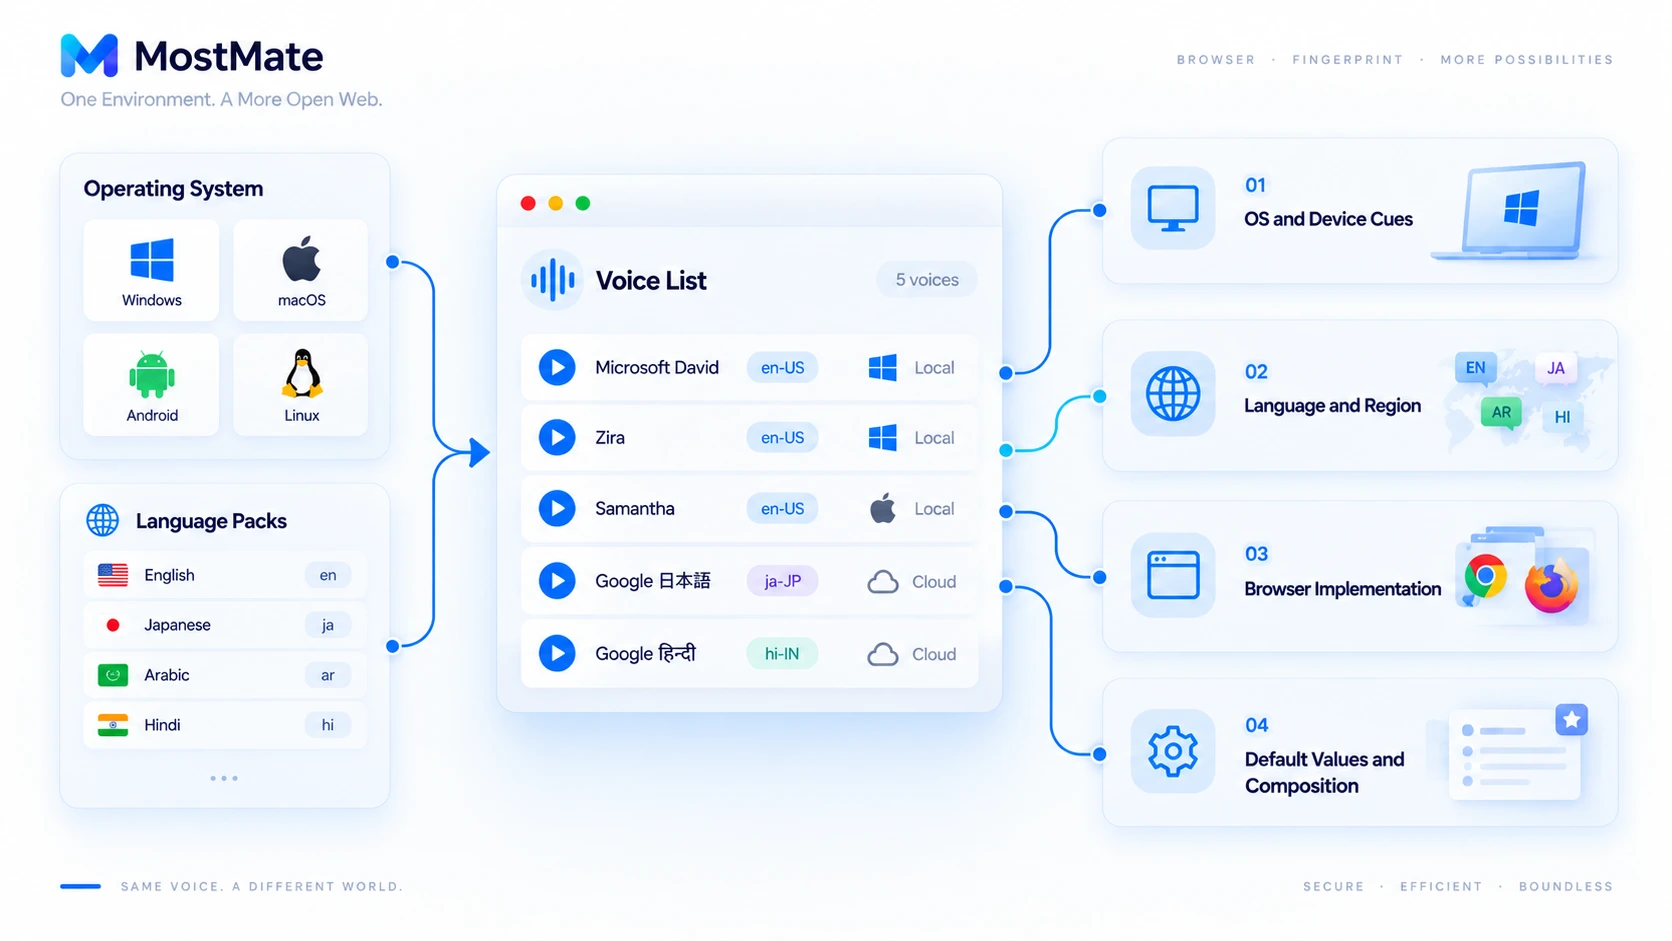
Care sunt cele patru tipuri de caracteristici de mediu expuse de lista de voci?
Un nume de voce nu spune nimic; diferența stă în compoziția listei.
Tipul întâi: sistemul de operare și dispozitivul. Vocile vin din serviciul de voce al sistemului. Pe Windows apar nume ca Microsoft David sau Zira, pe macOS Samantha și Daniel, pe Android primești setul Google. Un desktop Linux fără serviciu de voce afișează adesea o listă goală.
Tipul al doilea: limbă și regiune. Combinația de etichete lang trădează ce pachete de limbă sunt instalate pe calculator. O listă cu voci japoneze, arabe și hindi la un loc îi spune site-ului că aici lucrează cineva multilingv, lucru de care nici utilizatorul nu-și mai amintește.
Tipul al treilea: diferențe între browsere. Chrome suprapune peste vocile sistemului și vocile din cloud ale Google. După localService îți dai seama dacă o voce e sintetizată local sau trece prin internet. Același calculator poate returna în Chrome și Firefox liste cu compoziție diferită.
Tipul al patrulea: valorile implicite și ansamblul. Numărul, ordinea, etichetele de limbă și vocea implicită formează împreună un semnal de mediu destul de discriminatoriu. O precizare la graniță: e doar un indiciu; site-ul trage concluzii abia când combină mai multe tipuri de semnale. Dintr-o listă de voci nu reiese o persoană anume.
Ce diferență este între amprenta vocală și amprentele AudioContext și Canvas?
Le pomenim des la un loc, dar fiecare se uită la altceva. Mai întâi comparația:
| Metodă de detectare | Ce se observă | Cum decurge |
|---|---|---|
| Amprenta vocală SpeechSynthesis | lista de voci disponibile și câmpurile ei | citire de listă, complet fără sunet |
| Amprenta AudioContext | rezultatul calculelor audio | calcul executat și ieșiri comparate |
| Amprenta Canvas | trăsăturile randării grafice | imagine randată și pixeli comparați |
| Amprenta fonturilor | fonturile instalate și randarea lor | testarea disponibilității fonturilor |
Citirea listei de voci și randarea audio sunt două drumuri diferite: unul citește un inventar static, celălalt calculează un rezultat dinamic. Nu le amesteca. Cum funcționează al doilea drum și ce setări are, scrie în articolul despre amprenta AudioContext. Amprentarea fonturilor aparține, la fel ca lista de voci, categoriei inventarelor statice: ambele citesc direct ce e instalat pe dispozitiv.
Cum verifici ce informații vocale expune browserul tău?
Ajung instrumentele pentru dezvoltatori; în cinci minute ai exact lista pe care o vede și site-ul.
- Deschide Console din instrumentele pentru dezvoltatori, tastează speechSynthesis.getVoices() și apasă Enter: uită-te ce revine.
- Desfă obiectele de voce din listă și notează valorile pentru name, lang, localService și voiceURI.
- Reîmprospătează pagina și verifică imediat din nou dacă prima apelare returnează un array gol; așa confirmi încărcarea asincronă.
- Repetă pașii pe alt calculator sau alt sistem de operare și vezi dacă diferența vine din serviciul de voce al sistemului sau din implementarea browserului.
- Pune un proxy și verifică încă o dată: lista rămâne de regulă neschimbată, ceea ce confirmă exact că e vorba de un semnal la nivel de dispozitiv.
La interpretarea rezultatelor contează două nuanțe. O listă goală nu înseamnă că nu există amprentă vocală: goliciunea este, la rândul ei, un semnal. Linux-ul fără serviciu de voce și o parte din sistemele de automatizare returnează des un array gol. Și o listă lungă nu te face mai ușor de recunoscut. Evaluarea privește dacă mediul, în ansamblu, e coerent, nu numărul parametrilor luați separat.
Cum gestionează MostMate caracteristicile vocale ale mediului?
Lista de voci e un parametru de la nivelul dispozitivului; un browser antidetect îl include în configurația mediului, nu îl lasă la voia întâmplării.
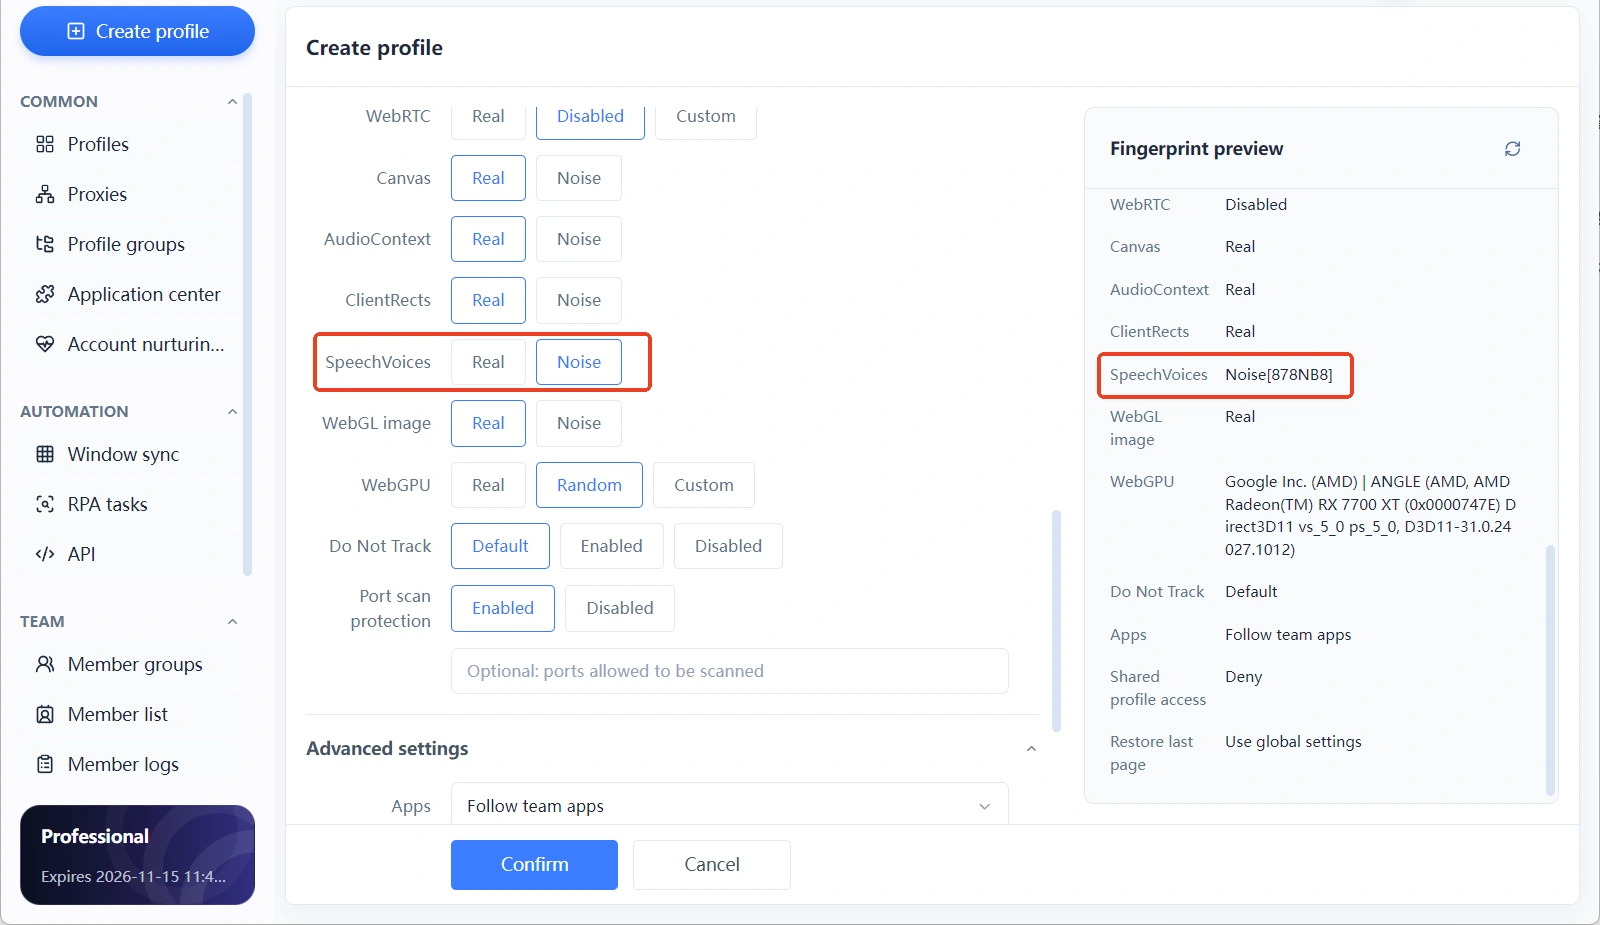
Când creezi sau editezi un mediu în MostMate, în setările de amprentă (fingerprint) apare un parametru separat, SpeechVoices, alături de Canvas, AudioContext, ClientRects și imaginile WebGL. Sunt două moduri: Real și Noise, Noise fiind modul de zgomot.
Alegi Noise, iar în panoul de previzualizare a amprentei, la SpeechVoices, apare o valoare cu un cod de șase caractere. Canvas și AudioContext au fiecare codurile lor, care nu se interschimbă. Codul identifică configurația de zgomot; ce hash se expune în realitate vezi doar deschizând mediul și intrând pe pagina de test de detectare.
Vocea nu se reglează izolat. Sistemul de operare, limba și fusul orar ale unui mediu decid cum trebuie să arate lista de voci. Un mediu Windows cu un set de voci macOS este o contradicție evidentă. Ordinea recomandată: stabilești mai întâi sistemul și proxy-ul, apoi verifici parametrii de la nivelul dispozitivului, printre care și vocea. E mai sigur decât încercările dezordonate, o setare după alta.
Dacă vrei control pe fiecare element, urmezi lista din setarea manuală a amprentei de pe site. Dacă vrei să câștigi timp, la crearea mediului alegi configurația recomandată, care include din start acești parametri, apoi reverifici doar punctele aparte. Și aici există o limită: un browser antidetect gestionează configurația mediului, dar nu poate garanta că un site nu recunoaște mediul și nici că un cont nu declanșează vreodată o verificare a platformei. Regulile platformei rămân de respectat pentru contul propriu-zis.
Întrebări frecvente
Înregistrează amprenta vocală vocea mea?
Nu. Întreaga citire nu atinge microfonul și nu redă niciun sunet. Site-ul primește doar configurația serviciului de voce al sistemului. Recunoașterea vocală cere acord pentru înregistrare; amprenta vocală nu cere nicio permisiune.
De ce diferă lista de voci pe două calculatoare?
Vocile sunt stabilite de sistemul de operare, de pachetele de limbă și de serviciul de voce. Windows și macOS au voci încorporate diferite, pachetele de limbă instalate nu coincid, iar fiecare browser își adaugă vocile din cloud. Normal ca listele să nu se potrivească.
Înseamnă o listă goală că nu există amprentă vocală?
O listă goală e, la rândul ei, un semnal. Linux-ul fără serviciu de voce și o parte din sistemele de automatizare returnează adesea un array gol. Pentru un site, asta e o trăsătură anormală. Nu o trata ca pe o invizibilitate.
Amprenta vocală și amprenta AudioContext sunt același lucru?
Nu sunt din aceeași familie. Amprenta vocală citește un inventar static de configurare; AudioContext calculează un rezultat audio dinamic. Traseele de detectare diferă, deci la verificarea mediului le controlezi separat.
Poate MostMate să modifice separat lista de voci SpeechSynthesis?
În produs îi corespunde parametrul SpeechVoices din setările de amprentă, cu modurile Real și Noise. Cât de fin poți regla depinde de interfața clientului. După configurare, deschide mediul, intră pe pagina de test de detectare și verifică lista care se expune efectiv.
Încheiere
Esențialul amprentei vocale: dispozitivul îi spune site-ului ce are instalat. Nu înregistrează, nu cere permisiune, și totuși merge odată cu sistemul de operare. IP-ul se schimbă, ea rămâne. De aceea capătă sens atâtea practici obișnuite: cine doar șterge cookie-urile sau doar schimbă proxy-ul trebuie să alinieze și parametrii de la nivelul dispozitivului, ca mediul să se potrivească.
Din partea produsului, MostMate pune SpeechVoices alături de Canvas și AudioContext în setările de amprentă, cu modurile Real și Noise. Restul funcțiilor le poți parcurge singur pe site-ul MostMate.
Vrei să vezi ce expune mediul tău chiar acum? Parcurge lista de voci după pașii din secțiunea a cincea sau descarcă MostMate, creează un mediu și compară.

MOSTMATE
Gestionare sigură a mai multor conturi, fără complicații
Începe cu primul cont și folosește MostMate pentru operațiuni mai sigure, inteligente și eficiente cu mai multe conturi.
- Profiluri independente. Identități coerente.
- Automatizare AI · Starea conturilor · Operațiuni în echipă



