
ลายนิ้วมือเสียงพูดในเบราว์เซอร์คืออะไร SpeechSynthesis เปิดเผยอะไรได้บ้าง
ใจความหลัก: ลายนิ้วมือเสียงพูดอ่านจากเสียงสังเคราะห์ที่ติดตั้งอยู่บนเครื่อง เป็นรายการตั้งค่าที่เดินตามระบบปฏิบัติการ เปลี่ยนพร็อกซีหรือล้าง Cookie เท่าไรก็ไม่เปลี่ยน ตอนตรวจความสอดคล้องของสัญญาณในสภาพแวดล้อมหลายบัญชี นี่คือรายการที่พลาดง่ายที่สุดหลังจาก Canvas และ AudioContext
เปลี่ยนพร็อกซีก็แล้ว ล้าง Cookie ก็แล้ว ทำไมผลตรวจสภาพแวดล้อมยังไม่ตรงกันอยู่ดี เวลาไล่ตรวจบัญชี คำตอบมักซ่อนอยู่ในพารามิเตอร์ระดับอุปกรณ์ และเสียงพูดเป็นหนึ่งในจุดที่มองข้ามง่ายที่สุด เว็บไซต์ไม่ต้องขอเข้าถึงไมโครโฟน ไม่ต้องเปิดเสียงใดๆ เลย เรียก API เพียงครั้งเดียวก็จะได้รายการที่ผูกกับการตั้งค่าระบบมาแล้ว
รายการนี้ถูกกำหนดด้วยระบบปฏิบัติการกับชุดภาษา และเดินตามเครื่องไปเสมอ สลับ IP ไปมันก็ไม่ขยับ MostMate คือเบราว์เซอร์ anti-detect ที่ออกแบบมารับมือปัญหาแบบนี้โดยเฉพาะ จัดสภาพแวดล้อมเบราว์เซอร์แยกต่างหากให้แต่ละบัญชี พารามิเตอร์ระดับอุปกรณ์ก็อยู่ในวงจัดการด้วย เสียงพูดเป็นหนึ่งในนั้น
ลายนิ้วมือเสียงพูดคืออะไร ต่างจากการรู้จำลายเสียงอย่างไร
ลายนิ้วมือเสียงพูดมาจากค่าตั้งค่าเสียงสังเคราะห์ ไม่ใช่เสียงอัด
แยกสามคำนี้ออกจากกันก่อน การสังเคราะห์เสียงพูดคือความสามารถของเบราว์เซอร์ในการแปลงข้อความเป็นเสียง ก็คือระบบที่อยู่เบื้องหลังฟังก์ชันอ่านออกเสียงในหน้าเว็บนั่นเอง รายการเสียงคือชุดตัวเลือกเสียงที่ระบบนี้ใช้ได้ในสภาพแวดล้อมปัจจุบัน ตามคำอธิบายในเอกสาร MDN การเรียก getVoices() จะคืนรายการออบเจ็กต์เสียงที่ใช้ได้บนอุปกรณ์ ส่วนลายนิ้วมือเสียงพูดหมายถึงการที่เว็บไซต์เอาลักษณะในรายการนี้ไปใช้เป็นสัญญาณชี้ตัวสภาพแวดล้อมหนึ่ง ทั้งสามค่อยๆ จำเพาะขึ้นทีละชั้น
เทียบกับการรู้จำลายเสียงแล้วความต่างชัดเจน ลายเสียงต้องอัดเสียง ต้องขออนุญาต ต้องมีเสียงดังจริง ลายนิ้วมือเสียงพูดเงียบสนิทตลอดกระบวนการและไม่ต้องขอสิทธิ์ใดๆ สิ่งที่เว็บไซต์ได้คือเมนู ไม่ใช่เสียง จุดต่างอยู่ตรงนี้ และเป็นเหตุผลที่มันถูกมองข้ามด้วย ไม่มีป๊อปอัป ไม่มีความรู้สึกอะไร แต่ข้อมูลก็ส่งออกไปแล้ว
SpeechSynthesis ส่งรายการเสียงให้เว็บไซต์อย่างไร
ช่องทางอ่านของเว็บไซต์คือ speechSynthesis.getVoices() เรียกครั้งเดียวก็ได้รายการครบทั้งชุด
ออบเจ็กต์เสียงแต่ละตัวมีห้าฟิลด์ ความหมายดูตามตาราง
| ฟิลด์ | ความหมาย | ตัวอย่างค่าที่พบบ่อย |
|---|---|---|
| name | ชื่อของเสียง | Microsoft David, Samantha |
| lang | ป้ายกำกับภาษา | en-US, zh-CN |
| localService | สังเคราะห์ในเครื่องหรือบริการคลาวด์ | true คือในเครื่อง false คือออนไลน์ |
| default | เป็นเสียงเริ่มต้นหรือไม่ | แต่ละภาษามีได้มากที่สุดหนึ่งตัว |
| voiceURI | ที่อยู่ระบุตัวของบริการเสียง | อาจมีรหัสภายในของระบบ |
ชื่อมักเป็นแค่ชื่อคนคนหนึ่ง voiceURI ต่างหากที่พกข้อมูลชั้นล่างมาด้วย ยกตัวอย่างค่าที่ Firefox บน macOS คืนมา จะออกแนว urn:moz-tts:osx: ต่อท้ายด้วยรหัสภายในของระบบ ข้อมูลลงทะเบียนเสียงส่วนที่เป็นส่วนตัวของระบบก็ถูกส่งออกไปทางอินเทอร์เฟซสาธารณะแบบนั้นเอง
มีรายละเอียดอีกจุดหนึ่งที่กระทบผลการอ่าน ใน Chrome, Edge และ Firefox การเรียกครั้งแรกมักคืนอาร์เรย์ว่าง เสียงจะเต็มเมื่อเหตุการณ์ voiceschanged ถูกทริกเกอร์แล้วเท่านั้น ตัวจังหวะการโหลดก็เป็นสัญญาณอีกอย่าง บางเบราว์เซอร์ทริกเกอร์ทันที บางตัวชักช้า บางตัวโหลดเสร็จแล้วก็ไม่ทริกเกอร์อีก อินเทอร์เฟซนี้ในข้อกำหนด Web Speech API ยังอยู่ในสถานะร่างจนถึงทุกวันนี้ รายละเอียดพฤติกรรมให้ยึดตามการเอาไปใช้ของแต่ละเบราว์เซอร์
รายการเสียงเปิดเผยลักษณะสภาพแวดล้อมได้สี่กลุ่มอะไรบ้าง
ชื่อเสียงเดี่ยวหนึ่งตัวไม่บอกอะไร จุดที่มีน้ำหนักคือวิธีที่รายการถูกประกอบกัน
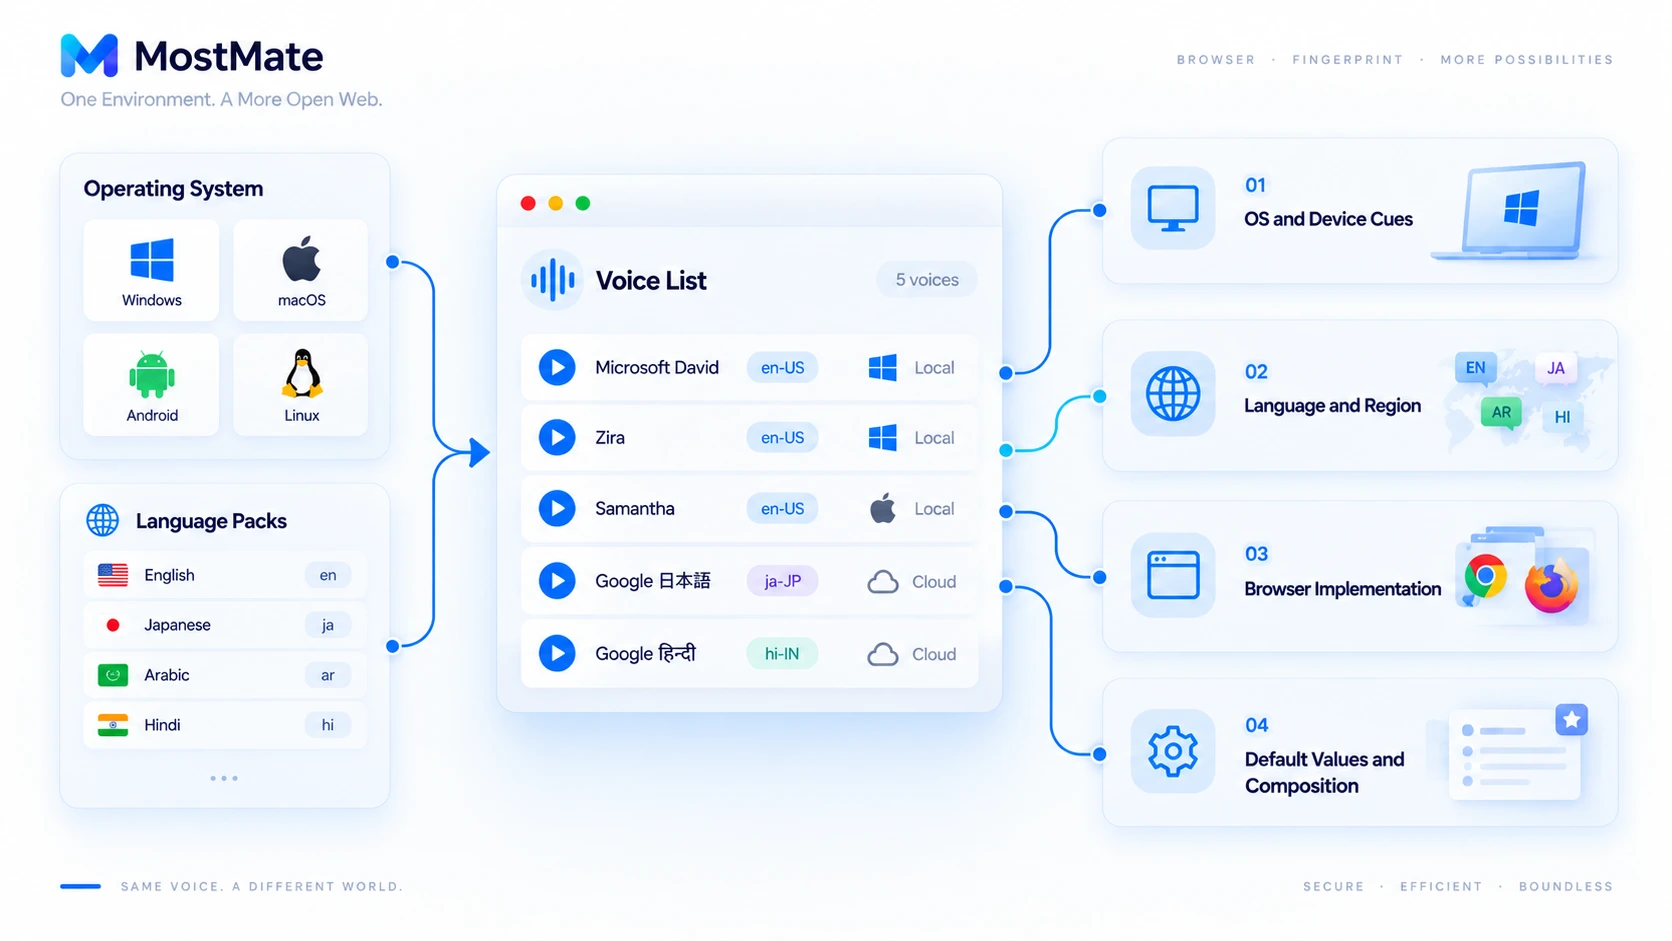
กลุ่มที่หนึ่ง: ร่องรอยระบบปฏิบัติการและอุปกรณ์ เสียงมาจากบริการเสียงของระบบ บน Windows มักเจอชื่ออย่าง Microsoft David, Zira บน macOS มักเจอ Samantha, Daniel โทรศัพท์ Android มีชุดเสียงของ Google ส่วนเดสก์ท็อป Linux ที่ไม่ได้ติดตั้งบริการเสียง รายการมักว่างเปล่า
กลุ่มที่สอง: การตั้งค่าภาษาและภูมิภาค การประกอบกันของป้าย lang สะท้อนว่าเครื่องนี้เคยลงภาษาอะไรไว้บ้าง รายการที่มีทั้งเสียงญี่ปุ่น อาหรับ และฮินดี ในหน้าเดียว เท่ากับแจ้งพื้นหลังการใช้หลายภาษาให้เว็บไซต์ฟัง บางทีตัวผู้ใช้เองยังจำไม่ได้เลย
กลุ่มที่สาม: ความต่างของการเอาไปใช้ในแต่ละเบราว์เซอร์ Chrome จะวางเสียงคลาวด์ของ Google ซ้อนทับเสียงของระบบ ฟิลด์ localService ช่วยแยกการสังเคราะห์ในเครื่องกับบริการออนไลน์ เครื่องเดียวกัน Chrome กับ Firefox ก็อาจคืนรายการที่องค์ประกอบไม่เหมือนกัน
กลุ่มที่สี่: ค่าเริ่มต้นกับการประกอบรวมทั้งชุด จำนวน ลำดับ ป้ายภาษา และเสียงเริ่มต้น ต่อกันเป็นสัญญาณสภาพแวดล้อมที่มีความจำเพาะค่อนข้างสูง ขอเติมเรื่องขอบเขตสักหน่อย มันเป็นเพียงสัญญาณหนึ่งในหลายสัญญาณ เว็บไซต์ต้องถ่วงน้ำหนักหลายกลุ่มร่วมกันจึงจะสรุปได้ รายการเสียงชุดเดียวจำตัวบุคคลไม่ได้
ลายนิ้วมือเสียงพูดต่างจากลายนิ้วมือ AudioContext และ Canvas อย่างไร
ทั้งสามถูกพูดถึงร่วมกันบ่อย แต่สิ่งที่มองต่างกันสนิท ลองดูตารางเทียบก่อน
| วิธีตรวจจับ | สิ่งที่มอง | ลักษณะกระบวนการ |
|---|---|---|
| ลายนิ้วมือเสียงพูด SpeechSynthesis | รายการเสียงที่ใช้ได้และฟิลด์ต่างๆ | อ่านรายการตั้งค่า เงียบตลอดกระบวนการ |
| ลายนิ้วมือ AudioContext | ผลจากการคำนวณประมวลผลเสียง | คำนวณจริง แล้วเทียบความต่างของผลลัพธ์ |
| ลายนิ้วมือ Canvas | ลักษณะของผลการวาดกราฟิก | เรนเดอร์ภาพ แล้วเทียบพิกเซล |
| ลายนิ้วมือฟอนต์ | ฟอนต์ที่ติดตั้งในระบบและการเรนเดอร์ | สำรวจว่าฟอนต์ใช้ได้หรือไม่ |
การนับรายการเสียงกับการเรนเดอร์เสียงเป็นสองเส้นทางที่ต่างกัน อันหนึ่งอ่านรายการนิ่งๆ อีกอันคำนวณผลแบบไดนามิก ห้ามเอามาปนกัน เรื่องลายนิ้วมือ AudioContext เขียนถึงหลักการและการตั้งค่าของเส้นทางหลัง ส่วนลายนิ้วมือฟอนต์ อยู่ตระกูลเดียวกับรายการเสียง คือการอ่านโดยตรงว่าเครื่องติดตั้งอะไรไว้
จะตรวจดูว่าเบราว์เซอร์เปิดเผยข้อมูลเสียงอะไรไปบ้างได้อย่างไร
ตรวจได้ด้วยเครื่องมือนักพัฒนาอย่างเดียว ห้านาทีก็ได้รายการชุดเดียวกับที่เว็บไซต์เห็น
- เปิด Console ในเครื่องมือนักพัฒนา พิมพ์ speechSynthesis.getVoices() แล้วกด Enter ดูผลที่คืนมา
- กางออบเจ็กต์เสียงในรายการ จดค่า name, lang, localService, voiceURI ไว้
- รีเฟรชหน้าแล้วเรียกซ้ำทันที เทียบว่าครั้งแรกว่างหรือไม่ เพื่อยืนยันพฤติกรรมการโหลดแบบอะซิงโครนัส
- ลองซ้ำบนเครื่องอื่นหรือระบบอื่น ดูว่าความต่างมาจากบริการเสียงของระบบหรือตัวเบราว์เซอร์
- ต่อพร็อกซีแล้วเช็กอีกรอบ รายการมักไม่เปลี่ยน ซึ่งยืนยันได้ว่ามันเป็นสัญญาณระดับอุปกรณ์
อ่านผลต้องกันสองเรื่อง รายการว่างไม่ได้แปลว่าไม่มีลายนิ้วมือเสียงพูด ตัวความว่างเองก็เป็นข้อมูลหนึ่ง Linux ที่ไม่มีบริการเสียงกับสภาพแวดล้อมอัตโนมัติบางแบบมักคืนอาร์เรย์ว่าง รายการยาวก็ไม่ได้แปลว่าถูกจำได้ง่ายขึ้น เกณฑ์ตัดสินคือสภาพแวดล้อมโดยรวมเข้ากันได้หรือไม่ ไม่ใช่นับจำนวนพารามิเตอร์เดี่ยวๆ
MostMate จัดการลักษณะเสียงของสภาพแวดล้อมอย่างไร
รายการเสียงเป็นพารามิเตอร์ระดับอุปกรณ์ เบราว์เซอร์ anti-detect จัดการมันโดยหยิบเข้าไว้ในค่าตั้งค่าสภาพแวดล้อม ไม่ใช่ปล่อยปละละเลย
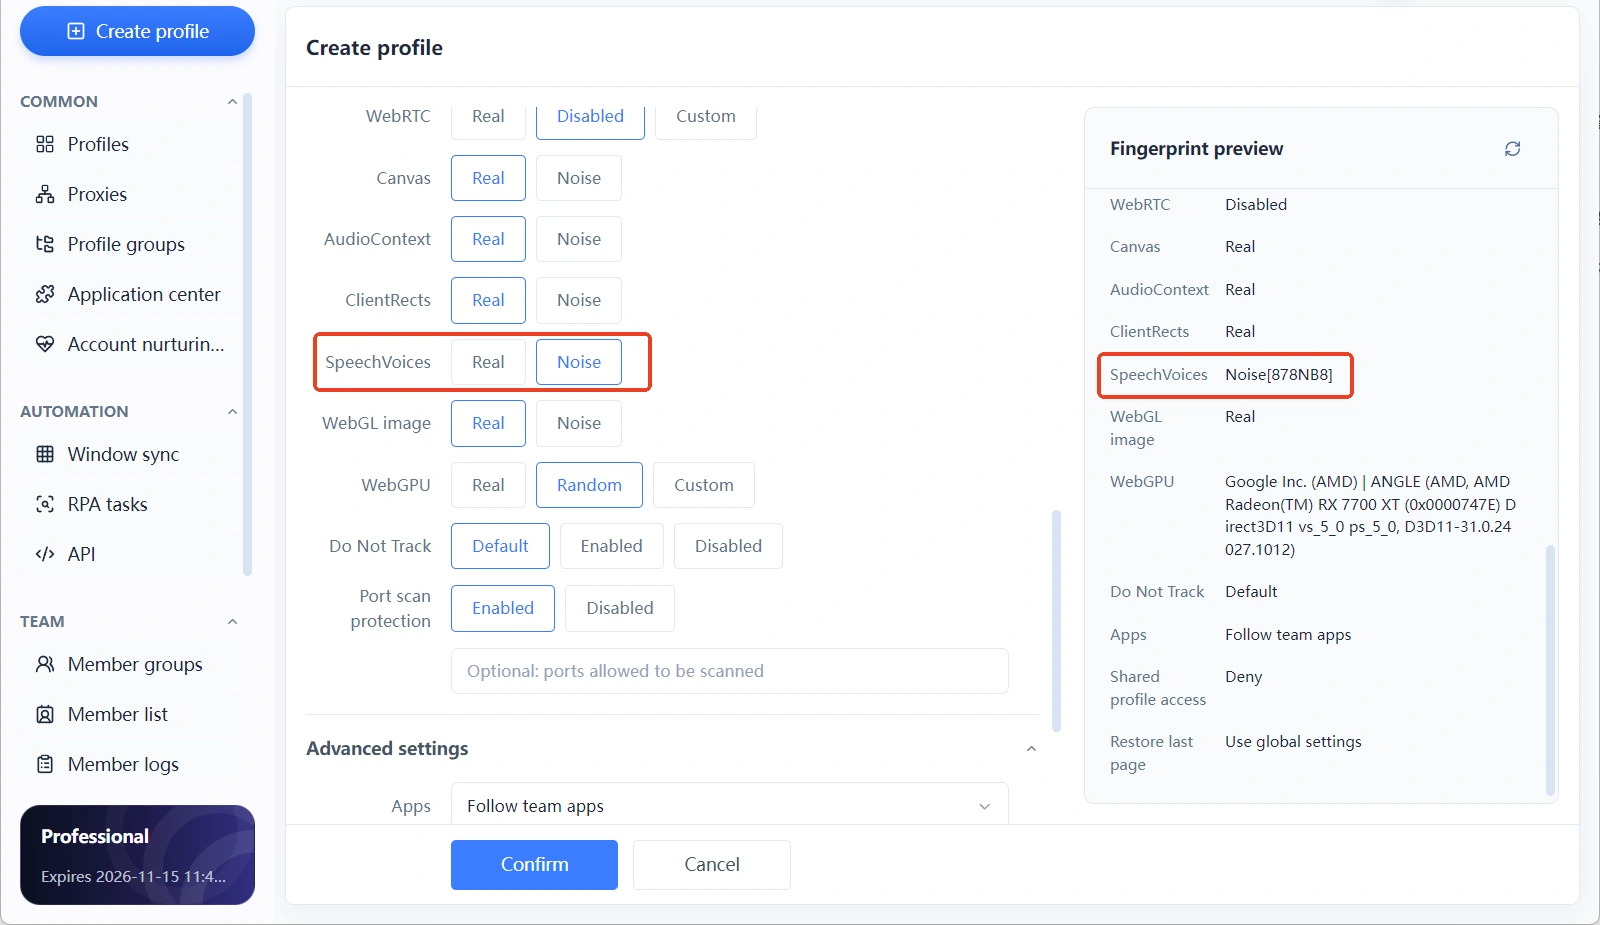
ใน MostMate ตอนสร้างหรือแก้ไขสภาพแวดล้อม ในหมวดการตั้งค่าลายนิ้วมือ (指纹设置) พารามิเตอร์ SpeechVoices อยู่เป็นรายการอิสระ คู่กับ Canvas, AudioContext, ClientRects และภาพ WebGL มีสองระดับคือ Real (ค่าจริง) กับ Noise (โหมดก่อกวน)
เลือก Noise แล้ว แถว SpeechVoices ในแผงพรีวิวลายนิ้วมือด้านขวาจะแสดงค่าที่มีรหัสหกหลักกำกับ Canvas กับ AudioContext มีรหัสเป็นของตัวเอง ไม่ใช้ร่วมกัน รหัสเป็นแค่ตัวระบุค่าคอนฟิกแบบก่อกวน ค่าแฮชที่เปิดเผยจริงต้องเปิดสภาพแวดล้อมแล้วเข้าหน้าตรวจสอบเพื่อดู
พารามิเตอร์เรื่องเสียงไม่ควรปรับแยกเดี่ยวๆ ระบบปฏิบัติการ ภาษา และเขตเวลาของสภาพแวดล้อมเป็นตัวกำหนดว่ารายการเสียงควรหน้าตาอย่างไร สภาพแวดล้อม Windows แต่ได้ชุดเสียง macOS ออกมา ถือเป็นความขัดแย้งที่เห็นกันตาเปล่า ลำดับที่แนะนำคือล็อกระบบกับพร็อกซีก่อน แล้วค่อยไล่ตรวจพารามิเตอร์ระดับอุปกรณ์อย่างเสียง วิธีนี้เชื่อถือได้กว่าลองผิดลองถูกทีละรายการ
ใครอยากคุมเป็นรายการ ให้ไล่ตามรายการในการตั้งค่าลายนิ้วมือด้วยตนเอง บนเว็บไซต์ ใครอยากประหยัดเวลาคอนฟิก ให้เลือกแพ็กค่าแนะนำตอนสร้างสภาพแวดล้อม แล้วค่อยมาทวนรายการที่ต้องการเป็นกรณีไป ต้องบอกขอบเขตไว้ด้วย เบราว์เซอร์ anti-detect จัดการก็คือค่าตั้งค่าสภาพแวดล้อม ไม่สามารถรับประกันว่าเว็บไซต์จะจำสภาพแวดล้อมไม่ได้ และไม่รับประกันว่าบัญชีจะไม่โดนแพลตฟอร์มตรวจ บัญชีเองก็ยังต้องทำตามกฎของแพลตฟอร์ม
คำถามที่พบบ่อย
ลายนิ้วมือเสียงพูดอัดเสียงของฉันหรือเปล่า
เปล่า กระบวนการทั้งหมดไม่แตะไมโครโฟนและไม่เปิดเสียง สิ่งที่เว็บได้มีแค่รายการค่าตั้งค่าของบริการเสียงในระบบ การรู้จำลายเสียงต้องขออนุญาตอัดเสียง แต่ลายนิ้วมือเสียงพูดไม่ต้องขอสิทธิ์ใดๆ
ทำไมสองเครื่องถึงมีรายการเสียงไม่เหมือนกัน
เสียงถูกกำหนดด้วยระบบปฏิบัติการ ชุดภาษา และบริการเสียง เสียงในตัวของ Windows กับ macOS ต่างกัน ภาษาที่เคยลงต่างกัน เสียงคลาวด์ที่เบราว์เซอร์ซ้อนทับก็ต่างกัน รายการเลยไม่ตรงกันตามคาด
รายการเสียงว่าง แปลว่าไม่มีลายนิ้วมือเสียงพูดใช่ไหม
รายการว่างเองก็เป็นข้อมูลหนึ่ง Linux ที่ไม่มีบริการเสียงกับสภาพแวดล้อมอัตโนมัติบางแบบมักคืนอาร์เรย์ว่าง สำหรับเว็บไซต์นี่คือลักษณะผิดปกติชนิดหนึ่ง อย่าเอาไปนับว่าเป็นการหลบซ่อน
ลายนิ้วมือเสียงพูดกับลายนิ้วมือ AudioContext คืออย่างเดียวกันหรือเปล่า
คนละพวกกัน ลายนิ้วมือเสียงพูดอ่านรายการค่าตั้งค่าที่นิ่ง ส่วน AudioContext คำนวณผลการประมวลผลเสียงแบบไดนามิก เส้นทางตรวจต่างกัน ตอนไล่ตรวจสภาพแวดล้อมให้เช็กแยกจากกัน
MostMate แก้รายการเสียง SpeechSynthesis แยกเดี่ยวได้ไหม
ในผลิตภัณฑ์ตรงกับพารามิเตอร์ SpeechVoices ในการตั้งค่าลายนิ้วมือ มีสองระดับคือ Real กับ Noise จะปรับละเอียดได้แค่ไหนให้ดูตามอินเทอร์เฟซของไคลเอนต์ หลังคอนฟิกแนะนำให้เปิดสภาพแวดล้อมเข้าหน้าตรวจสอบ เทียบดูรายการที่เปิดเผยจริง
บทสรุป
แก่นของลายนิ้วมือเสียงพูดคือการส่งรายการว่าเครื่องนี้ติดตั้งอะไรไว้ให้เว็บไซต์ ไม่อัดเสียง ไม่ขอสิทธิ์ แต่เดินตามระบบปฏิบัติการ สลับ IP มันก็ไม่ขยับ หลายวิธียอดฮิตเลยอธิบายได้ เอาแค่ล้าง Cookie เอาแค่เปลี่ยนพร็อกซี พอสภาพแวดล้อมไม่ตรงกัน พารามิเตอร์ระดับอุปกรณ์ต้องจัดให้ตรงกันด้วย
ฝั่งผลิตภัณฑ์ MostMate หยิบ SpeechVoices รวมกับ Canvas และ AudioContext ไว้ในการตั้งค่าลายนิ้วมือ ระดับควบคุมคือ Real กับ Noise อยากเห็นภาพรวมของฟีเจอร์อื่น ลองไปไล่ดูที่เว็บไซต์ MostMate ด้วยตัวเอง
อยากรู้ว่าสภาพแวดล้อมของคุณตอนนี้เปิดเผยอะไรอยู่ ไล่ตรวจรายการเสียงตามขั้นตอนในหัวข้อที่ห้า หรือดาวน์โหลด MostMate มาสร้างสภาพแวดล้อมหนึ่งเพื่อเทียบกันดู

MOSTMATE
จัดการหลายบัญชีอย่างปลอดภัยได้ง่ายกว่าเดิม
เริ่มจากบัญชีแรก แล้วใช้ MostMate สร้างการทำงานหลายบัญชีที่ปลอดภัย ฉลาด และมีประสิทธิภาพยิ่งขึ้น
- โปรไฟล์เป็นอิสระ ตัวตนสอดคล้องกัน
- ระบบอัตโนมัติด้วย AI · สุขภาพบัญชี · การดำเนินงานของทีม



