
浏览器语音指纹是什么?SpeechSynthesis 语音列表如何暴露环境特征
核心结论:语音指纹读的是设备上装了哪些合成语音,这是一份跟着操作系统走的配置清单,换代理、清 Cookie 都不会让它改变。排查多账号环境的信号一致性时,它是继 Canvas、AudioContext 之后容易被漏掉的一项。
「代理换了、Cookie 也清了,环境检测怎么还是对不上?」做账号排查时,答案经常藏在设备层的参数里。语音是其中最容易被忽略的一种。网站不需要访问麦克风,也不需要播放任何声音,只要调用一次接口,就能拿到一份与系统配置有关的清单。
这份清单由操作系统和语言包决定,跟着设备走。IP 换了,它也不动。MostMate 就是为这类问题设计的指纹浏览器,给每个账号准备一套独立的浏览器环境。设备层参数也在管理范围里,语音是其中一项。
语音指纹是什么?和录音识别声纹有什么区别
语音指纹的原料是语音合成功能的配置信息,与麦克风采集的声纹是两回事。
先把三个概念分开。语音合成指浏览器把文字转成语音的能力,也就是网页朗读功能背后的那套系统。语音列表指当前环境里可供这套功能使用的声音选项。按 MDN 文档的说明,调用 getVoices() 会返回设备上可用的语音对象列表。语音指纹则指网站把这份列表里的特征,当作识别环境的一类信号。三者一层比一层具体。
和声纹识别对比一下就清楚了。声纹要录音、要授权、要真的发出声音。语音指纹全程无声、无需授权。网站读到的是菜单,不是声音。差别就在这里,也是它容易被忽视的原因:没有弹窗、没有感知,数据已经交出去了。
SpeechSynthesis 怎么把语音列表交给网站?
网站的读取入口是 speechSynthesis.getVoices(),一次调用就能拿到完整清单。
每个语音对象带五个字段,含义看下表:
| 字段 | 含义 | 常见取值示例 |
|---|---|---|
| name | 语音名称 | Microsoft David、Samantha |
| lang | 语言标签 | en-US、zh-CN |
| localService | 本机合成还是云端服务 | true 为本机,false 为联网 |
| default | 是否为默认语音 | 每种语言至多一个 |
| voiceURI | 语音服务的标识地址 | 可能含系统内部标识 |
名称往往只是一个人名,voiceURI 才携带底层信息。以 Firefox 在 macOS 上的返回为例,取值形如 urn:moz-tts:osx: 加一串系统内部标识。系统私有的语音注册信息,就这样透过公开接口交了出去。
还有一处细节影响读取结果。Chrome、Edge、Firefox 里首次调用常返回空数组,语音要等 voiceschanged 事件触发后才填充完整。加载时机本身也是信号。有的浏览器立即触发,有的延迟,有的已经加载完就不再触发。这份接口在 Web Speech API 规范里至今仍处草案状态,行为细节以各浏览器实现为准。
语音列表会暴露哪四类环境特征?
单个语音名称说明不了什么,列表的组合方式才有区分度。
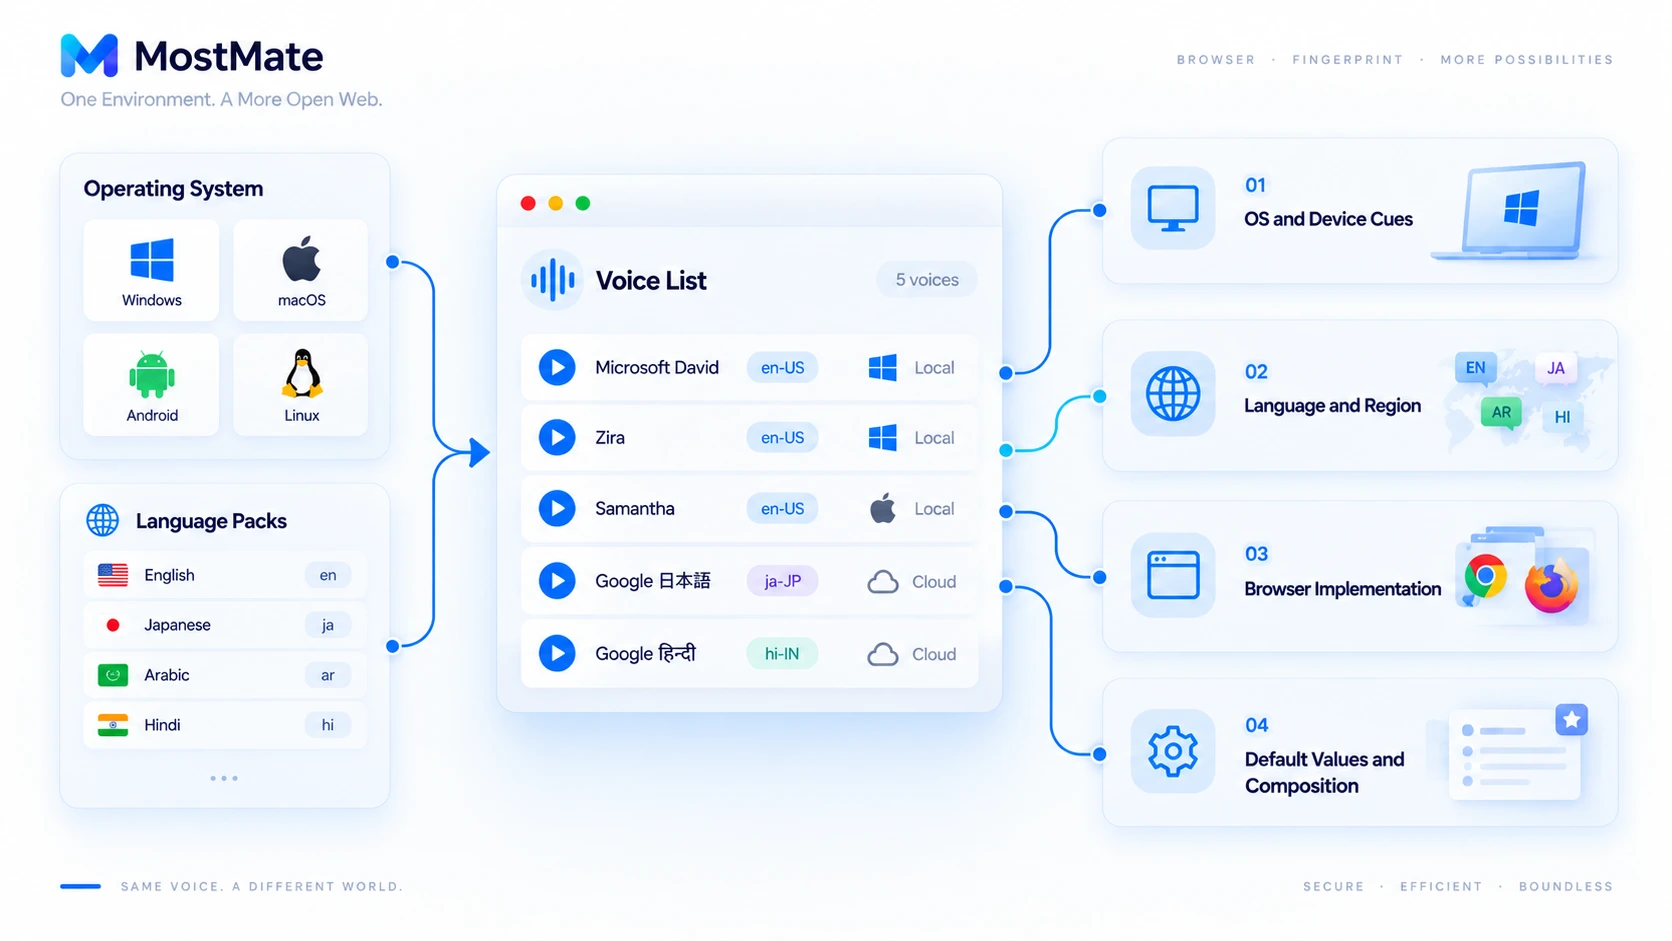
第一类:操作系统与设备线索。 语音由系统语音服务提供。Windows 上常见 Microsoft David、Zira 这类名字。macOS 上常见 Samantha、Daniel。Android 手机上是 Google 语音服务的一套。Linux 桌面如果没装语音服务,列表常常是空的。
第二类:语言与地区配置。 lang 标签的组合反映这台机器装过哪些语言包。一份同时带日语、阿拉伯语、印地语语音的列表,等于把多语言使用背景报给了网站。用户自己都未必记得。
第三类:浏览器实现差异。 Chrome 会在系统语音之上叠加 Google 的云端语音。localService 一项,能区分本机合成与联网服务。同一台机器,Chrome 和 Firefox 返回的列表构成可能不同。
第四类:默认值与整体组合。 数量、顺序、语言标签、默认语音拼在一起,构成区分度相当高的环境信号。再补一句边界。它只是线索之一,网站要综合多类信号才下结论。一份语音列表认不出具体的人。
语音指纹和 AudioContext、Canvas 指纹有什么区别?
三者经常被一起提起,但观察对象完全不同。先看对照:
| 检测方式 | 观察对象 | 过程特点 |
|---|---|---|
| SpeechSynthesis 语音指纹 | 可用语音列表及字段 | 读配置清单,全程无声 |
| AudioContext 指纹 | 音频处理运算的结果 | 执行运算,比对输出差异 |
| Canvas 指纹 | 图形绘制输出的特征 | 渲染图像,比对像素 |
| 字体指纹 | 系统安装的字体及渲染 | 探测字体可用性 |
语音列表枚举和音频渲染是两条路径。一个读静态清单,一个算动态结果。两者不能混为一谈。AudioContext 指纹那篇讲的是后一条路径的原理与设置。字体指纹则和语音列表同属静态清单一类,都是设备装了什么的直接读数。
怎么检查浏览器暴露了哪些语音信息?
检查只需要开发者工具,五分钟能拿到网站能看到的那份清单。
- 打开开发者工具的 Console,输入 speechSynthesis.getVoices() 并回车,看返回内容。
- 展开列表里的语音对象,记录 name、lang、localService、voiceURI 的取值。
- 刷新页面后立刻再查一次,对比首次是否为空数组,确认异步加载行为。
- 换一台电脑或另一个系统重复步骤,观察差异来自系统语音服务还是浏览器实现。
- 挂上代理再查一遍,列表通常不变,这正好验证它是设备层信号。
解读结果有两点分寸。列表为空不代表没有语音指纹,空本身也是一条信息。无语音服务的 Linux 和部分自动化环境,常返回空数组。列表长也不代表更容易被认出。判断要看整体环境是否自洽,而不是数单项参数的多少。
MostMate 怎么管理语音环境特征?
语音列表属于设备层参数,指纹浏览器对它的处理方式是纳入环境配置,而不是放任不管。
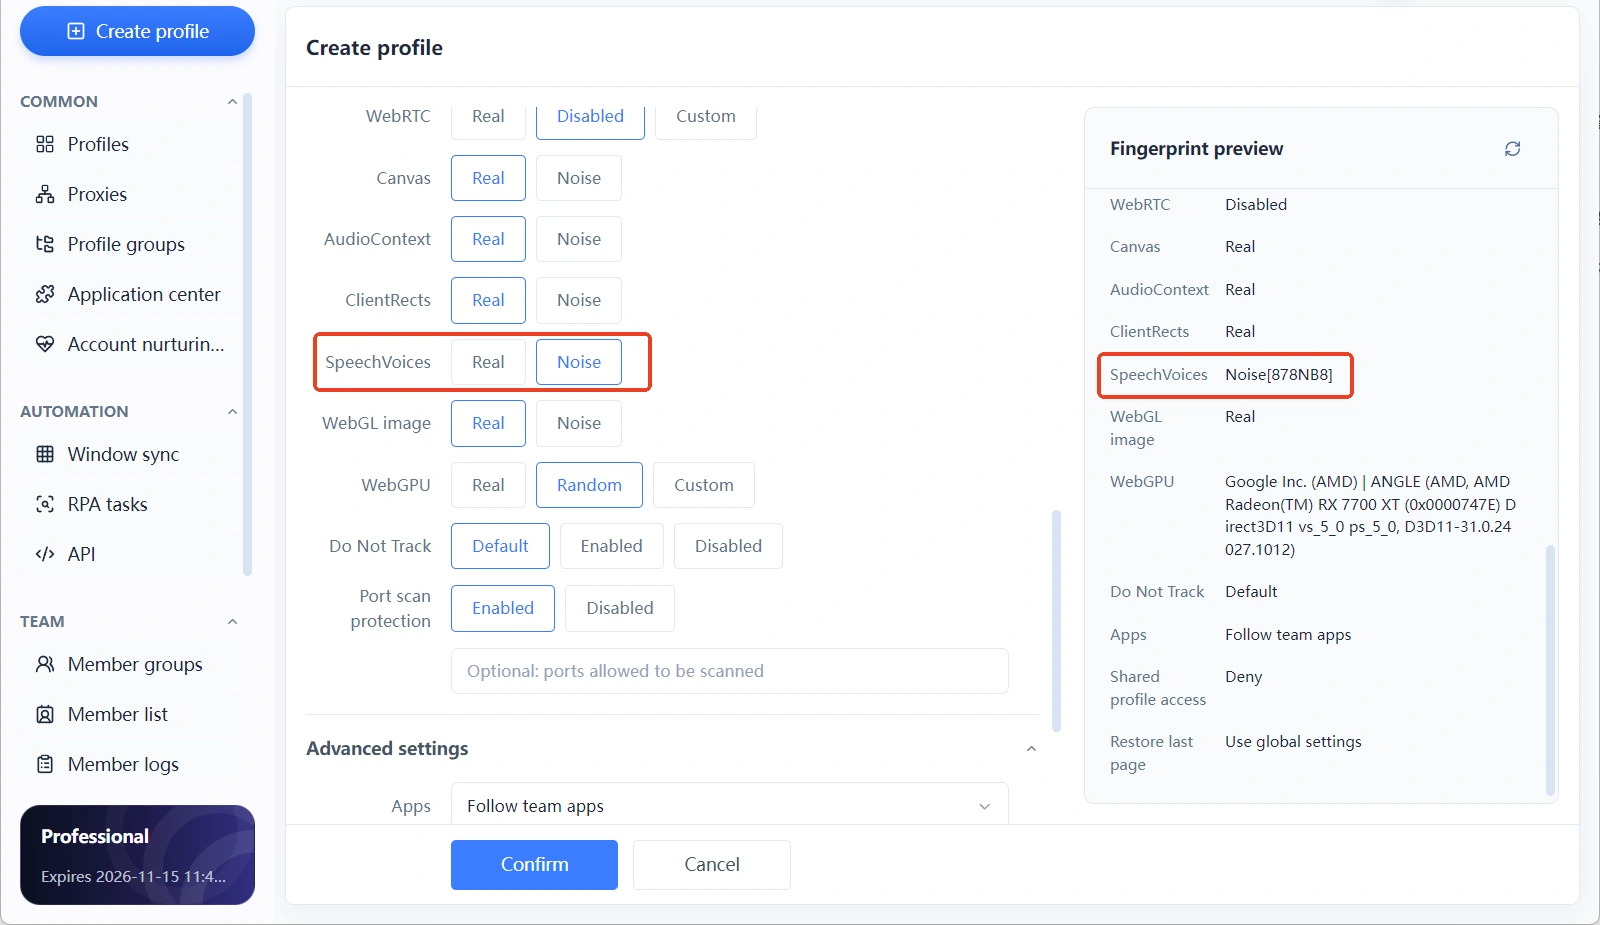
在 MostMate 创建或编辑环境的「指纹设置」里,SpeechVoices 是一项独立参数,与 Canvas、AudioContext、ClientRects、WebGL 图像并列。档位为 Real 与 Noise 两档,Noise 即噪音模式。
选 Noise 后,右侧指纹预览面板的 SpeechVoices 一栏会显示带六位代号的取值。Canvas、AudioContext 各有各的代号,互不通用。代号是噪音配置的标识,实际暴露的哈希值要打开环境访问检测页查看。
语音参数不孤立调。环境的操作系统、语言、时区决定了语音列表应该长什么样。Windows 环境配出一套 macOS 语音,就是明显矛盾。调整顺序建议先定系统与代理,再核对语音这类设备层参数。这比逐项乱试可靠。
需要逐项控制时,可以按官网手动指纹设置清单逐项调。想省配置时间,创建环境时用推荐配置封装这批参数,之后再针对个别项复核。也要说明边界。指纹浏览器管理的是环境配置,不能保证网站无法识别环境,也不能保证账号不触发平台验证。账号本身仍要遵守平台规则。
常见问题
语音指纹会录制我的声音吗?
不会。整个读取过程不碰麦克风、不播放音频。网站拿到的只是系统语音服务的配置清单。声纹识别需要录音授权,语音指纹不需要任何权限。
为什么两台电脑的语音列表不一样?
语音由操作系统、语言包和语音服务决定。Windows 与 macOS 的内置语音不同,装过的语言包不同,浏览器叠加的云端语音也不同。列表自然对不上。
语音列表为空,是不是就没有语音指纹?
空列表本身也是一条信息。没有语音服务的 Linux、部分自动化环境常返回空数组。对网站来说这是一种异常特征。不能当作隐身。
语音指纹和 AudioContext 指纹是一回事吗?
不是一类。语音指纹读静态的配置清单,AudioContext 算动态的音频处理结果。检测路径不同,排查环境时要分开核对。
MostMate 可以单独修改 SpeechSynthesis 语音列表吗?
产品里对应指纹设置的 SpeechVoices 参数,Real 与 Noise 两档,能调到什么粒度以客户端界面为准。配置后建议打开环境访问检测页,核对实际暴露的列表。
结语
语音指纹的本质,是把这台设备装了什么交给网站。它不录音、不要权限,却跟着操作系统走。IP 换了,它也不动。所以很多常见做法就讲得通了:只清 Cookie、只换代理,环境对不上时,设备层参数要一起对齐。
产品侧,MostMate 把 SpeechVoices 连同 Canvas、AudioContext 一并放进指纹设置。控制档位是 Real 与 Noise 两档。其他功能的全貌,可以到 MostMate 官网自己过一遍。
想看自己的环境现在暴露了什么,按第五节的步骤查一遍语音列表,也可以下载 MostMate建一个环境做对比。

MOSTMATE
让多账号安全管理更简单
从第一个账号开始,用 MostMate 建立更安全、更智能、更高效的多账号运营方式。
- 环境彼此独立,身份逻辑一致。
- AI 自动化 · 账号健康 · 团队运营



