
O que é a impressão digital de voz do navegador? Como a lista de vozes do SpeechSynthesis expõe o ambiente
Resumo: a impressão digital de voz revela quais vozes sintetizadas estão instaladas no dispositivo. É uma lista de configurações que acompanha o sistema operacional, e trocar de proxy ou limpar os cookies não a altera. Ao conferir a consistência de sinais em ambientes com várias contas, ela é um item fácil de esquecer depois de Canvas e AudioContext.
"Troquei o proxy, limpei os cookies e a verificação do ambiente ainda não bate. Por quê?" Ao investigar contas, a resposta costuma estar em parâmetros do nível do dispositivo, e a voz é um dos mais fáceis de ignorar. O site não precisa de acesso ao microfone nem precisa tocar nenhum som: basta uma chamada de API para obter uma lista ligada à configuração do sistema.
Essa lista depende do sistema operacional e dos pacotes de idioma e acompanha o aparelho. Troque o IP e ela continua igual. O MostMate é um navegador antidetectável feito justamente para esse tipo de problema: ele prepara um ambiente de navegador isolado para cada conta, e os parâmetros do nível do dispositivo, voz incluída, ficam sob gestão.
O que é impressão digital de voz? Qual a diferença para o reconhecimento de voz?
A impressão digital de voz nasce das configurações de síntese de fala; a impressão vocal captada pelo microfone é outra história.
Primeiro, separe três conceitos. Síntese de fala é a capacidade do navegador de transformar texto em áudio, a base do recurso de leitura em voz alta das páginas. A lista de vozes é o conjunto de opções de voz disponíveis para esse recurso no ambiente atual. Segundo a documentação do MDN, chamar getVoices() retorna a lista de objetos de voz disponíveis no dispositivo. A impressão digital de voz aparece quando o site usa as características dessa lista como mais um sinal para distinguir ambientes. Cada conceito é mais específico que o anterior.
O contraste com o reconhecimento de voz deixa tudo claro. A impressão vocal exige gravação, autorização e som de verdade. Aqui, nada de som do início ao fim e nenhuma permissão. O site lê um cardápio, não a sua voz. Está aí a diferença e também o motivo de passar despercebida: sem pop-up, sem aviso, e os dados já foram entregues.
Como o SpeechSynthesis entrega a lista de vozes ao site?
A porta de entrada é speechSynthesis.getVoices(): uma única chamada já devolve a lista completa.
Cada objeto de voz tem cinco campos, explicados na tabela abaixo:
| Campo | Significado | Exemplos comuns |
|---|---|---|
| name | Nome da voz | Microsoft David, Samantha |
| lang | Etiqueta de idioma | en-US, zh-CN |
| localService | Síntese local ou na nuvem | true local, false online |
| default | Voz padrão ou não | No máximo uma por idioma |
| voiceURI | Endereço do serviço de voz | Pode trazer IDs internos |
O nome costuma ser apenas um nome de pessoa; é no voiceURI que mora a informação de baixo nível. No Firefox no macOS, por exemplo, o valor tem a forma urn:moz-tts:osx: seguido de um identificador interno do sistema. Informações privadas de registro de vozes do sistema operacional saem por uma interface pública, simples assim.
Outro detalhe interfere no resultado. No Chrome, no Edge e no Firefox, a primeira chamada costuma devolver um array vazio, e a lista só se completa depois do evento voiceschanged. O momento do carregamento já é um sinal: uns navegadores disparam na hora, outros atrasam, e há os que não disparam mais quando a lista já veio pronta. Na especificação da Web Speech API essa interface segue em rascunho, então os detalhes de comportamento variam conforme a implementação de cada navegador.
Quais quatro tipos de características do ambiente a lista de vozes expõe?
Uma voz isolada não diz quase nada; o que diferencia é a forma como a lista se compõe.
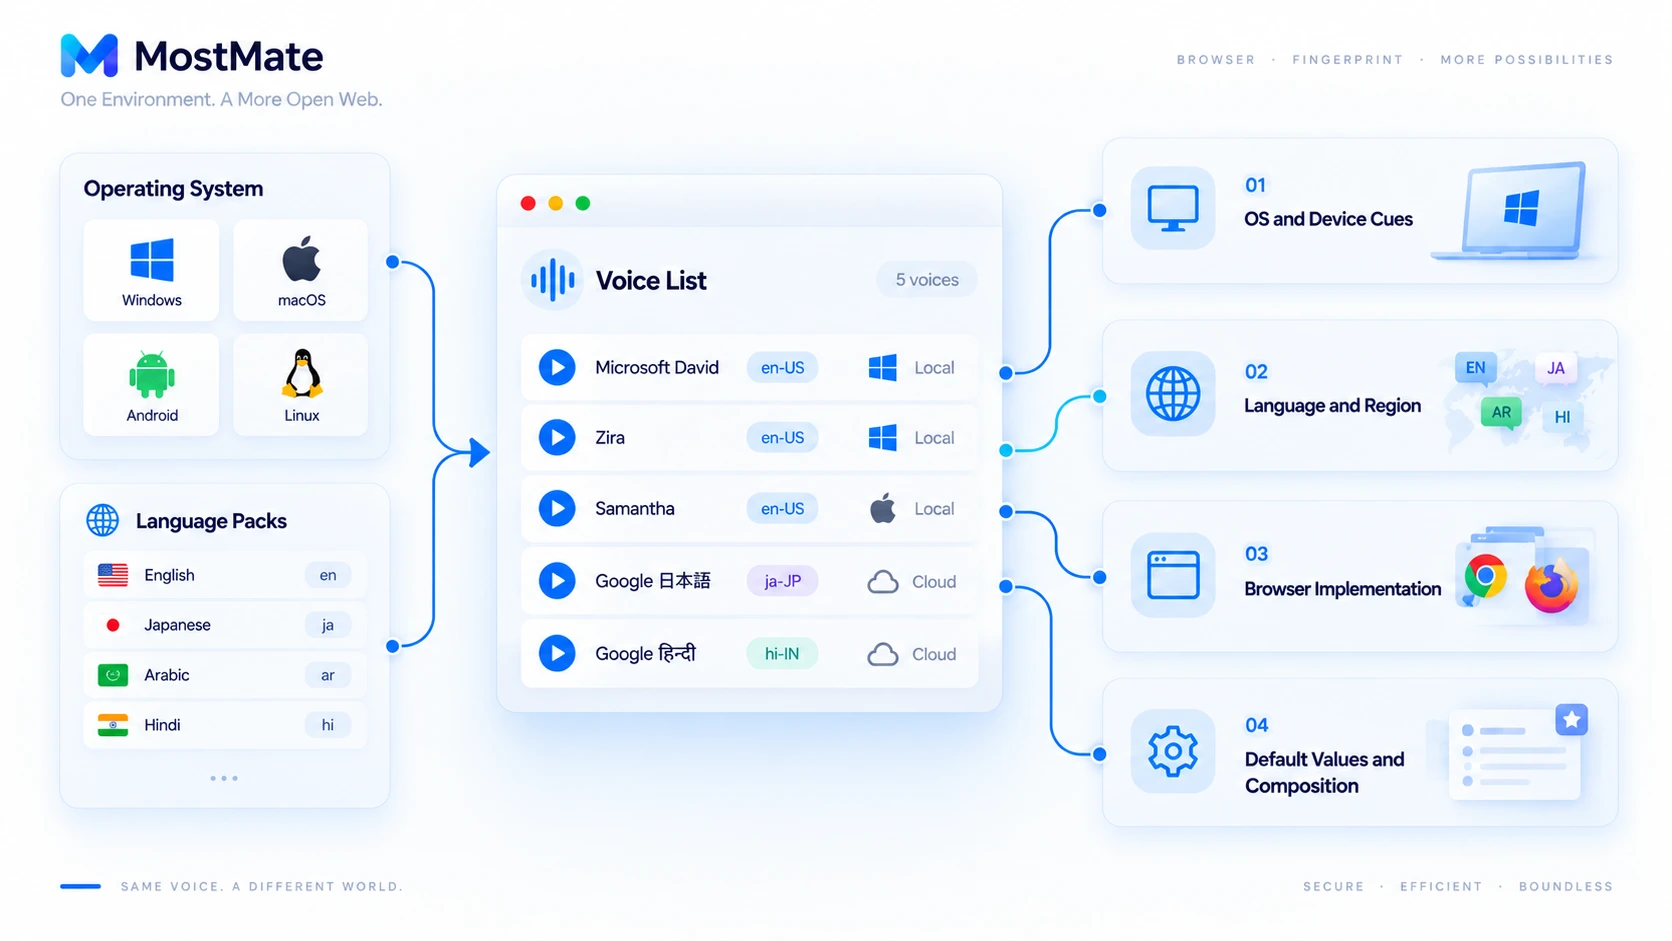
Primeiro tipo: sistema operacional e pistas do dispositivo. As vozes vêm do serviço de fala do sistema. No Windows aparecem nomes como Microsoft David e Zira; no macOS, Samantha e Daniel. Em celulares Android vem o pacote de vozes do Google. Num desktop Linux sem serviço de fala instalado, a lista costuma vir vazia.
Segundo tipo: idioma e região. A combinação de etiquetas lang revela quais pacotes de idioma já foram instalados na máquina. Uma lista com vozes em japonês, árabe e híndi conta ao site sobre um histórico multilíngue que o próprio usuário talvez não lembre.
Terceiro tipo: diferenças de implementação do navegador. O Chrome sobrepõe às vozes do sistema as vozes na nuvem do Google. O campo localService separa síntese local de serviço online. Na mesma máquina, Chrome e Firefox podem devolver listas de composição diferente.
Quarto tipo: padrões e combinação geral. Quantidade, ordem, etiquetas de idioma e voz padrão, juntos, formam um sinal de ambiente com boa capacidade de diferenciação. Vale a ressalva: é apenas um indício entre vários, e o site conclui algo cruzando múltiplos sinais. Uma lista de vozes não identifica uma pessoa específica.
Qual a diferença entre impressão digital de voz, AudioContext e Canvas?
Os três costumam ser citados juntos, mas observam coisas bem diferentes. Veja o comparativo:
| Método de detecção | O que observa | Como ocorre |
|---|---|---|
| Impressão de voz SpeechSynthesis | Vozes disponíveis e campos | Lê uma lista, sem som algum |
| Impressão AudioContext | Resultado de operações de áudio | Executa cálculos e compara saídas |
| Impressão Canvas | Características do desenho gráfico | Renderiza imagens e compara pixels |
| Impressão de fontes | Fontes instaladas e renderização | Testa a disponibilidade de fontes |
Enumerar vozes e renderizar áudio são caminhos distintos: um lê uma lista estática, o outro calcula um resultado dinâmico, e confundir os dois é erro. O guia de impressão AudioContext cobre o segundo caminho. Já a impressão de fontes pertence à mesma família estática da lista de vozes: ambos leem diretamente o que está instalado no dispositivo.
Como conferir quais dados de voz o navegador expõe?
Basta o DevTools: em cinco minutos você obtém a mesma lista que qualquer site consegue ver.
- Abra o Console no DevTools, digite speechSynthesis.getVoices() e dê Enter para ver o retorno.
- Expanda os objetos de voz da lista e anote os valores de name, lang, localService e voiceURI.
- Atualize a página e consulte de novo em seguida, comparando com a primeira chamada para confirmar o carregamento assíncrono.
- Repita os passos em outro computador ou sistema e observe se a diferença vem do serviço de fala do sistema ou da implementação do navegador.
- Conecte um proxy e consulte mais uma vez. A lista normalmente não muda, o que confirma ser um sinal do nível do dispositivo.
Na hora de interpretar, dois cuidados. Lista vazia não significa ausência de impressão digital de voz; o vazio em si também é informação. Linux sem serviço de fala e alguns ambientes automatizados costumam devolver arrays vazios. Lista comprida também não torna você mais identificável. O julgamento vem da coerência do ambiente como um todo, não da contagem de parâmetros isolados.
Como o MostMate gerencia as características de voz do ambiente?
A lista de vozes é um parâmetro do nível do dispositivo, e a abordagem do navegador antidetectável é levá-la para dentro da configuração do ambiente, não deixá-la solta.
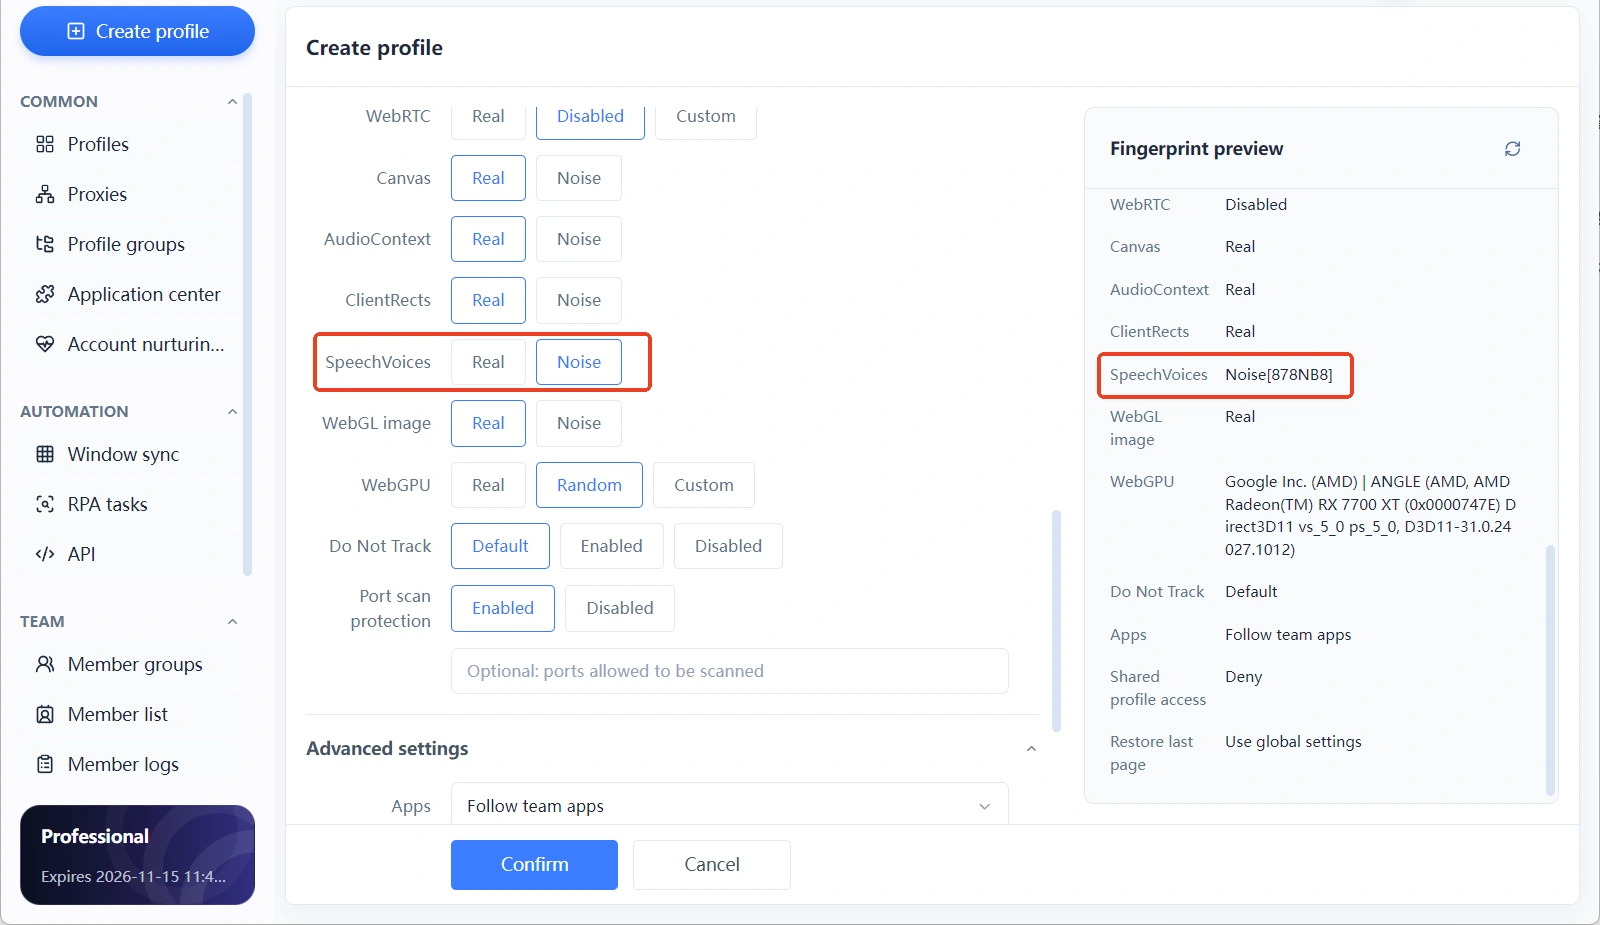
No MostMate, ao criar ou editar um ambiente, abra a seção "Configurações de impressão digital" (指纹设置). O SpeechVoices aparece como parâmetro próprio, ao lado de Canvas, AudioContext, ClientRects e imagens WebGL. São dois modos, Real e Noise; Noise é o modo de ruído.
Ao escolher Noise, a linha SpeechVoices no painel de pré-visualização à direita passa a mostrar um valor com um código de seis caracteres. Canvas e AudioContext têm códigos próprios, que não se misturam. O código identifica a configuração de ruído; o hash realmente exposto aparece na página de detecção ao abrir o ambiente.
Parâmetros de voz não se ajustam isolados. O sistema operacional, o idioma e o fuso do ambiente definem como a lista de vozes deveria ser. Um ambiente Windows exibindo um conjunto de vozes do macOS é contradição evidente. A ordem recomendada: primeiro defina sistema e proxy, depois confira parâmetros do nível do dispositivo, voz incluída. Isso rende mais do que tentativa e erro item por item.
Para controle item a item, siga a lista de configuração manual de impressão digital no site oficial. Para economizar tempo, ao criar o ambiente embrulhe esse conjunto no modo de configuração recomendada e revise pontos específicos depois. Fica o limite: o navegador antidetectável gerencia a configuração do ambiente; não há garantia de que o site não reconhecerá o ambiente nem de que a conta escapará de verificações da plataforma. As regras da plataforma seguem valendo para a conta.
Perguntas frequentes
A impressão digital de voz grava a minha voz?
Não. O processo não toca no microfone e não reproduz nenhum áudio.
Por que a lista de vozes difere entre dois computadores?
As vozes dependem do sistema operacional, dos pacotes de idioma e do serviço de fala. Windows e macOS têm vozes nativas diferentes, os pacotes instalados divergem e cada navegador soma vozes na nuvem às suas. As listas, claro, não batem.
A lista de vozes está vazia. Isso significa que não há impressão digital de voz?
Uma lista vazia também é informação. Linux sem serviço de fala e certos ambientes automatizados costumam devolver arrays vazios. Para o site, isso é um traço anômalo, não uma forma de ficar invisível.
Impressão digital de voz e impressão AudioContext são a mesma coisa?
Não. A impressão digital de voz lê uma lista estática de configurações; o AudioContext calcula um resultado dinâmico de processamento de áudio. Os caminhos de detecção são diferentes e, ao auditar um ambiente, confira cada um à parte.
O MostMate pode alterar apenas a lista de vozes do SpeechSynthesis?
No produto, isso corresponde ao parâmetro SpeechVoices nas configurações de impressão digital, com os modos Real e Noise. O nível de controle disponível segue a interface do cliente. Depois de configurar, abra a página de detecção no ambiente e confira a lista realmente exposta.
Considerações finais
No fundo, a impressão digital de voz entrega ao site o que está instalado neste dispositivo. Ela não grava nada e não pede permissão, mas acompanha o sistema operacional. Troque o IP e ela fica onde está. Por isso tantas práticas comuns ficam pela metade: limpar cookies ou trocar de proxy sozinhos não alinham o ambiente. Os parâmetros do nível do dispositivo precisam entrar na conta.
Pelo lado do produto, o MostMate coloca o SpeechVoices nas configurações de impressão digital ao lado de Canvas e AudioContext, com os modos Real e Noise. Para ver o resto dos recursos, navegue pelo site do MostMate.
Para saber o que o seu ambiente expõe agora, siga os passos da quinta seção e confira a lista de vozes; se quiser comparar, baixe o MostMate e monte um ambiente.

MOSTMATE
Gestão segura de múltiplas contas, sem complicação
Comece com sua primeira conta e use MostMate para construir operações multicontas mais seguras, inteligentes e eficientes.
- Perfis independentes. Identidades consistentes.
- Automação com IA · Saúde das contas · Operações em equipe



