
瀏覽器語音指紋是甚麼?SpeechSynthesis 語音清單如何暴露環境特徵
核心結論:語音指紋讀取的是裝置上裝了哪些合成語音,這是一份跟著作業系統走的設定清單,轉代理、清 Cookie 都不會令它改變。排查多帳戶環境的訊號一致性時,它是繼 Canvas、AudioContext 之後容易被漏掉的一項。
「代理換了、Cookie 也清了,為何環境檢測還是對不上?」做帳戶排查時,答案往往藏在裝置層的參數裡,語音正是其中最容易被忽略的一項。網站不必取得麥克風權限,也不必播放任何聲音,只要呼叫一次介面,就能取得一份與系統設定相關的清單。不少人以為清完瀏覽器痕跡便萬無一失,但這份清單由作業系統和語言包決定,跟著裝置走,與 IP 和 Cookie 毫無關係;換句話說,網絡層做得再乾淨,裝置層的特徵依然原封不動地交了出去。排查多帳戶環境時,這一層必須獨立核對。
MostMate 正是為這類問題而設的指紋瀏覽器,為每個帳戶準備一套獨立的瀏覽器環境。裝置層參數同樣納入管理範圍,語音便是其中一項。
語音指紋是甚麼?和錄音識別聲紋有何分別
語音指紋的原料是語音合成功能的設定資料,與麥克風收錄的聲紋是兩回事。
先把三個概念分開。語音合成指瀏覽器把文字轉成語音的能力,即網頁朗讀功能背後那套系統。語音清單指目前環境裡可供這套功能使用的聲音選項。按 MDN 文件的說明,呼叫 getVoices() 會傳回裝置上可用的語音物件清單。語音指紋則指網站把這份清單裡的特徵,當作識別環境的一類訊號。三者一層比一層具體。
和聲紋識別對比一下就清楚。聲紋要錄音、要授權、要真的發出聲音。語音指紋全程無聲、無須授權。網站讀到的是選單,不是聲音。分別就在這裡,也是它容易被忽視的原因:沒有彈窗、沒有知覺,資料已經交出去了。
SpeechSynthesis 怎樣把語音清單交給網站?
網站的讀取入口是 speechSynthesis.getVoices(),一次呼叫就能取得完整清單。
每個語音物件帶有五個欄位,含義見下表:
| 欄位 | 含義 | 常見取值示例 |
|---|---|---|
| name | 語音名稱 | Microsoft David、Samantha |
| lang | 語言標籤 | en-US、zh-CN |
| localService | 本機合成還是雲端服務 | true 為本機,false 為連網 |
| default | 是否為預設語音 | 每種語言至多一個 |
| voiceURI | 語音服務的標識地址 | 可能含系統內部標識 |
名稱往往只是一個人名,voiceURI 才攜帶底層資訊。以 Firefox 在 macOS 上的傳回為例,取值形如 urn:moz-tts:osx: 加一串系統內部標識。系統私有的語音註冊資訊,就這樣透過公開介面交了出去。
還有一處細節影響讀取結果。Chrome、Edge、Firefox 裡首次呼叫常傳回空陣列,語音要等 voiceschanged 事件觸發後才填充完整。載入時機本身也是訊號。有的瀏覽器立即觸發,有的延遲,有的已載入完便不再觸發。這個介面在 Web Speech API 規格裡至今仍屬草案狀態,行為細節以各瀏覽器實作為準。
語音清單會暴露哪四類環境特徵?
單一語音名稱說明不了甚麼,清單的組合方式才有區分度。
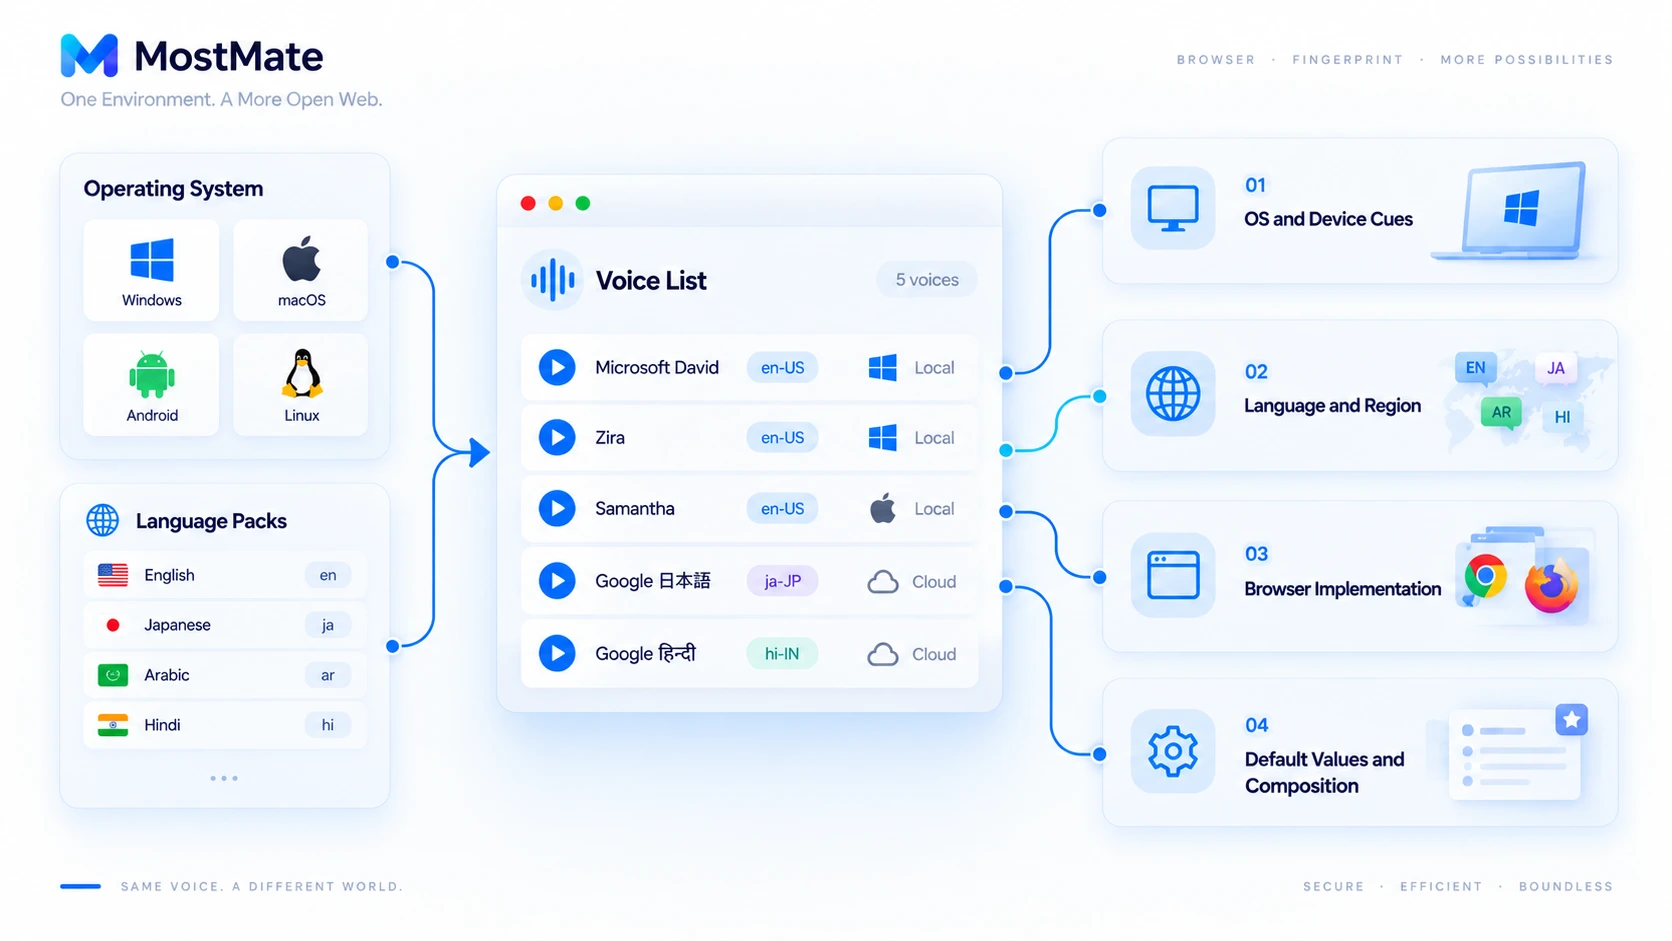
第一類:作業系統與裝置線索。 語音由系統語音服務提供。Windows 上常見 Microsoft David、Zira 這類名字;macOS 上常見 Samantha、Daniel。Android 手機上是 Google 語音服務的一套。Linux 桌面如果沒裝語音服務,清單常常是空的。
第二類:語言與地區設定。 lang 標籤的組合反映這部機器裝過哪些語言包。一份同時帶日語、阿拉伯語、印地語語音的清單,等於把多語言使用背景報給了網站。用戶自己都未必記得。
第三類:瀏覽器實作差異。 Chrome 會在系統語音之上疊加 Google 的雲端語音。localService 一項,能區分本機合成與連網服務。同一部機器,Chrome 和 Firefox 傳回的清單構成可能不同。
第四類:預設值與整體組合。 數量、順序、語言標籤、預設語音拼在一起,構成區分度相當高的環境訊號。再補一句邊界:它只是線索之一,網站要綜合多類訊號才下結論。一份語音清單認不出具體的人。
語音指紋和 AudioContext、Canvas 指紋有甚麼分別?
三者經常被一併提起,但觀察對象完全不同。先看對照:
| 檢測方式 | 觀察對象 | 過程特點 |
|---|---|---|
| SpeechSynthesis 語音指紋 | 可用語音清單及欄位 | 讀設定清單,全程無聲 |
| AudioContext 指紋 | 音訊處理運算的結果 | 執行運算,比對輸出差異 |
| Canvas 指紋 | 圖形繪製輸出的特徵 | 渲染圖像,比對像素 |
| 字體指紋 | 系統安裝的字體及渲染 | 探測字體可用性 |
語音清單枚舉和音訊渲染是兩條路徑。一個讀靜態清單,一個算動態結果,兩者不能混為一談。AudioContext 指紋一篇講的是後一條路徑的原理與設定。字體指紋則和語音清單同屬靜態清單一類,都是裝置裝了甚麼的直接讀數。
怎樣檢查瀏覽器暴露了哪些語音資訊?
檢查只需要開發者工具,五分鐘能拿到網站能看到的那份清單。
- 開啟開發者工具的 Console,輸入 speechSynthesis.getVoices() 並按 Enter,看傳回內容。
- 展開清單裡的語音物件,記錄 name、lang、localService、voiceURI 的取值。
- 重新整理頁面後立刻再查一次,對比首次是否為空陣列,確認非同步載入行為。
- 轉另一部電腦或另一個系統重複步驟,觀察差異來自系統語音服務還是瀏覽器實作。
- 掛上代理再查一遍,清單通常不變,正好驗證它是裝置層訊號。
解讀結果有兩點分寸。清單為空不代表沒有語音指紋,空本身也是一條資訊。無語音服務的 Linux 和部分自動化環境,常傳回空陣列。清單長也不代表更容易被認出。判斷要看整體環境是否自洽,而不是數單項參數的多少。
MostMate 怎樣管理語音環境特徵?
語音清單屬於裝置層參數,指紋瀏覽器對它的處理方式是納入環境設定,而不是放任不管。
在 MostMate 建立或編輯環境的「指紋設定」裡,SpeechVoices 是一項獨立參數,與 Canvas、AudioContext、ClientRects、WebGL 圖像並列。檔位有 Real 與 Noise 兩檔,Noise 即噪音模式。
選 Noise 後,右側指紋預覽面板的 SpeechVoices 一欄會顯示帶六位代號的取值。Canvas、AudioContext 各有各的代號,互不通用。代號是噪音設定的標識,實際暴露的雜湊值要開啟環境訪問檢測頁查看。
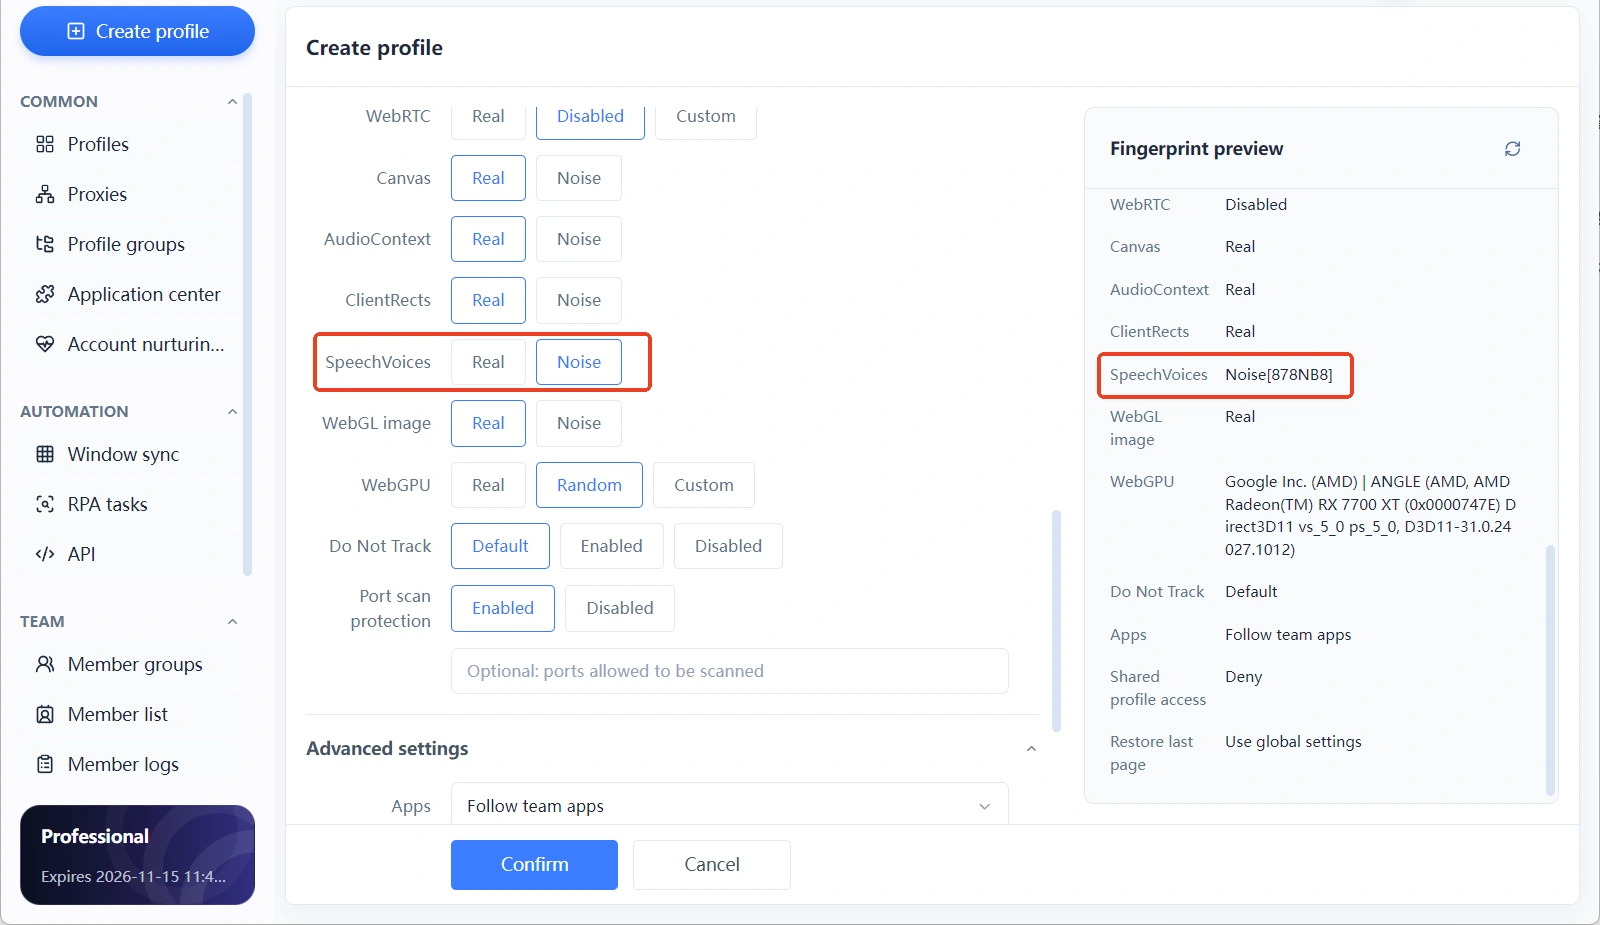
語音參數不孤立調。環境的作業系統、語言、時區決定了語音清單應該長甚麼樣。Windows 環境配出一套 macOS 語音,就是明顯矛盾。調整次序建議先定系統與代理,再核對語音這類裝置層參數。這比逐項亂試可靠。
需要逐項控制時,可以按官網手動指紋設定清單逐項調。想節省設定時間,建立環境時用推薦設定封裝這批參數,之後再針對個別項複核。也要說明邊界。指紋瀏覽器管理的是環境設定,不能保證網站無法識別環境,也不能保證帳戶不觸發平台驗證。帳戶本身仍要遵守平台規則。
常見問題
語音指紋會錄我的聲音嗎?
不會。整個讀取過程不碰麥克風、不播放音訊。
為何兩部電腦的語音清單不一樣?
語音由作業系統、語言包和語音服務決定。Windows 與 macOS 的內置語音不同,裝過的語言包不同,瀏覽器疊加的雲端語音也不同。清單自然對不上。
語音清單為空,是不是就沒有語音指紋?
空清單本身也是一條資訊。沒有語音服務的 Linux、部分自動化環境常傳回空陣列。對網站來說這是一種異常特徵,不能當作隱身。
語音指紋和 AudioContext 指紋是同一回事嗎?
不是一類。語音指紋讀靜態的設定清單,AudioContext 算動態的音訊處理結果。檢測路徑不同,排查環境時要分開核對。
MostMate 可以單獨修改 SpeechSynthesis 語音清單嗎?
產品裡對應指紋設定的 SpeechVoices 參數,Real 與 Noise 兩檔,能調到甚麼粒度以用戶端介面為準。設定後建議開啟環境訪問檢測頁,核對實際暴露的清單。
結語
語音指紋的本質,是把這部裝置裝了甚麼交給網站。它不錄音、不要權限,卻跟著作業系統走。IP 換了,它也不動。所以很多常見做法就講得通:只清 Cookie、只換代理,環境對不上時,裝置層參數要一併對齊。
產品側,MostMate 把 SpeechVoices 連同 Canvas、AudioContext 一併放進指紋設定。控制檔位是 Real 與 Noise 兩檔。其他功能的全貌,可以到 MostMate 官網自己過一遍。
想看自己的環境現在暴露了甚麼,按第五節的步驟查一遍語音清單,也可以下載 MostMate建一個環境做對比。

MOSTMATE
安全管理多帳戶,輕鬆簡單
從首個帳戶開始,利用 MostMate 建立更安全、更智能、更高效的多帳戶營運方式。
- 設定檔各自獨立,身分保持一致。
- AI 自動化 · 帳戶健康 · 團隊營運



