
¿Qué es la huella de voz del navegador? Cómo la lista de voces de SpeechSynthesis delata las características del entorno
En esencia: la huella de voz lee las voces sintéticas instaladas en el dispositivo. Es una lista de configuración que acompaña al sistema operativo, y ni cambiar el proxy ni borrar las cookies la modifican. Cuando revisas la coherencia de señales entre varias cuentas, es el punto que se pasa por alto después de Canvas y AudioContext.
«Cambié el proxy, borré las cookies y la detección del entorno sigue sin cuadrar». Cuando auditas cuentas, la respuesta suele esconderse en los parámetros del dispositivo. La voz es de lo que más se olvida. El sitio no necesita el micrófono ni reproducir sonido alguno: una sola llamada le basta para obtener un inventario ligado a la configuración del sistema.
Ese inventario lo determinan el sistema operativo y los paquetes de idioma, y viaja con el equipo. Cambias la IP y ahí sigue. MostMate está pensado justo para estos casos: es un navegador antidetección que prepara un entorno de navegador independiente para cada cuenta. Los parámetros del dispositivo también quedan bajo control, y la voz es uno de ellos.
¿Qué es la huella de voz y en qué se diferencia de la identificación por voz?
La materia prima de la huella de voz es la configuración de la síntesis de voz, no una voz captada por el micrófono.
Empecemos separando tres conceptos. La síntesis de voz es la capacidad del navegador de convertir texto en sonido, la que hay detrás de la lectura en voz alta de las páginas. La lista de voces son las opciones de sonido disponibles para esa función en el entorno actual. Según la documentación de MDN, llamar a getVoices() devuelve la lista de objetos de voz disponibles en el dispositivo. Y la huella de voz aparece cuando el sitio usa las características de esa lista como señal para identificar el entorno. Cada concepto es más concreto que el anterior.
La comparación con la identificación por voz lo deja claro. Esa exige grabar, pedir permiso y que hables de verdad. La huella de voz, en cambio, es silenciosa de principio a fin y no pide ningún permiso. El sitio lee un menú, no un sonido. Ahí está la diferencia, y también la razón por la que pasa desapercibida: sin ventanas emergentes ni sensación alguna, los datos ya se fueron.
¿Cómo entrega SpeechSynthesis la lista de voces al sitio?
La puerta de entrada es speechSynthesis.getVoices(): una llamada y tienes el inventario completo.
Cada objeto de voz trae cinco campos; sus significados, en la tabla:
| Campo | Significado | Ejemplos habituales |
|---|---|---|
| name | nombre de la voz | Microsoft David, Samantha |
| lang | etiqueta de idioma | en-US, zh-CN |
| localService | síntesis local o servicio en la nube | true: local, false: en línea |
| default | si es la voz predeterminada | como mucho una por idioma |
| voiceURI | dirección del servicio de voz | puede incluir identificadores del sistema |
El nombre suele ser un simple nombre de pila; la información de fondo viaja en voiceURI. En Firefox sobre macOS, el valor adopta la forma urn:moz-tts:osx: seguido de un identificador interno del sistema. Los registros privados de voces del sistema quedan así, a través de una interfaz pública, en manos de terceros.
Hay otro detalle que afecta al resultado. En Chrome, Edge y Firefox, la primera llamada suele devolver un array vacío: la lista solo se completa tras el evento voiceschanged. El propio momento de carga también es una señal. Unos navegadores disparan el evento de inmediato, otros con retraso y a algunos ya no les hace falta porque tienen todo cargado. En la especificación de Web Speech API esta interfaz sigue en borrador, así que el comportamiento definitivo lo decide cada navegador.
¿Qué cuatro tipos de características del entorno expone la lista de voces?
Una voz aislada no dice nada: lo que discrimina es cómo se combina la lista.
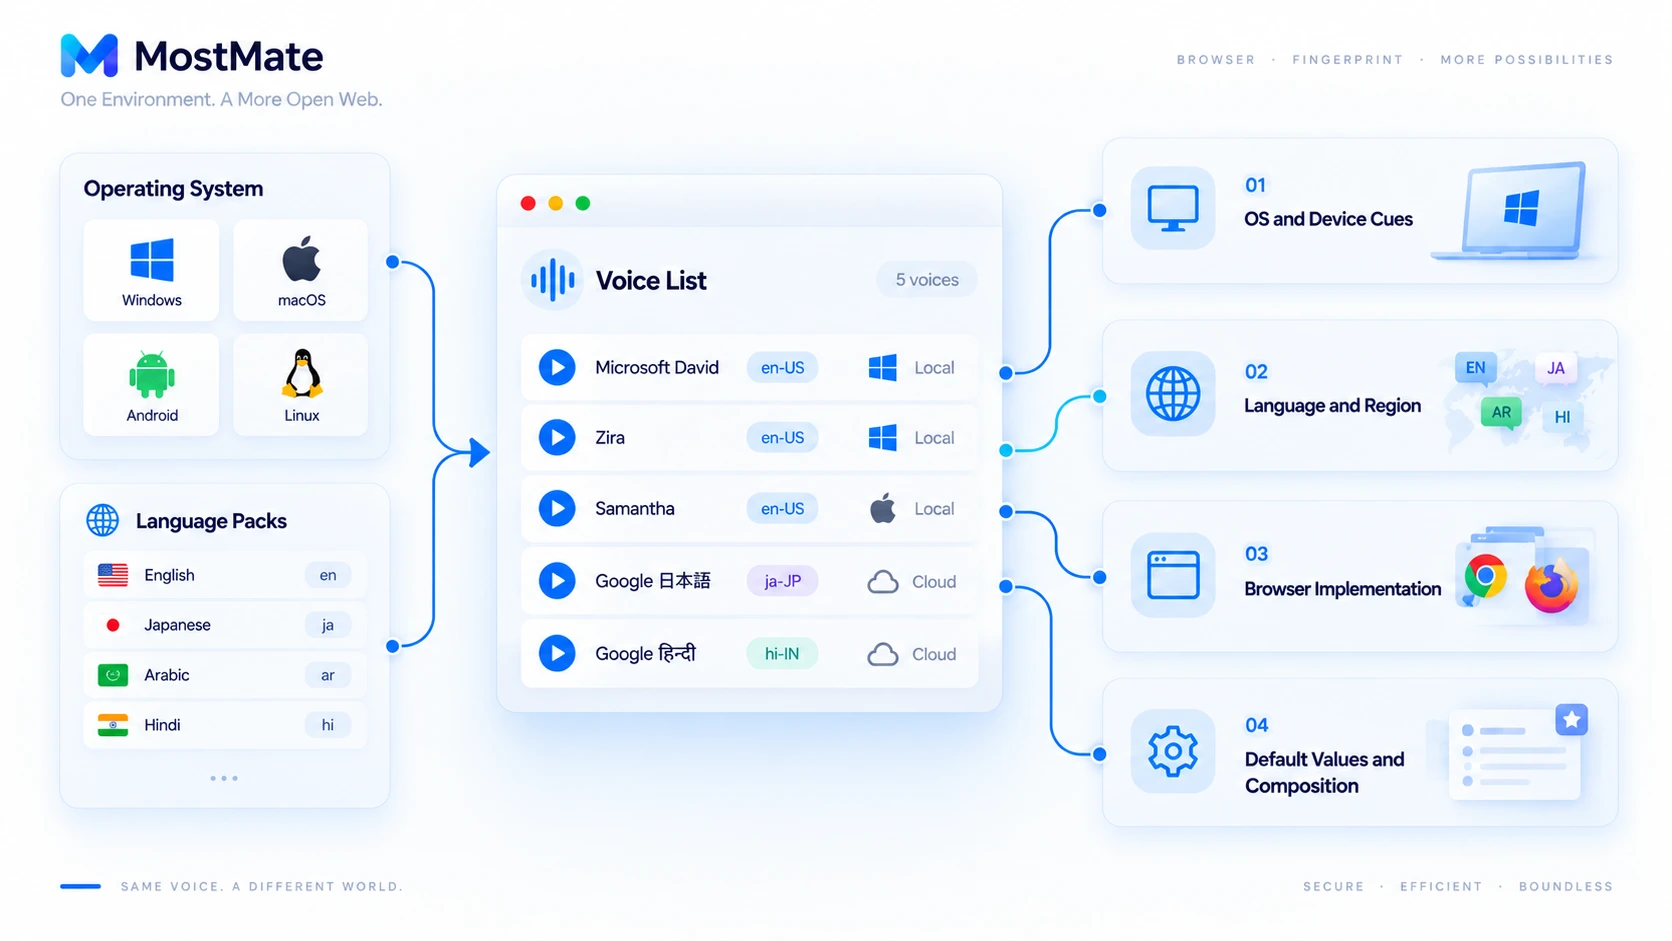
Primer tipo: sistema operativo y dispositivo. Las voces las presta el servicio de síntesis del sistema. En Windows abundan nombres como Microsoft David o Zira; en macOS, Samantha y Daniel; en Android, el paquete de voces de Google. Un escritorio Linux sin servicio de síntesis suele devolver una lista vacía.
Segundo tipo: idioma y región. La combinación de etiquetas lang revela qué paquetes de idioma hay instalados en la máquina. Una lista con japonés, árabe e hindi juntos confiesa de paso un trasfondo multilingüe que el propio usuario quizá no recuerde.
Tercer tipo: diferencias entre navegadores. Chrome superpone a las voces del sistema las voces en la nube de Google. El campo localService distingue la síntesis local del servicio en línea. En la misma máquina, Chrome y Firefox pueden devolver listas de composición distinta.
Cuarto tipo: valores predeterminados y conjunto. Cantidad, orden, etiquetas de idioma y voz predeterminada forman juntos una señal bastante discriminante. Un matiz importante: es solo una pista más, y el sitio concluye cruzando varios tipos de señales. Con una lista de voces no se identifica a una persona concreta.
¿En qué se diferencia la huella de voz de las huellas AudioContext y Canvas?
Suelen mencionarse juntas, pero lo que observan no tiene nada que ver. Primero, la comparación:
| Método | Objeto observado | Cómo funciona |
|---|---|---|
| Huella de voz SpeechSynthesis | lista de voces y sus campos | lee una configuración, sin sonido |
| Huella AudioContext | resultado del procesado de audio | ejecuta cálculos y compara salidas |
| Huella Canvas | rasgos del renderizado gráfico | renderiza una imagen y compara píxeles |
| Huella de fuentes | fuentes instaladas y su renderizado | comprueba la disponibilidad de fuentes |
Enumerar voces y procesar audio son dos caminos distintos: uno lee un inventario estático y el otro calcula un resultado dinámico. No hay que mezclarlos. El artículo sobre la huella AudioContext explica el segundo camino, principio y ajustes. La huella de fuentes pertenece, como la lista de voces, a la familia de los inventarios estáticos: ambas son lecturas directas de lo que hay instalado en el dispositivo.
¿Cómo comprobar qué información de voz expone tu navegador?
Bastan las herramientas de desarrollador: en cinco minutos tendrás la misma lista que ve el sitio.
- Abre la Console de las herramientas de desarrollador, escribe speechSynthesis.getVoices() y pulsa Intro para ver la respuesta.
- Despliega los objetos de voz de la lista y anota los valores de name, lang, localService y voiceURI.
- Recarga la página y vuelve a consultarlo enseguida: si el primer resultado es un array vacío, confirmas la carga asíncrona.
- Repite los pasos en otro equipo o sistema para ver si la diferencia viene del servicio de síntesis o del navegador.
- Conéctate mediante un proxy y consulta de nuevo: la lista normalmente no cambia, lo que confirma que la señal vive en el dispositivo.
Dos matices al interpretar los resultados. Una lista vacía no significa que no haya huella: el vacío también es información. Un Linux sin servicio de síntesis y algunos entornos automatizados suelen devolver un array vacío. Y una lista larga no te hace más reconocible. Lo que hay que juzgar es si el entorno en conjunto es coherente, no cuántos parámetros sueltos tiene.
¿Cómo gestiona MostMate las características de voz del entorno?
La lista de voces es un parámetro del dispositivo, y el navegador antidetección la incorpora a la configuración del entorno en lugar de dejarla al azar.
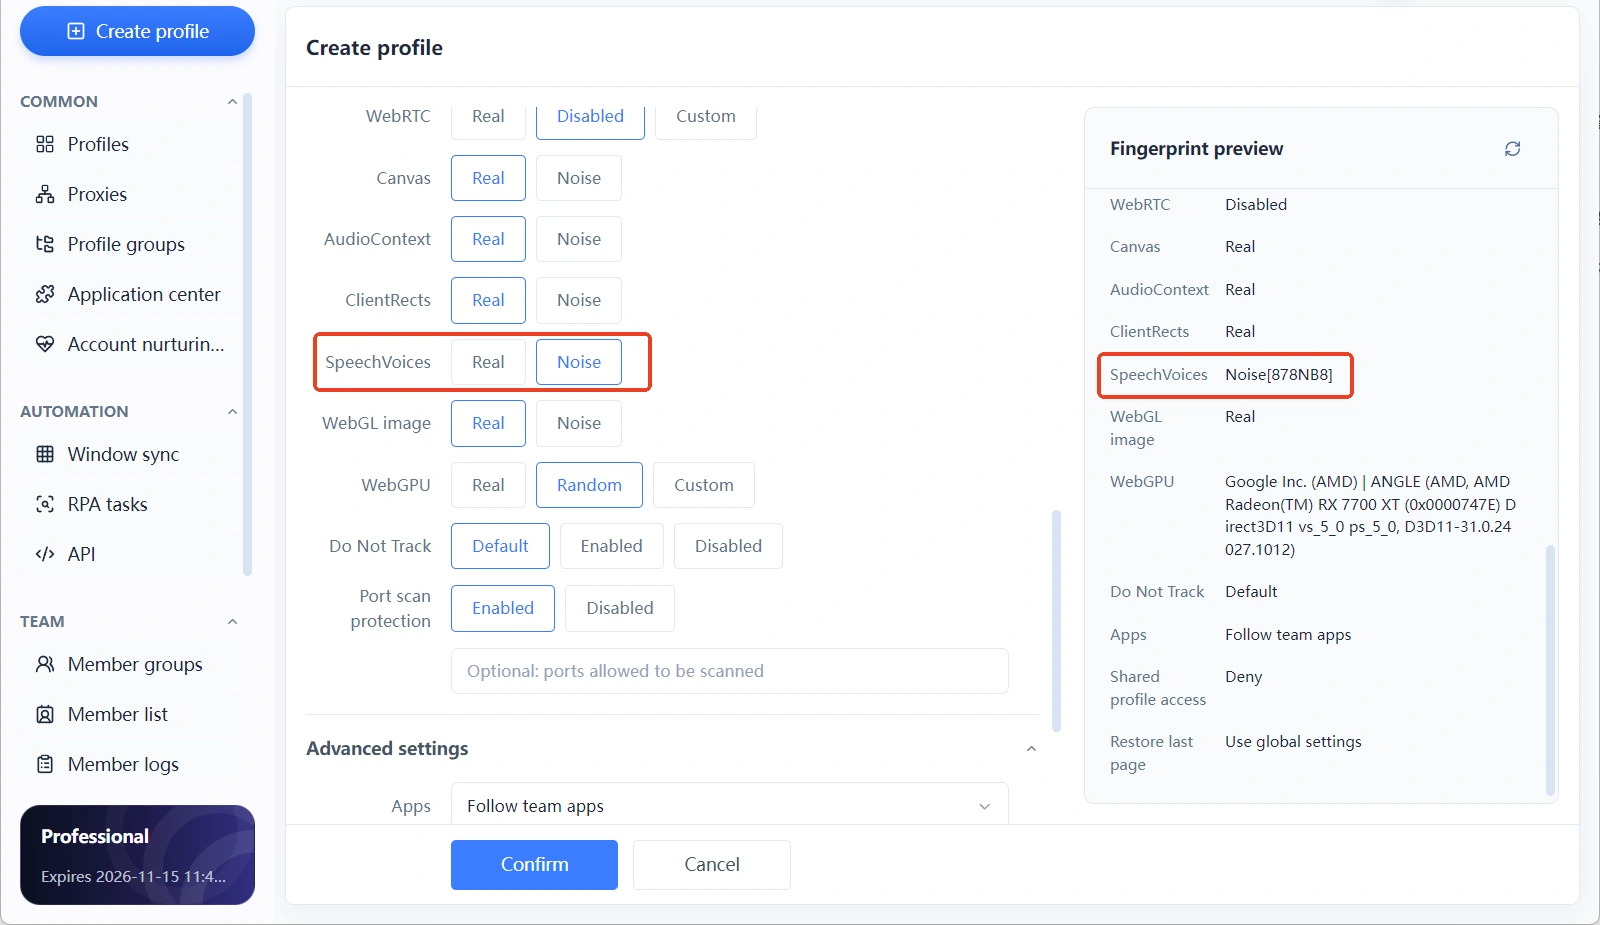
En MostMate, al crear o editar un entorno, SpeechVoices aparece como parámetro independiente dentro de los ajustes de huella (指纹设置), junto a Canvas, AudioContext, ClientRects y las imágenes WebGL. Hay dos modos: Real y Noise; este último es el modo de ruido.
Al elegir Noise, la fila SpeechVoices del panel de vista previa de la derecha muestra un valor con un código de seis dígitos. Canvas y AudioContext tienen sus propios códigos, sin correspondencia entre sí. El código solo identifica la configuración de ruido; el hash realmente expuesto se comprueba abriendo el entorno en la página de detección.
La voz no se ajusta por separado. El sistema operativo, el idioma y la zona horaria del entorno determinan cómo debería ser la lista de voces. Un entorno Windows con voces de macOS es una contradicción evidente. El orden recomendado: fijar primero sistema y proxy y después revisar los parámetros del dispositivo como la voz. Es más fiable que probar a ciegas punto por punto.
Si necesitas controlar cada parámetro por separado, sigue la lista de ajustes manuales de huella de la web oficial. Para ahorrar tiempo, al crear el entorno usa la configuración recomendada, que empaqueta estos parámetros, y luego revisa algún punto concreto. Seamos claros con los límites: el navegador antidetección gestiona la configuración del entorno, pero no garantiza que el sitio no lo identifique ni que la cuenta esquive las verificaciones de la plataforma. La cuenta sigue teniendo que respetar las reglas de la plataforma.
Preguntas frecuentes
¿La huella de voz graba mi voz?
No. En ningún momento se toca el micrófono ni se reproduce audio: el sitio recibe solo la configuración del servicio de síntesis. La identificación por voz necesita permiso de grabación; la huella de voz no pide ninguno.
¿Por qué dos ordenadores tienen listas de voces distintas?
Las voces dependen del sistema operativo, de los paquetes de idioma y del servicio de síntesis. Windows y macOS no traen las mismas voces integradas, los paquetes instalados difieren y las voces en la nube que añade cada navegador tampoco coinciden. Es normal que las listas no cuadren.
Si la lista de voces está vacía, ¿no hay huella de voz?
Una lista vacía dice algo: anomalía para el sitio, no camuflaje.
¿Son lo mismo la huella de voz y la huella AudioContext?
No son lo mismo. La huella de voz lee un inventario estático de configuración; AudioContext calcula un resultado dinámico de procesado de audio. Las vías de detección son distintas, así que al diagnosticar un entorno conviene revisarlas por separado.
¿Se puede modificar solo la lista de voces de SpeechSynthesis en MostMate?
En el producto corresponde al parámetro SpeechVoices de los ajustes de huella, con los modos Real y Noise; el nivel de detalle depende de la interfaz del cliente. Tras configurarlo, conviene abrir la página de detección del entorno y comprobar la lista que se expone de verdad.
Conclusión
La esencia de la huella de voz es decirle al sitio qué tiene instalado este dispositivo. No graba, no pide permisos y va pegada al sistema operativo: cambias la IP y ella sigue ahí. Por eso tantas prácticas habituales se explican solas: si solo borras cookies o solo cambias de proxy, los parámetros del dispositivo también tienen que alinearse.
Por su parte, MostMate coloca SpeechVoices junto a Canvas y AudioContext en los ajustes de huella. Los modos siguen siendo dos: Real y Noise. Para ver el resto de funciones con calma, echa un vistazo a la web de MostMate.
Si quieres saber qué expone tu entorno ahora mismo, sigue los pasos de la quinta sección y revisa la lista de voces, o bien descarga MostMate y crea un entorno para comparar.

MOSTMATE
Gestión segura de varias cuentas, sin complicaciones
Empieza con tu primera cuenta y utiliza MostMate para crear operaciones multicuenta más seguras, inteligentes y eficientes.
- Perfiles independientes. Identidades coherentes.
- Automatización con IA · Estado de las cuentas · Operaciones en equipo



