
Qu'est-ce que l'empreinte vocale du navigateur ? Comment la liste de voix de SpeechSynthesis révèle les caractéristiques de votre environnement
L'essentiel : l'empreinte vocale lit les voix de synthèse installées sur l'appareil. C'est une configuration qui suit le système d'exploitation, et ni un changement de proxy ni un nettoyage des cookies ne la modifient. Quand vous vérifiez la cohérence des signaux entre plusieurs comptes, c'est l'élément qui échappe le plus souvent, juste après Canvas et AudioContext.
« Le proxy a changé, les cookies sont nettoyés, et la détection ne correspond toujours pas ? » Quand on audite des comptes, la réponse se cache souvent dans les paramètres côté appareil. La voix est l'un des plus faciles à négliger. Le site n'a besoin ni du micro ni de jouer le moindre son : un seul appel d'interface lui suffit pour obtenir une liste liée à la configuration du système.
Cette liste est dictée par le système d'exploitation et les packs de langue, et elle voyage avec l'appareil. L'IP change, elle ne bouge pas. MostMate a été conçu pour ce genre de problème : un navigateur anti-détection qui prépare à chaque compte un environnement de navigation indépendant. Les paramètres côté appareil font partie de la gestion, et la voix en fait partie.
Qu'est-ce que l'empreinte vocale et en quoi diffère-t-elle de l'identification par la voix ?
La matière première de l'empreinte vocale, c'est la configuration de la synthèse vocale, pas une voix captée au micro.
Commencez par distinguer trois notions. La synthèse vocale est la capacité du navigateur à transformer du texte en son, celle qui se cache derrière la lecture à voix haute des pages. La liste de voix désigne les options sonores disponibles pour cette fonction dans l'environnement actuel. D'après la documentation MDN, appeler getVoices() renvoie la liste des objets de voix disponibles sur l'appareil. L'empreinte vocale, enfin, apparaît quand le site traite les caractéristiques de cette liste comme un signal pour identifier l'environnement. Chaque notion est plus concrète que la précédente.
La comparaison avec l'identification vocale est parlante. Celle-ci exige un enregistrement, une autorisation, une vraie prise de parole. L'empreinte vocale, elle, reste silencieuse du début à la fin et ne demande aucune permission. Le site lit un menu, pas un son. Toute la différence est là, et c'est aussi ce qui la fait passer inaperçue : aucune fenêtre, aucune sensation, et les données sont déjà parties.
Comment SpeechSynthesis remet-il la liste de voix au site ?
La porte d'entrée côté site, c'est speechSynthesis.getVoices() : un seul appel donne la liste complète.
Chaque objet de voix comporte cinq champs, détaillés ci-dessous :
| Champ | Signification | Exemples courants |
|---|---|---|
| name | nom de la voix | Microsoft David, Samantha |
| lang | étiquette de langue | en-US, zh-CN |
| localService | synthèse locale ou service en ligne | true : locale, false : en ligne |
| default | voix par défaut ou non | au plus une par langue |
| voiceURI | adresse du service de voix | peut contenir des identifiants système |
Derrière le nom se cache souvent un simple prénom ; l'information de fond voyage dans voiceURI. Dans Firefox sur macOS, la valeur ressemble à urn:moz-tts:osx: suivi d'un identifiant interne au système. Les registres de voix privés du système passent ainsi, par une interface publique, aux mains de tiers.
Un détail influence aussi le résultat. Sur Chrome, Edge et Firefox, le premier appel renvoie souvent un tableau vide : la liste ne se remplit qu'après l'événement voiceschanged. Le moment du chargement est lui-même un signal. Certains navigateurs déclenchent tout de suite, d'autres avec du retard, d'autres encore ne déclenchent plus rien quand tout est déjà chargé. Dans la spécification Web Speech API, cette interface reste à l'état de brouillon ; chaque navigateur fait foi pour les détails de comportement.
Quelles sont les quatre familles d'indices d'environnement que révèle la liste de voix ?
Une voix seule ne dit rien : c'est la combinaison de la liste qui fait la différence.
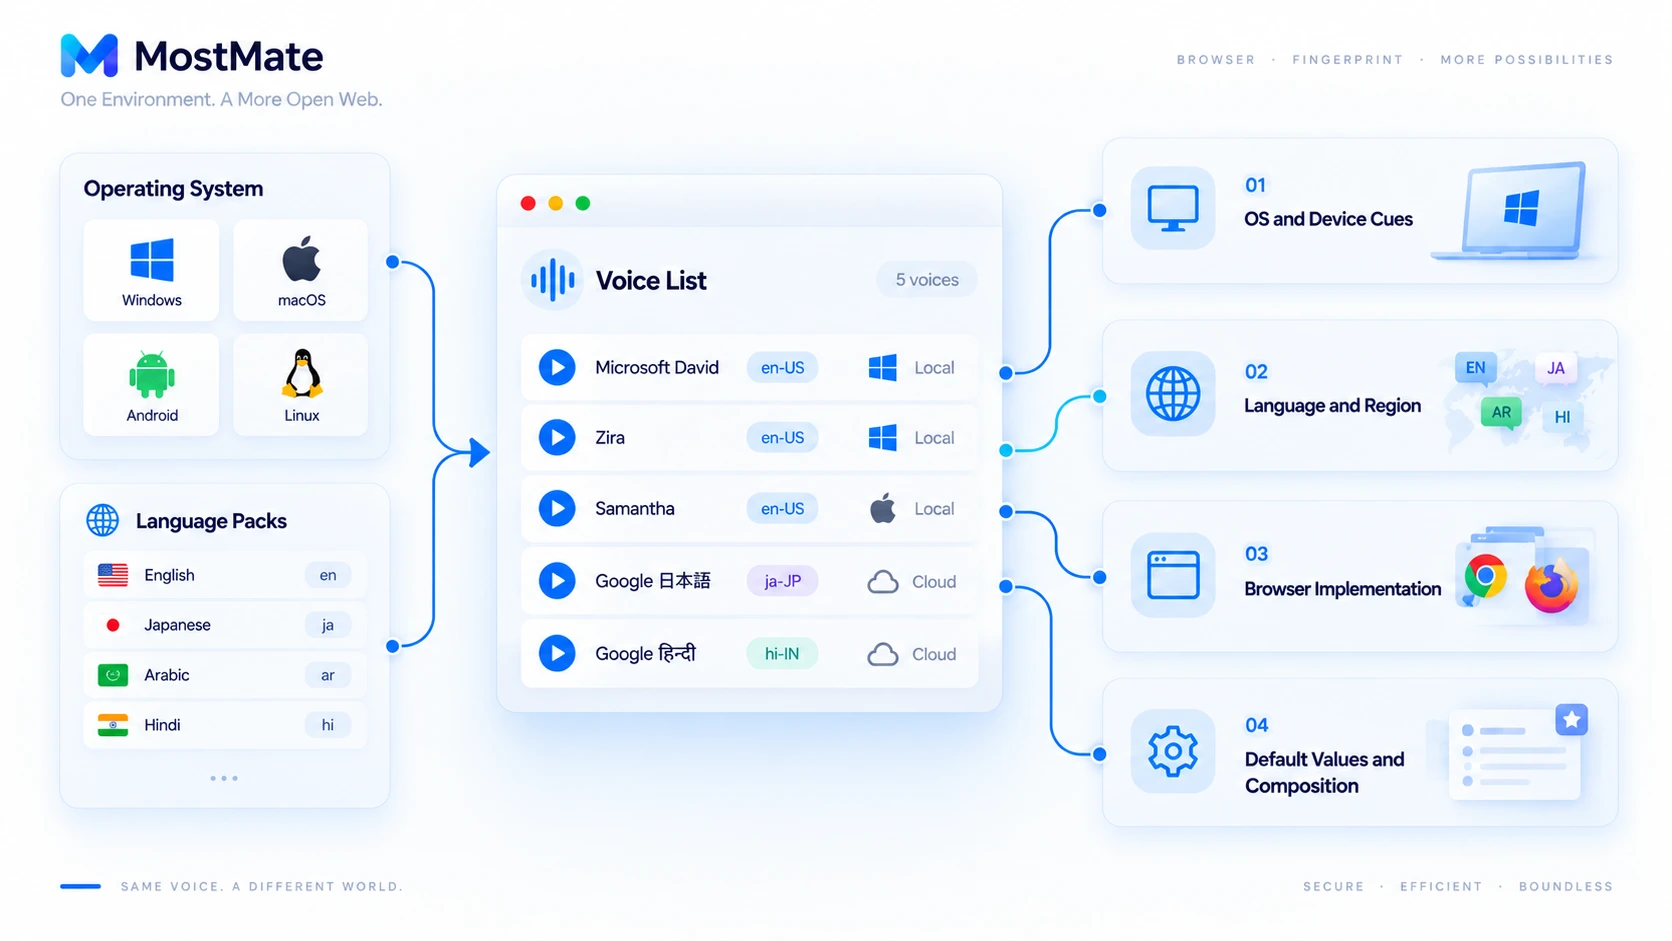
Première famille : le système d'exploitation et l'appareil. Les voix proviennent du service de synthèse du système. Sous Windows, on croise des noms comme Microsoft David ou Zira ; sur macOS, Samantha et Daniel dominent ; sur Android, c'est l'ensemble de voix Google qui prend le relais. Sur un bureau Linux sans service de synthèse, la liste est souvent vide.
Deuxième famille : langue et région. La combinaison des étiquettes lang trahit les packs de langue installés sur la machine. Une liste mêlant japonais, arabe et hindi avoue au passage un usage multilingue, dont l'utilisateur lui-même ne se souvient pas toujours.
Troisième famille : les écarts entre navigateurs. Chrome ajoute aux voix du système les voix en ligne de Google. Le champ localService permet de distinguer synthèse locale et service en ligne. Sur une même machine, Chrome et Firefox peuvent renvoyer des listes de composition différente.
Quatrième famille : valeurs par défaut et ensemble. Nombre, ordre, étiquettes de langue, voix par défaut : réunis, ces éléments forment un signal assez discriminant. Une précision tout de même : ce n'est qu'un indice parmi d'autres, et le site conclut en croisant plusieurs familles de signaux. Une liste de voix ne reconnaît pas une personne précise.
Empreinte vocale, AudioContext, Canvas : quelles différences ?
On les cite souvent ensemble, mais les objets observés n'ont rien en commun. Le tableau d'abord :
| Méthode | Objet observé | Déroulement |
|---|---|---|
| Empreinte vocale SpeechSynthesis | liste de voix et champs | lecture d'une configuration, sans son |
| Empreinte AudioContext | résultat de calculs audio | calculs exécutés, comparaison des sorties |
| Empreinte Canvas | caractéristiques du rendu graphique | rendu d'une image, comparaison des pixels |
| Empreinte des polices | polices installées et rendu | test de disponibilité des polices |
Énumérer des voix et restituer de l'audio sont deux chemins distincts : l'un lit un inventaire statique, l'autre calcule un résultat dynamique. Ne les confondez pas. L'article sur l'empreinte AudioContext détaille le second chemin, principe et réglages. Comme la liste de voix, l'empreinte des polices appartient à la famille des inventaires statiques : deux lectures directes de ce que l'appareil a installé.
Comment vérifier quelles informations vocales expose votre navigateur ?
Les outils de développement suffisent : en cinq minutes, vous obtenez la liste telle que la voit le site.
- Ouvrez la Console des outils de développement, tapez speechSynthesis.getVoices() puis validez pour voir le contenu renvoyé.
- Dépliez les objets de voix de la liste et notez les valeurs de name, lang, localService et voiceURI.
- Rechargez la page et relancez aussitôt : un premier résultat vide confirme le chargement asynchrone.
- Recommencez sur un autre ordinateur ou système pour voir si l'écart vient du service de synthèse ou du navigateur.
- Refaites le test via un proxy : la liste ne bouge généralement pas, preuve que le signal vit côté appareil.
Deux nuances à l'interprétation. Une liste vide ne signifie pas absence d'empreinte : le vide est lui-même une information. Un Linux sans service de synthèse et certains environnements automatisés renvoient souvent un tableau vide. Une liste longue ne vous rend pas plus reconnaissable pour autant. Jugez la cohérence d'ensemble de l'environnement, pas le nombre de paramètres isolés.
Comment MostMate gère-t-il les caractéristiques vocales de l'environnement ?
La liste de voix est un paramètre côté appareil : le navigateur anti-détection l'intègre à la configuration de l'environnement au lieu de la laisser en l'état.
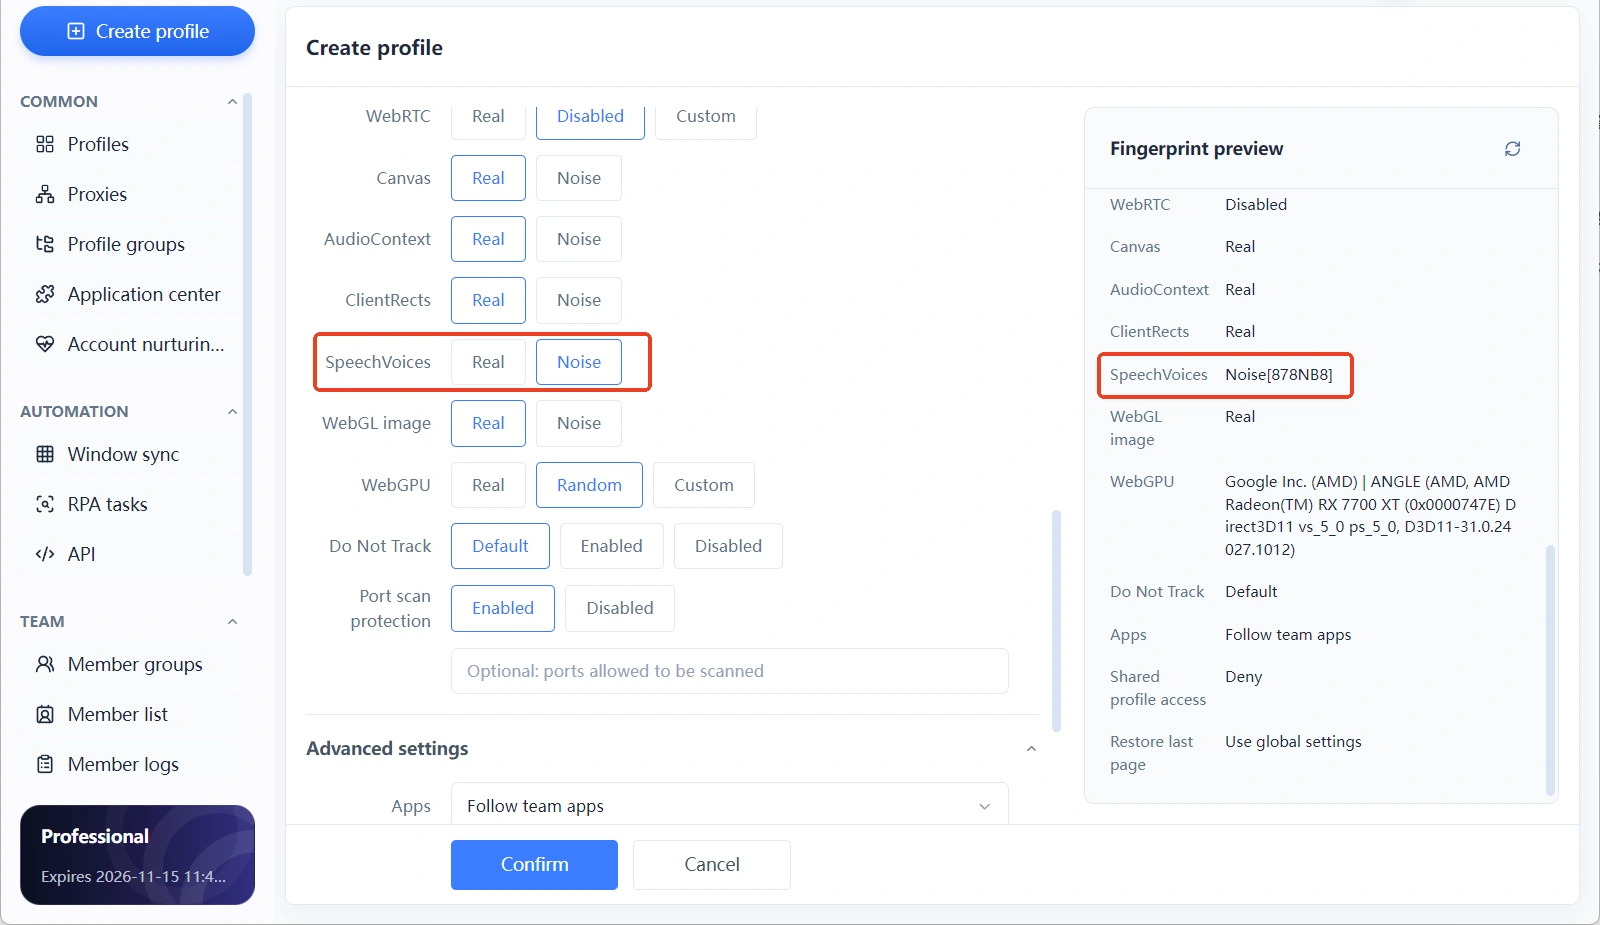
Dans MostMate, dans les réglages d'empreinte (指纹设置) au moment de créer ou modifier un environnement, SpeechVoices figure comme paramètre indépendant à côté de Canvas, AudioContext, ClientRects et des images WebGL. Deux modes sont proposés : Real et Noise, ce dernier étant le mode bruit.
Une fois Noise choisi, la ligne SpeechVoices du panneau d'aperçu à droite affiche une valeur assortie d'un code à six caractères. Canvas et AudioContext ont chacun leurs codes, sans équivalence entre eux. Le code identifie seulement la configuration de bruit ; pour le hachage réellement exposé, ouvrez l'environnement et consultez la page de détection.
La voix ne se règle pas isolément. Le système, la langue et le fuseau horaire de l'environnement dictent la forme que devrait prendre la liste. Des voix macOS dans un environnement Windows : contradiction flagrante. Ordre conseillé : fixer d'abord le système et le proxy, puis aligner les paramètres côté appareil comme la voix. C'est plus fiable que de tâtonner ligne par ligne.
Pour un contrôle champ par champ, suivez la liste des réglages manuels d'empreinte sur le site officiel. Pour gagner du temps, prenez la configuration recommandée à la création de l'environnement, qui regroupe ces paramètres, puis revoyez les points sensibles. Précisons la limite : le navigateur anti-détection gère une configuration d'environnement, il ne garantit ni que le site ne reconnaîtra pas l'environnement, ni que le compte évitera les vérifications de la plateforme. Le compte reste tenu de respecter les règles de la plateforme.
Questions fréquentes
L'empreinte vocale enregistre-t-elle ma voix ?
Non. La lecture ne touche pas au micro et ne joue aucun son : le site ne reçoit que la configuration du service de synthèse. L'identification vocale exige une autorisation d'enregistrement ; l'empreinte vocale, aucune.
Pourquoi deux ordinateurs ont-ils des listes de voix différentes ?
Les voix dépendent du système d'exploitation, des packs de langue et du service de synthèse. Windows et macOS n'embarquent pas les mêmes voix, les packs installés diffèrent, et les voix en ligne ajoutées par le navigateur varient elles aussi. Les listes ne peuvent que diverger.
Liste de voix vide : donc pas d'empreinte vocale ?
Une liste vide est elle-même un signal d'anomalie, pas un camouflage.
Empreinte vocale et empreinte AudioContext : la même chose ?
Non. L'empreinte vocale lit un inventaire statique, AudioContext calcule un résultat audio dynamique. Les voies de détection diffèrent : lors d'un diagnostic, vérifiez-les séparément.
Peut-on modifier uniquement la liste de voix SpeechSynthesis dans MostMate ?
Côté produit, cela correspond au paramètre SpeechVoices des réglages d'empreinte, avec les modes Real et Noise ; le niveau de finesse dépend de l'interface du client. Après le réglage, ouvrez la page de détection de l'environnement pour vérifier la liste réellement exposée.
Conclusion
Au fond, l'empreinte vocale apprend au site ce que cet appareil a installé. Pas d'enregistrement, pas de permission demandée, et une fidélité au système d'exploitation : changez d'IP, elle ne bouge pas. Bien des habitudes s'expliquent alors : se contenter de nettoyer les cookies ou de changer de proxy ne suffit pas, les paramètres côté appareil doivent s'aligner eux aussi.
Côté produit, MostMate place SpeechVoices aux côtés de Canvas et AudioContext dans les réglages d'empreinte. Toujours deux modes : Real et Noise. Pour faire le tour des autres fonctionnalités, rendez-vous sur le site de MostMate.
Pour voir ce que votre environnement expose en ce moment, suivez les étapes de la cinquième section et passez la liste de voix en revue, ou téléchargez MostMate et créez un environnement à des fins de comparaison.

MOSTMATE
Gérez plusieurs comptes en sécurité, tout simplement
Commencez avec votre premier compte et utilisez MostMate pour construire des opérations multicomptes plus sûres, intelligentes et efficaces.
- Des profils indépendants. Des identités cohérentes.
- Automatisation par IA · État des comptes · Travail en équipe



