
Cấu hình fingerprint và proxy cho web scraping: tư duy thiết lập để thu thập không bị chặn
Kết luận chính: nguyên nhân bị chặn hiếm khi dồn về một điểm; phần lớn nằm rải trên ba tầng: proxy, fingerprint và nhịp thu thập. Thứ tự cấu hình quan trọng hơn số lượng tham số. Trước hết, cố định lối ra proxy cho từng nhiệm vụ. Sau đó, trao cho môi trường một bộ tham số fingerprint nhất quán về logic. Cuối cùng, hạ tần suất yêu cầu xuống mức trang đích chấp nhận được. Bài viết đưa ra checklist theo thứ tự này, đồng thời hướng dẫn dùng Local API để nối quản lý môi trường vào script thu thập.
“Mua tới hơn chục proxy.” Thế mà lệnh chặn lại tới dày hơn. Các đội làm thu thập thường dồn ngân sách vào proxy, nhưng vấn đề chưa chắc nằm ở số lượng proxy. Yêu cầu ra vào tần suất cao qua cùng một lối ra, mọi phiên đều mang cùng một bộ đặc điểm trình duyệt, gặp xác minh rồi vẫn chạy đúng kế hoạch cũ: chỉ cần một tầng lệch cân bằng là những lối ra đã mua cũng bị kéo xuống cùng.
Xét theo hình thái sản phẩm, MostMate thuộc dòng trình duyệt fingerprint: mỗi tài khoản được gán một môi trường trình duyệt độc lập, proxy, tham số fingerprint và trạng thái đăng nhập đều quản lý trong môi trường. Đặt vào kịch bản thu thập, một môi trường chính là đơn vị vận hành của một nhiệm vụ, và các môi trường không chia sẻ lối ra hay đặc điểm thiết bị với nhau. Proxy quyết định yêu cầu đi ra qua đường nào, fingerprint quyết định trang đích nhìn thấy một thiết bị thế nào. Hai tầng này vững thì kiểm soát nhịp mới có đất diễn.
Tín hiệu bị chặn chia ba tầng, và thứ tự cấu hình cũng bắt đầu từ đó
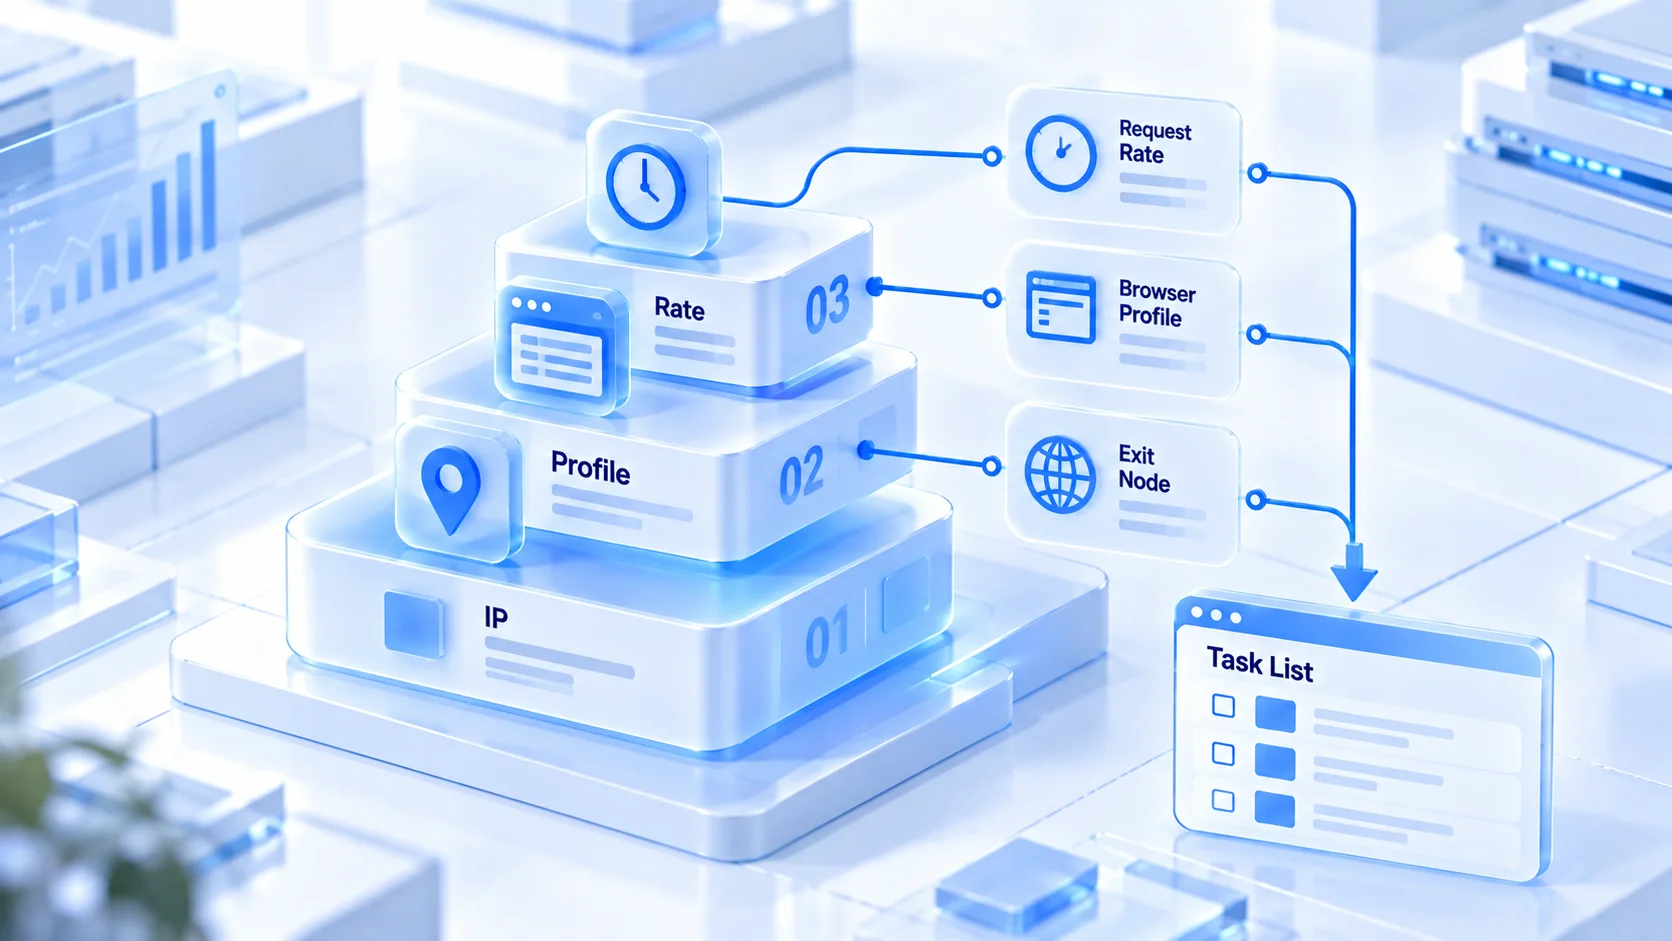
Việc chống bot kiểm tra một lượt truy cập nhìn chung trải trên ba tầng. Mỗi tầng nhìn một đối tượng khác và cần thao tác cấu hình khác nhau:
- Tầng kết nối: trang đích xem trước tiên yêu cầu đến từ IP nào, thuộc loại gì. Ra vào tần suất cao qua một lối ra, hay rơi vào dải IP bị gắn cờ, là thứ bị chặn sớm nhất.
- Tầng thiết bị: script trên trang đọc Canvas, WebGL, danh sách font, múi giờ... để đoán xem người truy cập có phải một thiết bị thật và bình thường không.
- Tầng hành vi: khoảng cách yêu cầu, lộ trình truy cập, nhịp thao tác sau đăng nhập. Mẫu lặp máy móc kéo dài sẽ liên tục đẩy mức nghi ngờ lên.
Thứ tự các tầng mất cân bằng quyết định thứ tự cấu hình. Lối ra chưa chốt thì các tham số gắn với IP như ngôn ngữ, múi giờ, vị trí địa lý chẳng có chỗ bám; đặc điểm thiết bị chưa cố định thì nhịp có tự nhiên mấy, trang đích vẫn thấy một máy duy nhất truy cập liên tục. Nên thứ tự làm việc là proxy trước, fingerprint sau, nhịp cuối; các mục dưới đây đi theo tuyến này.
Cấu hình proxy: lối ra ổn định quan trọng hơn số lượng
Cố định một lối ra độc lập cho mỗi nhiệm vụ thu thập sẽ gần với thu thập ổn định hơn là chất đống IP xoay vòng. Khi nhiều nhiệm vụ dùng chung một lối ra, một nhiệm vụ dính kiểm soát rủi ro thì các nhiệm vụ còn lại cùng lối ra hay bị vạ lây. Lối ra tách riêng rồi, ít nhất các nhiệm vụ không kéo nhau ở tầng kết nối, và khi soát lỗi cũng đối chiếu ra ngay vấn đề nằm ở đường nào.
Chọn loại lối ra theo cường độ kiểm soát rủi ro. Trang kiểm soát lỏng thì IP datacenter là đủ về chi phí. Các sàn thương mại điện tử lớn và mạng xã hội thì IP dân cư thường sống lâu hơn. Chênh lệch độ tin cậy, cấu trúc chi phí và kịch bản phù hợp của hai loại, bạn có thể dựa vào so sánh trong hướng dẫn chọn giữa IP dân cư và IP datacenter để đánh giá, đừng chọn theo cảm tính.
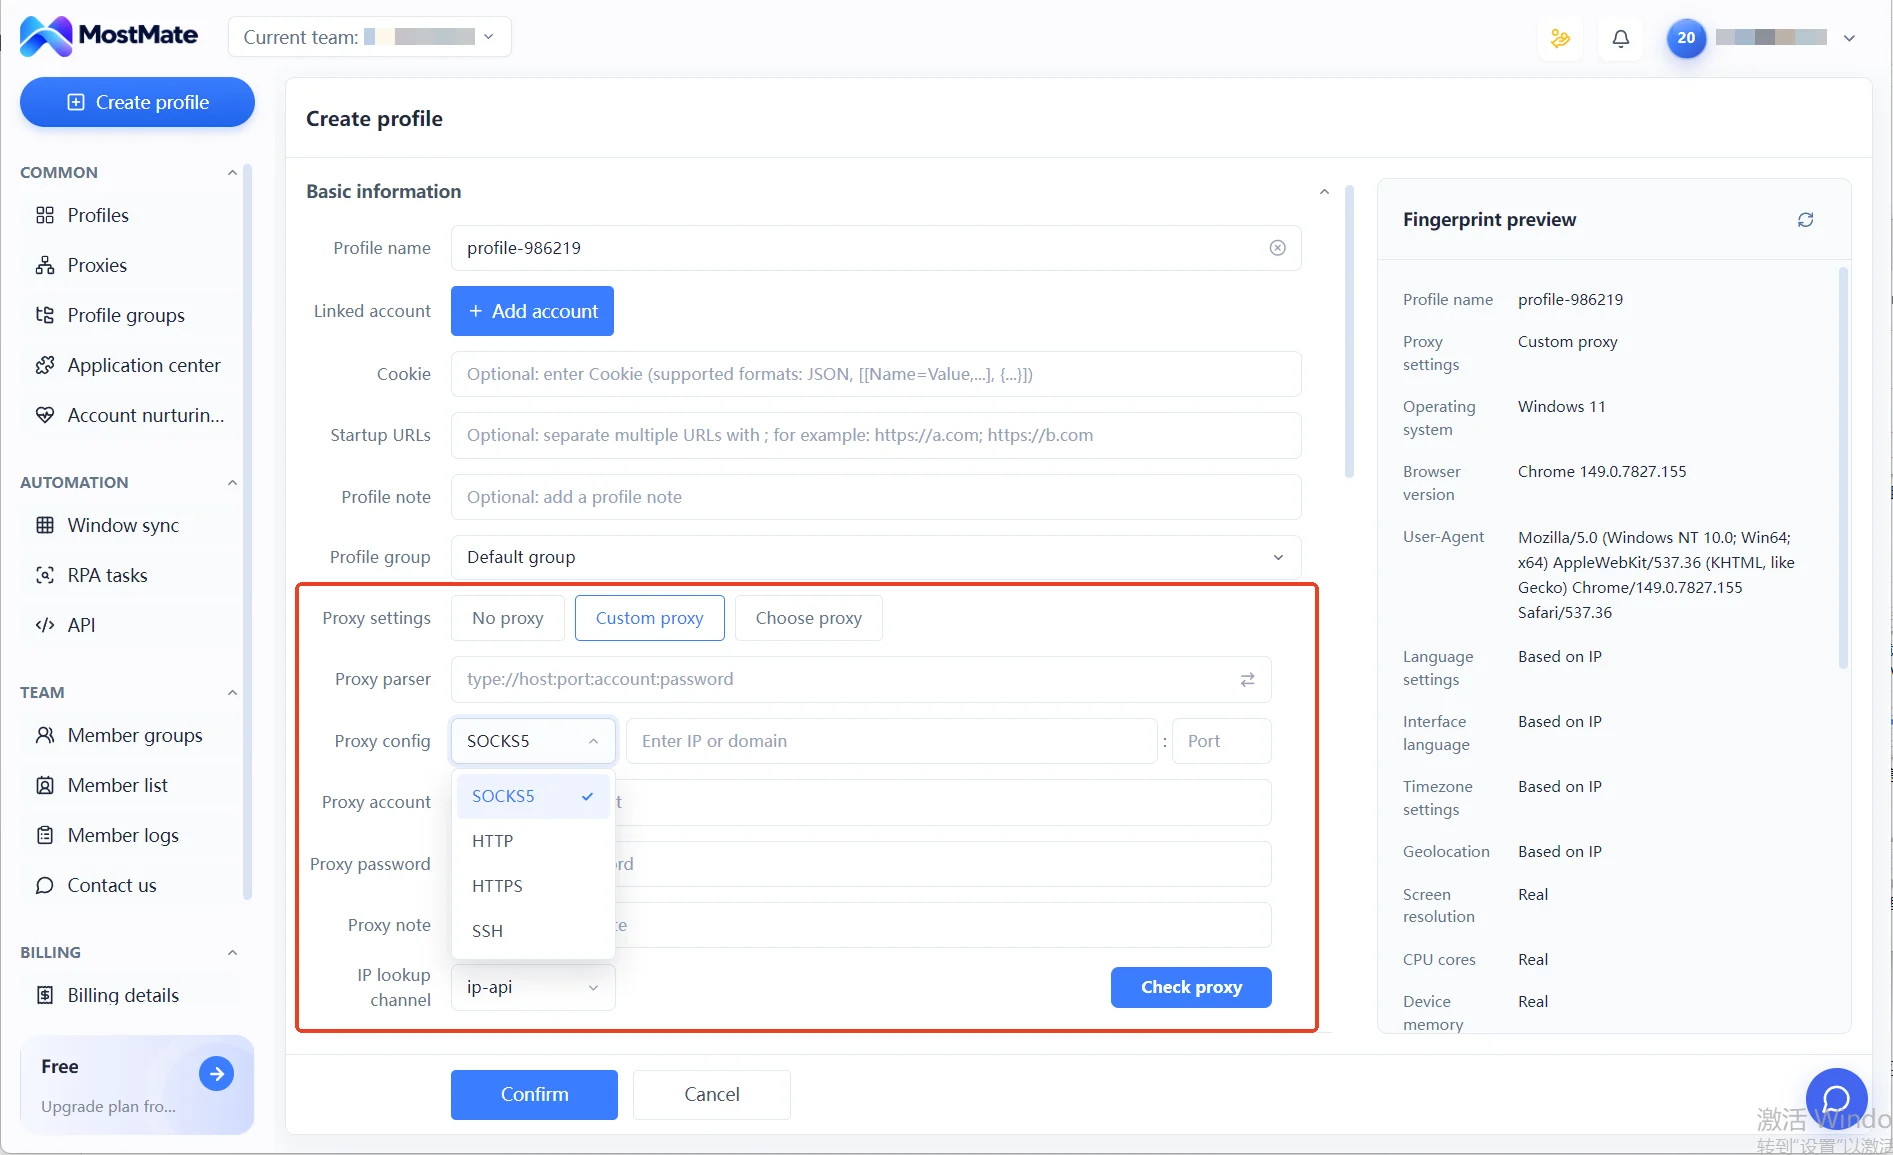
Riêng với MostMate, proxy được quản lý riêng trong danh sách quản lý proxy. Cả bốn giao thức HTTP, HTTPS, SOCKS5 và SSH đều có chỗ nhập, và mỗi dòng nhập xong đều có thể bấm nút Check proxy để kiểm tra ngay độ kết nối và xuất xứ lối ra. Test xong mới phân bổ cho môi trường. Phần cài đặt proxy trong biểu mẫu môi trường có ba mức: không dùng proxy, proxy tự cấu hình, chọn proxy. Môi trường thu thập nên chọn mức thứ ba. Mọi lối ra tập trung ở một danh sách, nhiệm vụ nào đi đường nào nhìn một cái là thấy.
Tầng proxy xong, đến lượt đặc điểm thiết bị.
Đặt tham số fingerprint thế nào: nhất quán trước, ngẫu nhiên cẩn trọng
Mục tiêu fingerprint của môi trường thu thập là để một môi trường, trong thời gian dài, thể hiện đặc điểm của một thiết bị bình thường như nhau. Quanh mục tiêu đó, tham số chia hai nhóm: cái gắn với lối ra giao cho tự động canh chỉnh, cái thuộc về thiết bị thì cố định thành một bộ và để yên lâu dài.
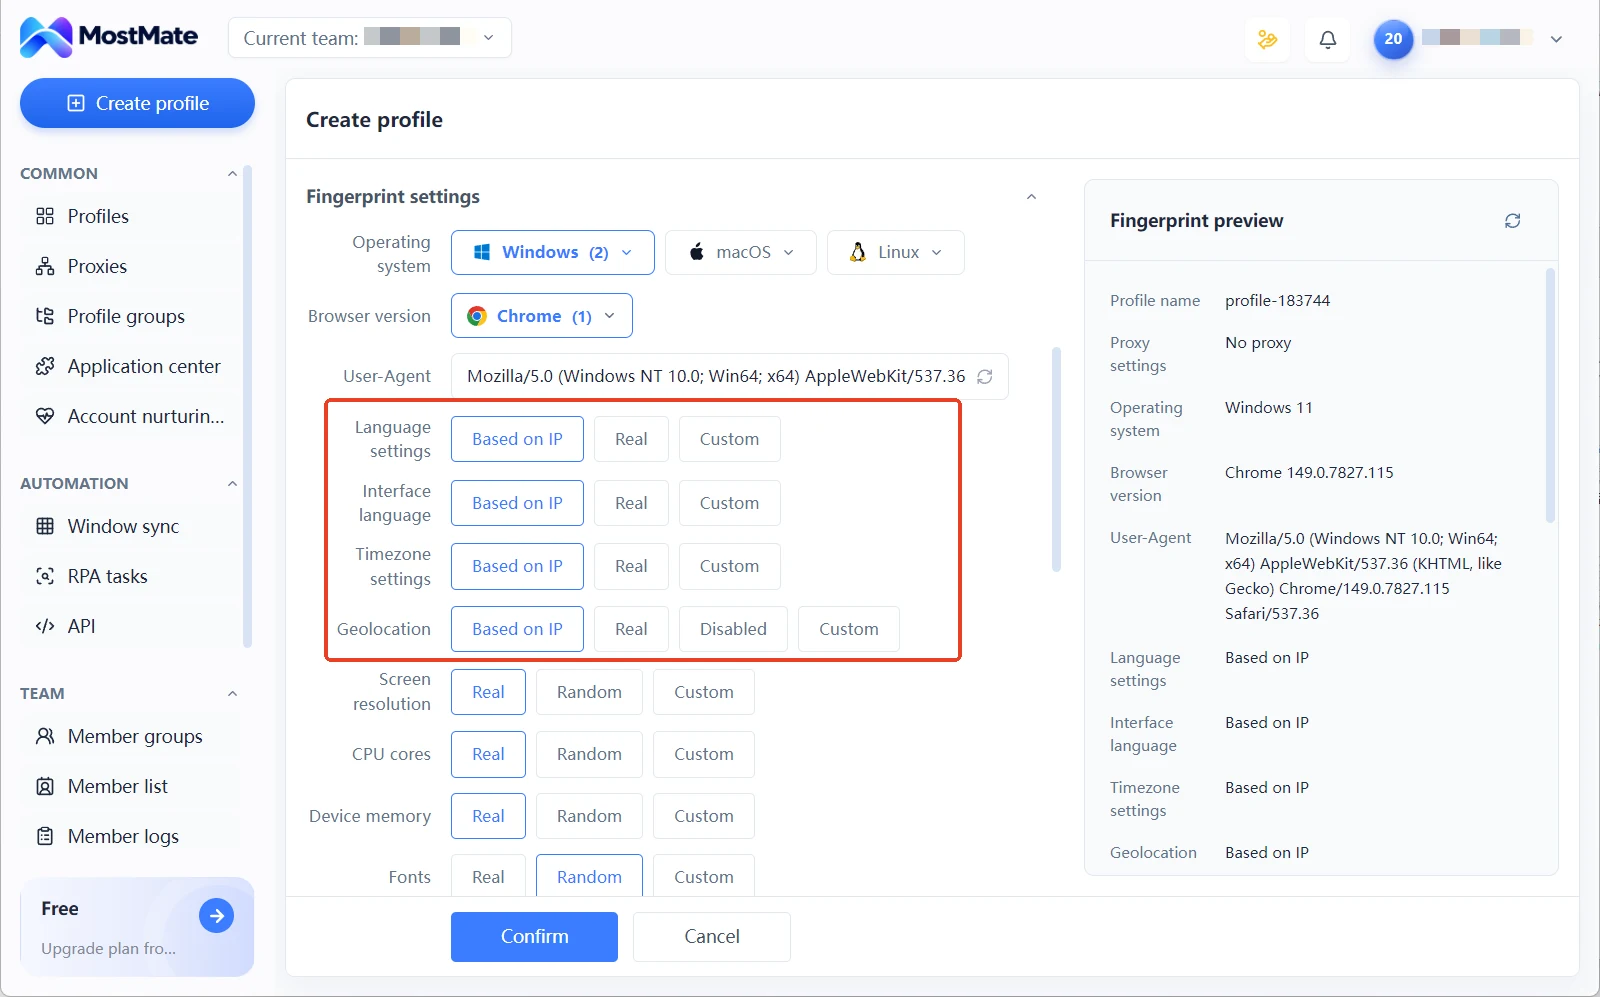
Bốn mục ngôn ngữ, ngôn ngữ giao diện, múi giờ, vị trí địa lý mặc định theo cấu hình theo IP. Lối ra chốt xong, giá trị tự canh theo. Đổi lối ra là tiết kiệm được một vòng rà tay. Hệ điều hành và phiên bản trình duyệt: chọn một tổ hợp rồi cố định, UA sinh ra theo tổ hợp đó và giữ nguyên suốt vòng đời nhiệm vụ. Độ phân giải màn hình, số nhân CPU, bộ nhớ thiết bị, danh sách font giữ giá trị thật, cùng nguồn với hệ thống đã khai báo.
Cách xử lý nhóm tham số render đáng chú ý hơn. Với các đầu ra hình ảnh và âm thanh như Canvas, WebGL, giao diện cung cấp mức nhiễu: phủ một lớp nhiễu nhẹ lên giá trị thật, đồng thời giữ nguyên logic gốc của thiết bị. Bên kiểm tra nhận về vẫn là một bộ đầu ra tự hợp lý. Vì sao giá trị ngẫu nhiên lại nguy hiểm, bạn có thể hiểu qua lập luận trong vì sao đừng random tham số fingerprint.
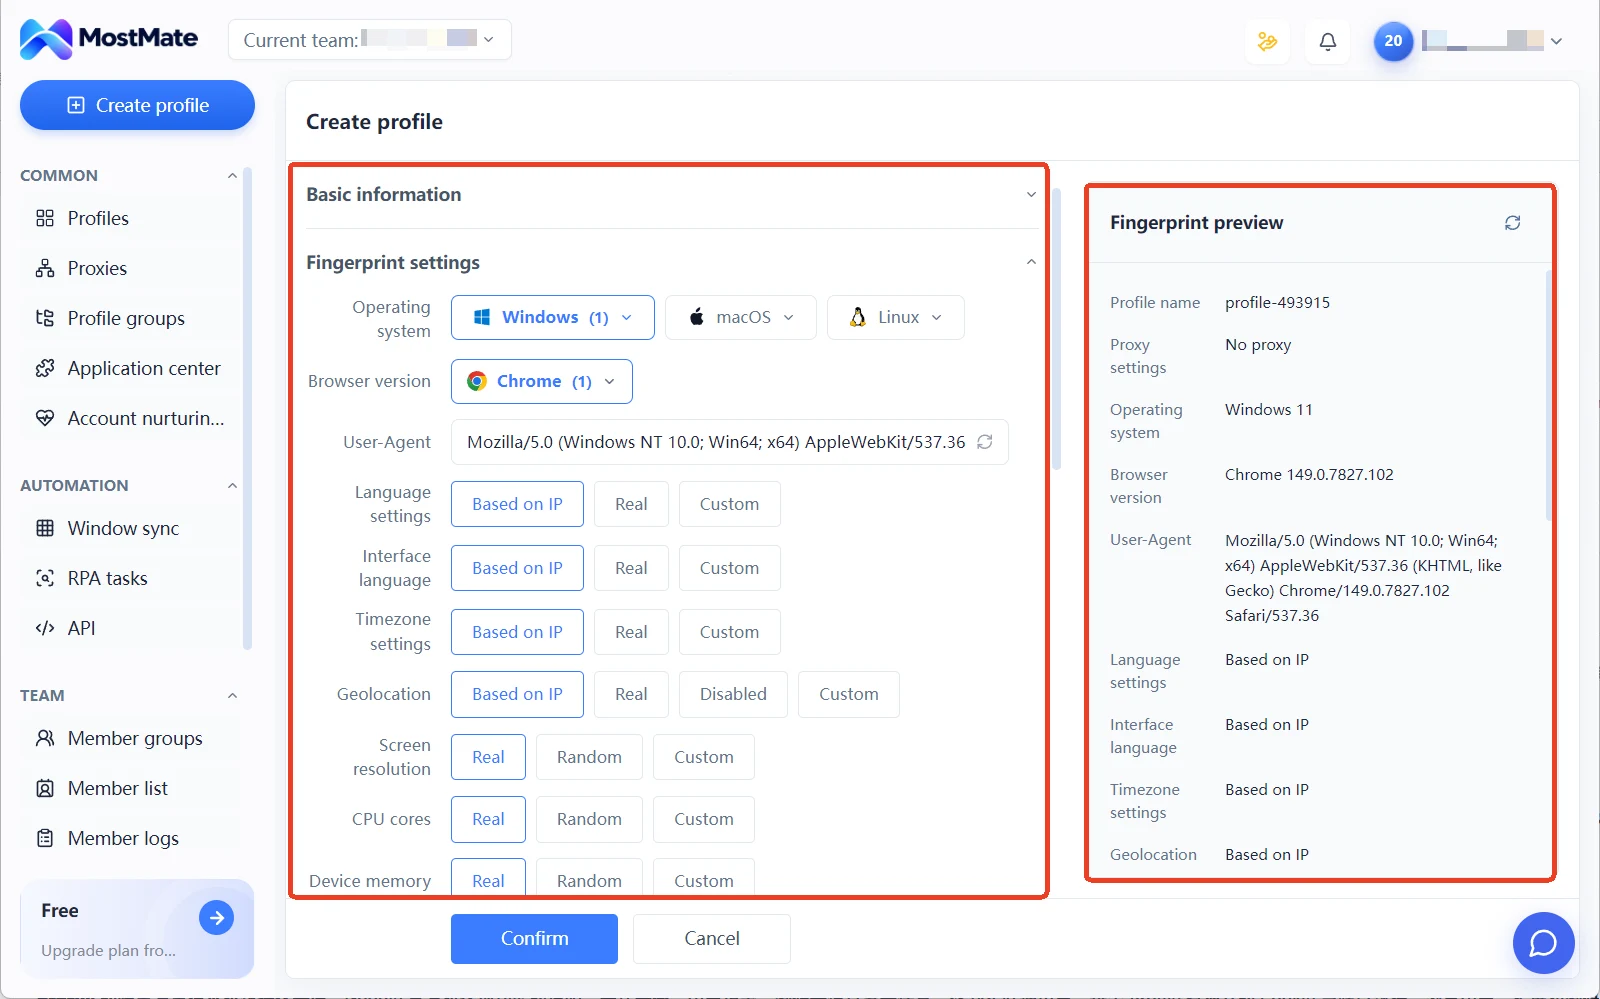
Cách làm với môi trường thu thập rất cụ thể: tham số render chọn mức nhiễu, không dùng mức ngẫu nhiên. Cấu hình xong cũng không cần đối chiếu theo cảm tính: bên phải biểu mẫu tạo môi trường có bảng xem trước fingerprint, múi giờ, mức Canvas... liệt kê sẵn theo thời gian thực. Trước khi lưu liếc qua một lượt, chỗ lệch rõ ràng nhìn ra ngay tại chỗ.
Nhịp và trạng thái đăng nhập: hạ bớt bất định ở tầng hành vi
Chạy thử nhiệm vụ mới có thể đi ba bước:
1. Chọn điểm khởi đầu: đồng thời chỉ vài tiến trình, cách nhau từng giây, chạy trước một hai ngày. Ghi lại tình huống captcha xuất hiện và tỷ lệ phản hồi bất thường. 2. Tìm ranh giới: vừa thấy captcha là lùi về tần suất bậc trước. Bậc đó chính là ranh giới an toàn hiện tại của lối ra đó. 3. Tăng dần lượng: chạy ổn vài ngày trong ranh giới rồi mới tăng đồng thời từng chút. Khoảng cách thì thêm chút nhiễu ngẫu nhiên vào giá trị gốc, tránh nhịp yêu cầu đều tăm tắp.
Trạng thái đăng nhập giữ trong môi trường. Dữ liệu cần đăng nhập mới xem, đăng nhập một lần là Cookie và phiên do môi trường lưu lại, lần mở sau dùng tiếp. Vừa tiết kiệm chi phí xác minh của việc đăng nhập lặp lại, vừa tránh chính thao tác đăng nhập dày đặc trở thành tín hiệu đáng ngờ. Trước khi bắt tay, xác định phạm vi thu thập đã. Giao thức robots và điều khoản dịch vụ quyết định một nhiệm vụ có chạy lâu dài được không, chi tiết giao thức có thể tham khảo mục robots.txt trên MDN, và mục này xếp trước mọi tham số cấu hình.
Dùng Local API nối môi trường vào script thu thập
Môi trường nhiều lên thì bật tắt thủ công từng cái không theo kịp nhịp script. MostMate cung cấp Local API: giao diện cục bộ kèm API key, bật xác minh bảo mật là mỗi yêu cầu phải mang theo Key. Qua đó, script thu thập có thể mở, đóng môi trường, tra trạng thái môi trường, và giao cho code phần quyết định dùng môi trường nào. Cửa sổ đồng bộ, RPA và API hợp cảnh nào thì hướng dẫn chọn giải pháp tự động hóa đa tài khoản đã so sánh; thu thập bằng script thuần chủ yếu nằm ở tuyến API.
Thu thập cấp trang thường dùng framework tự động hóa điều khiển trình duyệt. Cài đặt và làm quen Playwright có đầy đủ trong tài liệu chính thức. Cách ghép rất thẳng: script mở môi trường chỉ định qua Local API trước, framework tự động hóa tiếp quản thao tác trang trong môi trường đó, thu thập xong thì đóng môi trường.
Yêu cầu cấp trang đi ra từ một môi trường trình duyệt trọn vẹn, Cookie, bộ nhớ và tham số fingerprint đều nằm trong môi trường, giữ được đặc điểm đầy đủ hơn hẳn một yêu cầu HTTP trần. Các khái niệm môi trường, proxy, fingerprint liên hệ với nhau trong sản phẩm thế nào, trang MostMate là gì có bài giới thiệu hệ thống; đọc qua trước khi viết script thì hiểu các trường trả về sẽ nhanh hơn nhiều.
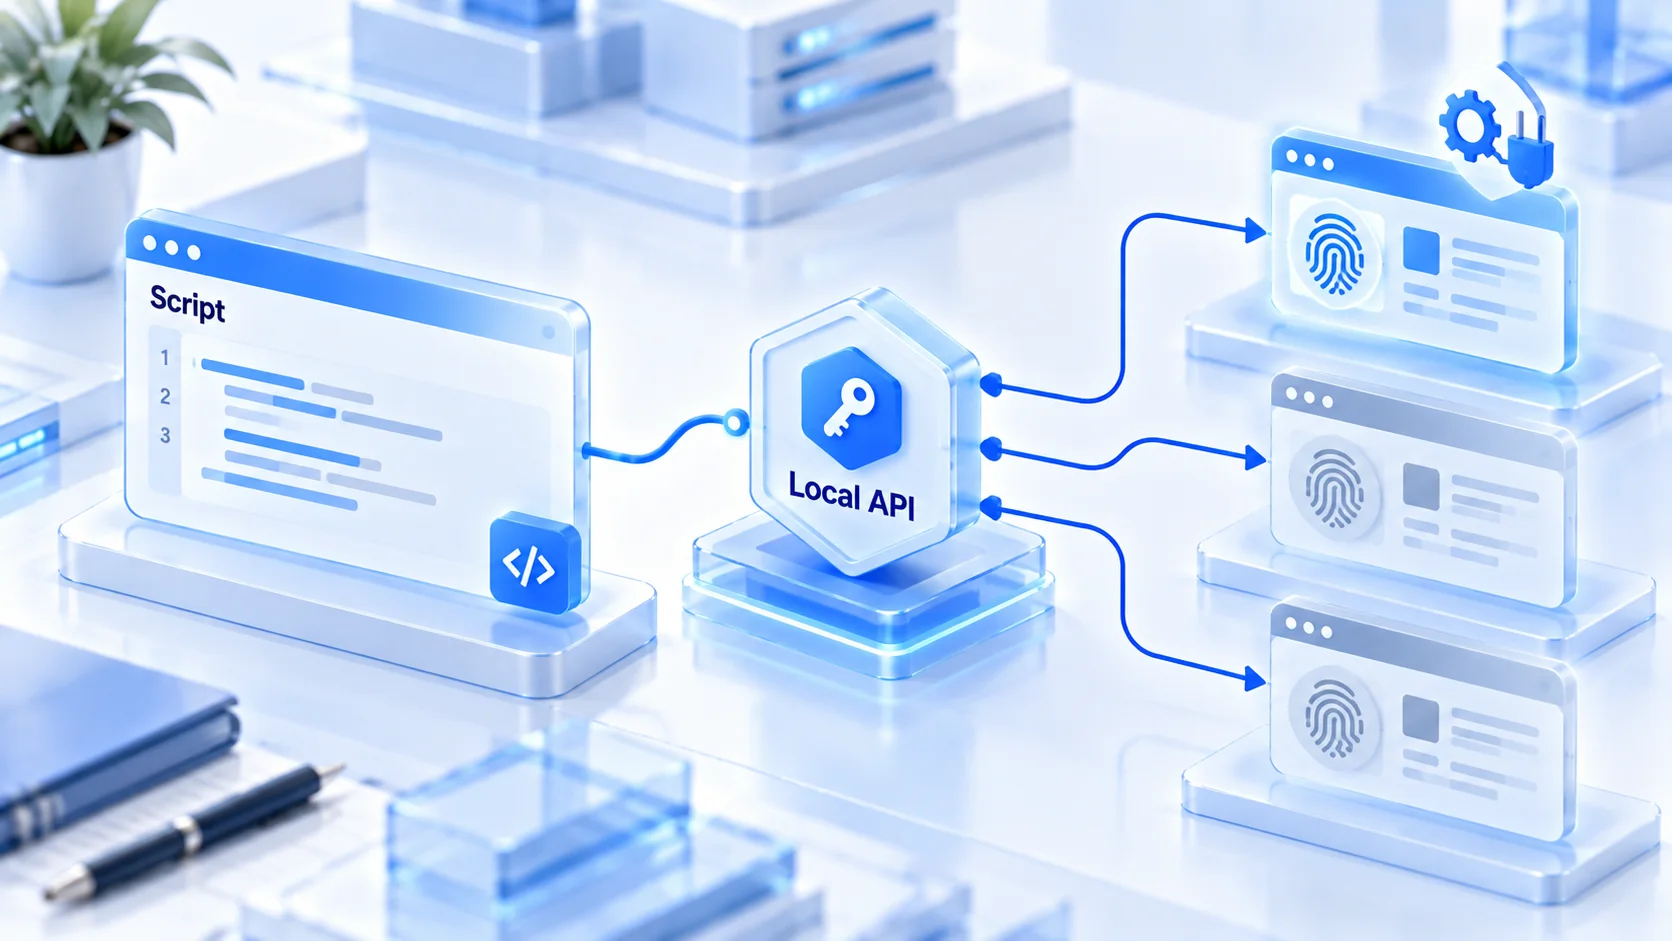
Local API giới hạn số lần gọi theo gói, giao diện ghi rõ mở cho gói từ nửa năm trở lên. Kiểm tra chu kỳ gói trước khi viết script, đừng để dựng xong toàn bộ quy trình mới biết lượt gọi bị giới hạn.
Câu hỏi thường gặp
Mỗi nhiệm vụ thu thập có cần riêng một proxy không?
Đánh giá theo cường độ kiểm soát rủi ro của trang đích và lượng nhiệm vụ. Trang kiểm soát gắt, nhiệm vụ nhiều thì đáng giá một lối ra riêng. Nhiệm vụ nhỏ, tần suất thấp có thể dùng chung một proxy, nhưng tốt nhất các nhiệm vụ dùng chung không dính đến ngành nghề của nhau. Một cái bị gắn cờ thì dễ vạ lây các nhiệm vụ khác cùng lối ra.
Có cần thay tham số fingerprint định kỳ không?
Không cần. Mục tiêu chính là giữ tham số của cùng một môi trường cố định lâu dài, thay liên tục làm đặc điểm thiết bị mất tính liên tục. Chỉ khi đổi lối ra hoặc phát hiện tham số lệch mới đụng tới đúng mục đó.
Dùng requests gọi thẳng không được à?
Với API đơn giản thì được. Các thư viện kiểu requests không chạy script của trang, lấy không được bộ đặc điểm trình duyệt trọn vẹn. Loại thư viện này chỉ hợp với API mở không cần render. Thu thập cấp trang hay trang kiểm soát gắt thì chạy bằng môi trường trình duyệt trọn vẹn sẽ ổn định hơn.
Dữ liệu trả về bỗng trống rỗng, kiểm tra cái gì trước?
Xử lý theo hướng vấn đề tần suất trước. Hạ tần suất quan sát một hai ngày. Vẫn bất thường thì đối chiếu tính nhất quán giữa lối ra và fingerprint, rồi dùng môi trường trình duyệt truy cập thủ công đúng trang đó, để phân biệt trang đổi cấu trúc hay lượt truy cập bị chặn. Đổi lối ra là phương án cuối cùng.
Lời kết
Thu thập chạy lâu được hay không phụ thuộc ba tầng cấu hình cùng đứng vững: lối ra ổn định, fingerprint nhất quán, nhịp tiết chế. Một tầng lệch là chi phí hai tầng còn lại phình to. MostMate gói proxy, fingerprint và trạng thái đăng nhập vào từng môi trường, môi trường chính là đơn vị vận hành của nhiệm vụ, và cùng Local API là nối thẳng vào script thu thập sẵn có.
Muốn dựng nhiệm vụ thu thập đầu tiên, bắt đầu từ tải MostMate, dùng môi trường bản miễn phí chạy thông giám sát một trang nhỏ, rồi sao chép dần sang các nhiệm vụ khác.

MOSTMATE
Quản lý nhiều tài khoản an toàn, thật đơn giản
Bắt đầu với tài khoản đầu tiên và dùng MostMate để xây dựng hoạt động đa tài khoản an toàn, thông minh và hiệu quả hơn.
- Hồ sơ độc lập. Danh tính nhất quán.
- Tự động hóa bằng AI · Tình trạng tài khoản · Vận hành nhóm



