
Jak skonfigurować fingerprint i proxy w web scraperze? Strategia konfiguracji, która ogranicza ryzyko blokady
Wnioski główne: Przyczyny blokad w scrapingu rzadko koncentrują się w jednym punkcie; najczęściej rozkładają się na trzy poziomy: proxy, fingerprint i rytm zbierania danych. Liczy się kolejność konfiguracji, nie liczba parametrów. Najpierw ustabilizuj wyjście proxy dla każdego zadania. Potem nadaj środowisku spójny logicznie zestaw parametrów fingerprintu. Na końcu ściągnij częstotliwość zapytań do poziomu, który strona docelowa akceptuje. Ten artykuł podaje checklistę konfiguracji w tej kolejności i pokazuje, jak przez Local API podłączyć zarządzanie środowiskami do skryptu zbierającego dane.
„Kupiliśmy kilkanaście proxy.” A blokady przychodzą częściej niż wcześniej. Zespoły zajmujące się scrapingiem często wkładają budżet w proxy, ale problem nie musi leżeć w ich liczbie. Zapytania wchodzą i wychodzą z dużą częstotliwością przez to samo wyjście, wszystkie sesje niosą ten sam zestaw cech przeglądarki, a po wyzwoleniu weryfikacji skrypt dalej działa według starego planu. Rozchwianie którejkolwiek z tych warstw potrafi pociągnąć za sobą wszystkie kupione wyjścia.
Jeśli chodzi o formę produktu, MostMate należy do narzędzi typu fingerprint browser: każde konto dostaje niezależne środowisko przeglądarki, a proxy, parametry fingerprintu i stan logowania zarządzane są wewnątrz środowiska. W scenariuszu scrapingu środowisko odpowiada jednostce wykonawczej zadania, a środowiska nie dzielą między sobą wyjść ani cech urządzenia. Proxy decyduje, którą trasą pójdą zapytania, fingerprint decyduje, jakie urządzenie zobaczy strona docelowa. Gdy te dwie warstwy stoją stabilnie, kontrola rytmu dopiero ma pole do popisu.
Sygnały blokady dzielą się na trzy warstwy, i stąd wynika kolejność konfiguracji
Anty-scraping sprawdza wizytę mniej więcej na trzech warstwach. Każda warstwa patrzy na co innego, więc i kroki konfiguracji są inne:
- Warstwa połączenia: strona docelowa najpierw sprawdza, z jakiego IP przyszło zapytanie i jakiego jest typu. Wysoki ruch przez jedno wyjście albo trafienie w oflagowany segment sieci najszybciej kończy się blokadą.
- Warstwa urządzenia: skrypty strony czytają Canvas, WebGL, listę czcionek, strefę czasową i po tym oceniają, czy odwiedzający to prawdziwe, normalne urządzenie.
- Warstwa zachowania: odstępy między zapytaniami, ścieżka wizyty, tempo działań po logowaniu. Długotrwały mechaniczny, jednakowy wzorzec stale podnosi podejrzenia.
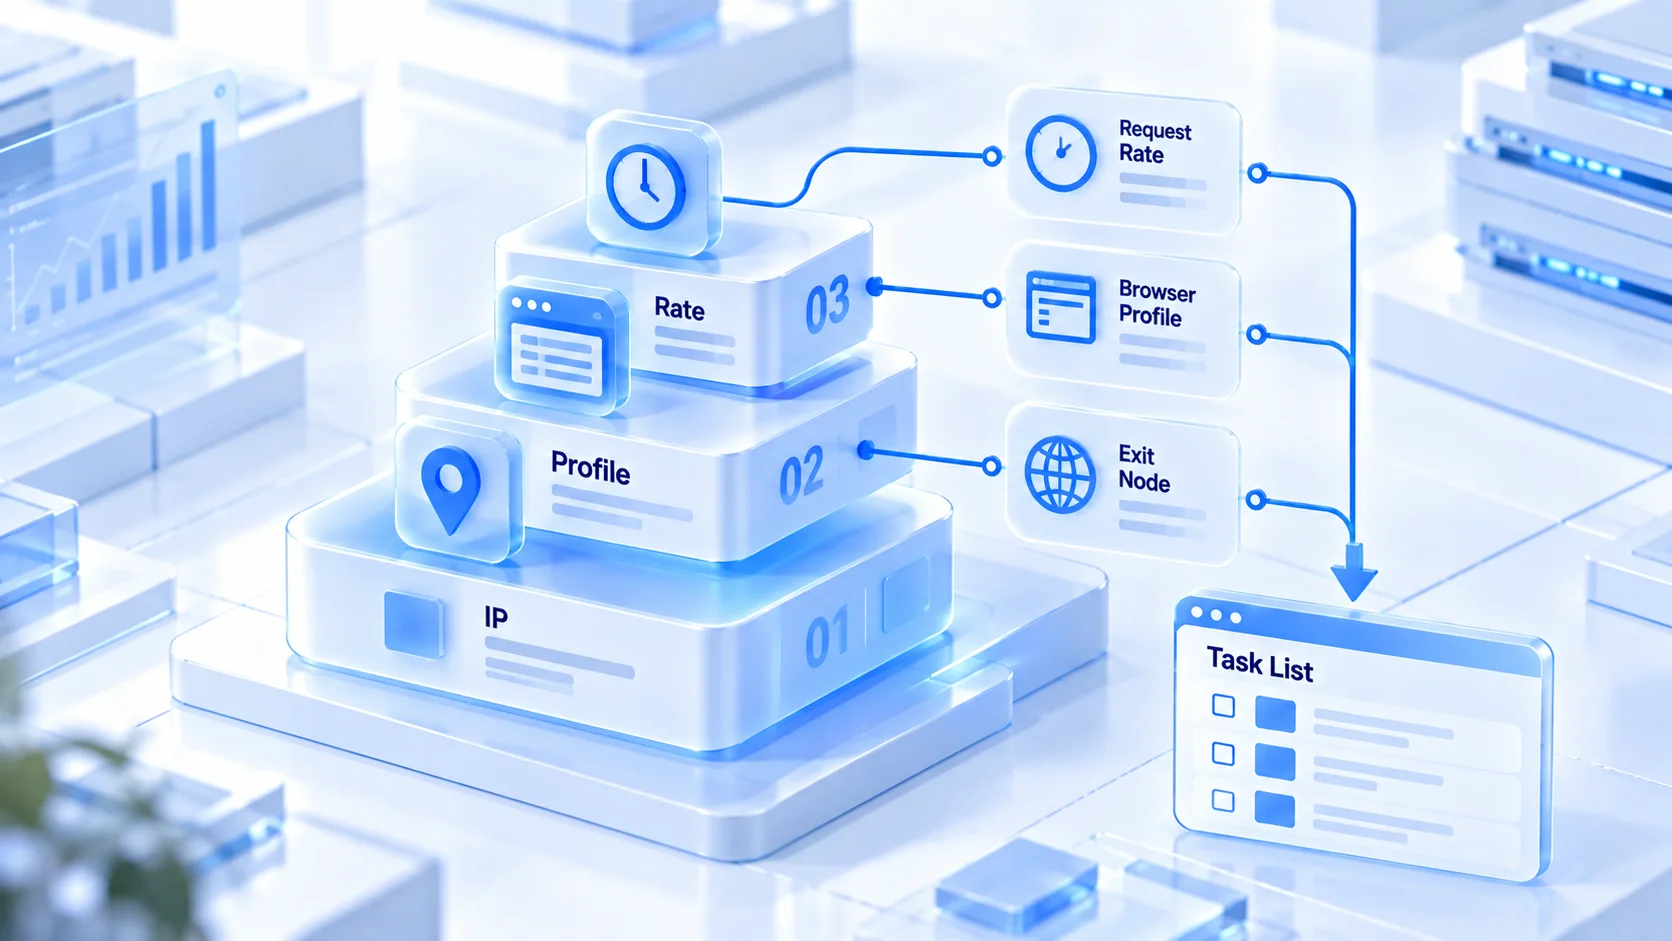
Kolejność rozchwiania warstw wyznacza kolejność konfiguracji. Zanim ustabilizujesz wyjście, parametry związane z IP, jak język, strefa czasowa czy lokalizacja, nie mają się do czego przyczepić; zanim ustalisz cechy urządzenia, jakkolwiek naturalnie byś nie regulował rytmu, strona docelowa nadal widzi tę samą maszynę wchodzącą z dużą częstotliwością. Dlatego kolejność jest taka: najpierw proxy, potem fingerprint, na końcu rytm. Kolejne sekcje idą właśnie tą linią.
Jak skonfigurować proxy: stabilne wyjście ważniejsze niż liczba
Ustalenie dla każdego zadania scrapingu osobnego, stałego wyjścia przybliża stabilny scraping bardziej niż stos rotujących IP. Gdy kilka zadań dzieli jedno wyjście, wystarczy, że jedno naruszy mechanizmy kontroli, a pozostałe na tym samym wyjściu zwykle cierpią razem z nim. Po rozdzieleniu wyjść zadania przynajmniej na warstwie połączenia nie ciągną się nawzajem, a przy szukaniu przyczyny od razu widać, na której trasie jest problem.
Typ wyjścia dobierz do siły kontroli. Przy łagodnych mechanizmach wystarczy koszt datacenter IP. Na dużych sklepach i portalach społecznościowych residential IP zwykle żyje dłużej. Różnicę zaufania, strukturę kosztów i zastosowania obu typów oceniaj na podstawie porównania w poradniku wyboru między residential IP a datacenter IP, nie na wyczucie.
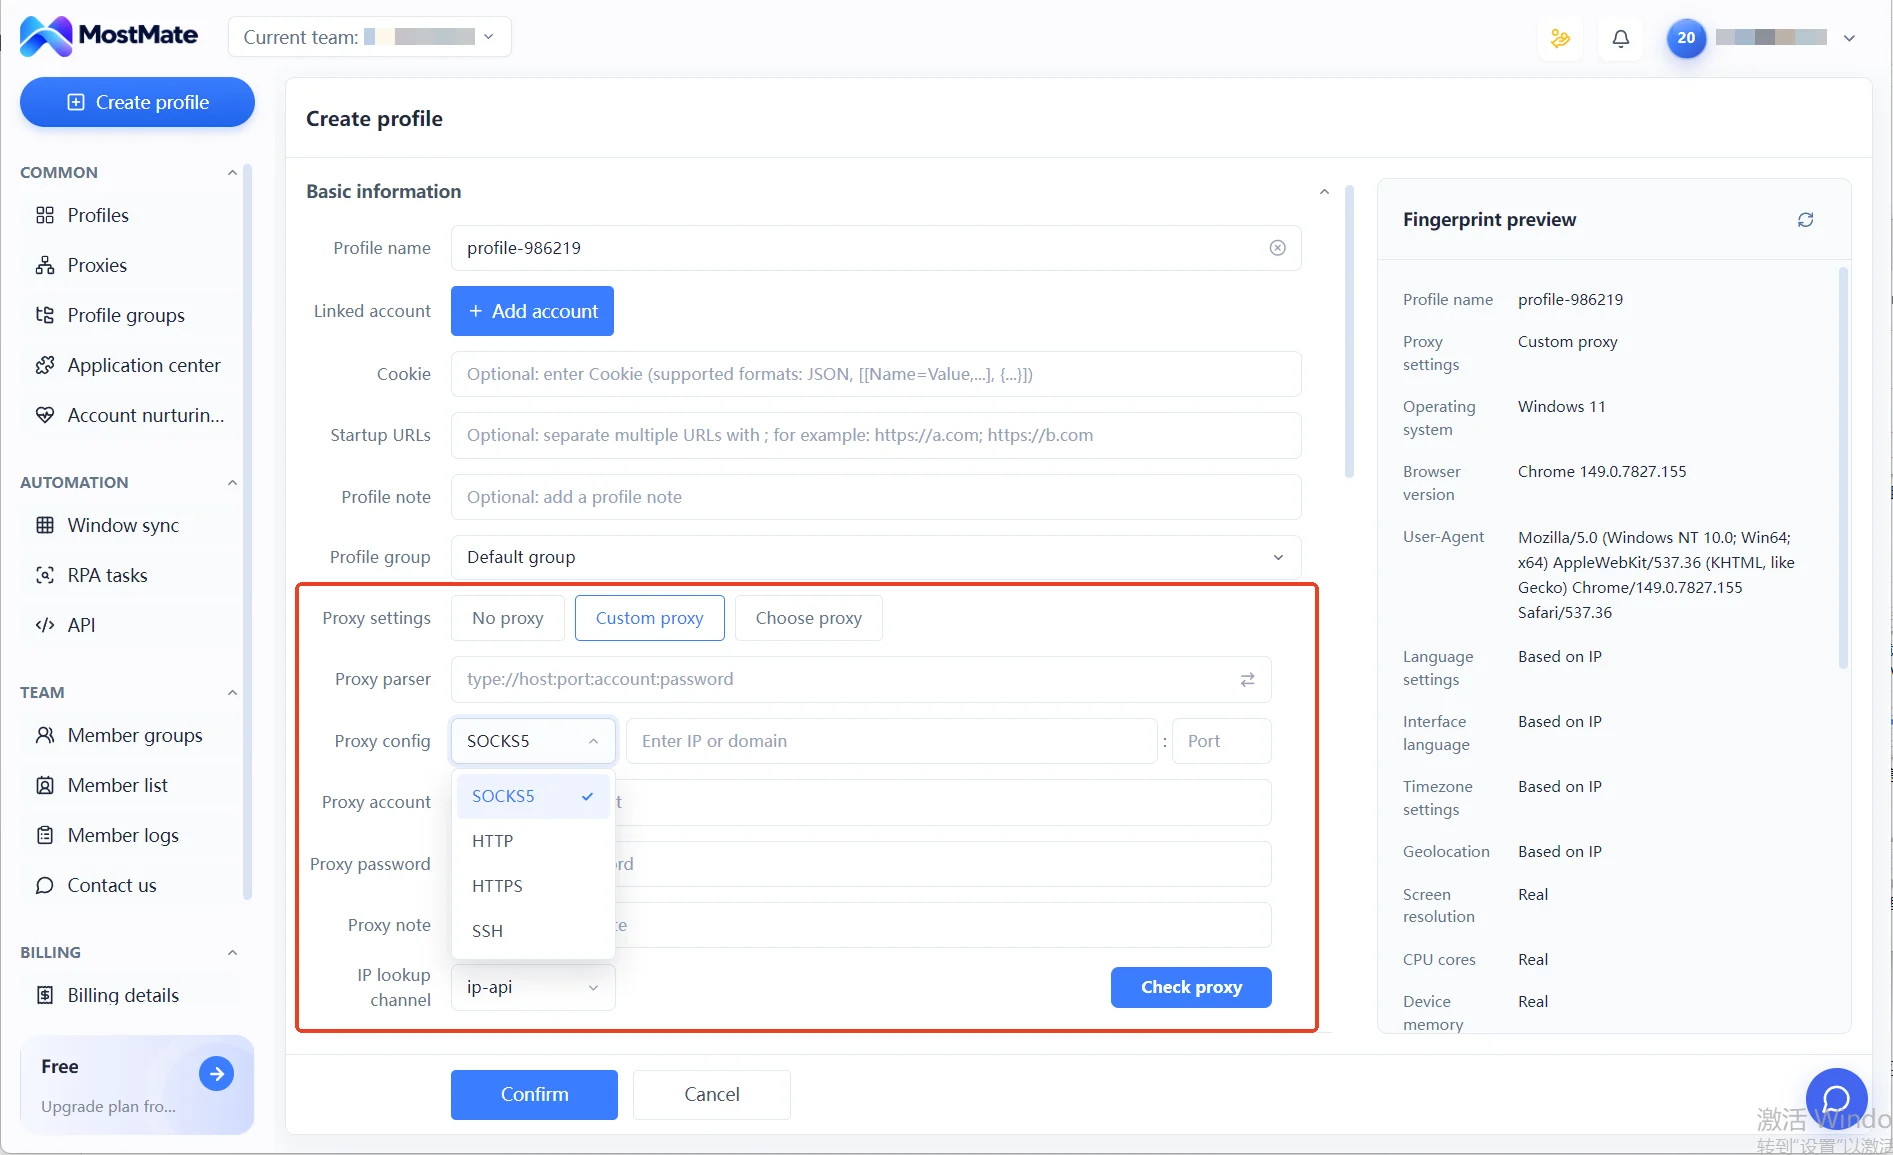
Konkretnie w MostMate proxy prowadzi się osobno na liście proxy. Wszystkie cztery protokoły, HTTP, HTTPS, SOCKS5 i SSH, mają swoje pole, a po wypełnieniu każdego wpisu przyciskiem Check proxy od razu sprawdzisz łączność i przynależność wyjścia. Po pozytywnym teście przypisz proxy do środowiska. Ustawienia proxy w formularzu środowiska mają trzy tryby: brak proxy, własne proxy, wybór z listy proxy. W środowisku scrapingowym polecam trzeci tryb. Wszystkie wyjścia trzymasz na jednej liście, więc od razu widać, które zadanie idzie którą trasą.
Skończysz warstwę proxy, przechodzimy do cech urządzenia.
Jak ustawić parametry fingerprintu: spójność najpierw, losowość z ostrożnością
Cel fingerprintu środowiska scrapingowego: to samo środowisko przez długi czas pokazuje cechy tego samego, normalnego urządzenia. Wokół tego celu parametry dzielą się na dwie grupy: te powiązane z wyjściem oddajesz automatycznemu dopasowaniu, a parametry urządzenia samego utrwalesz w jednym zestawie na długo.
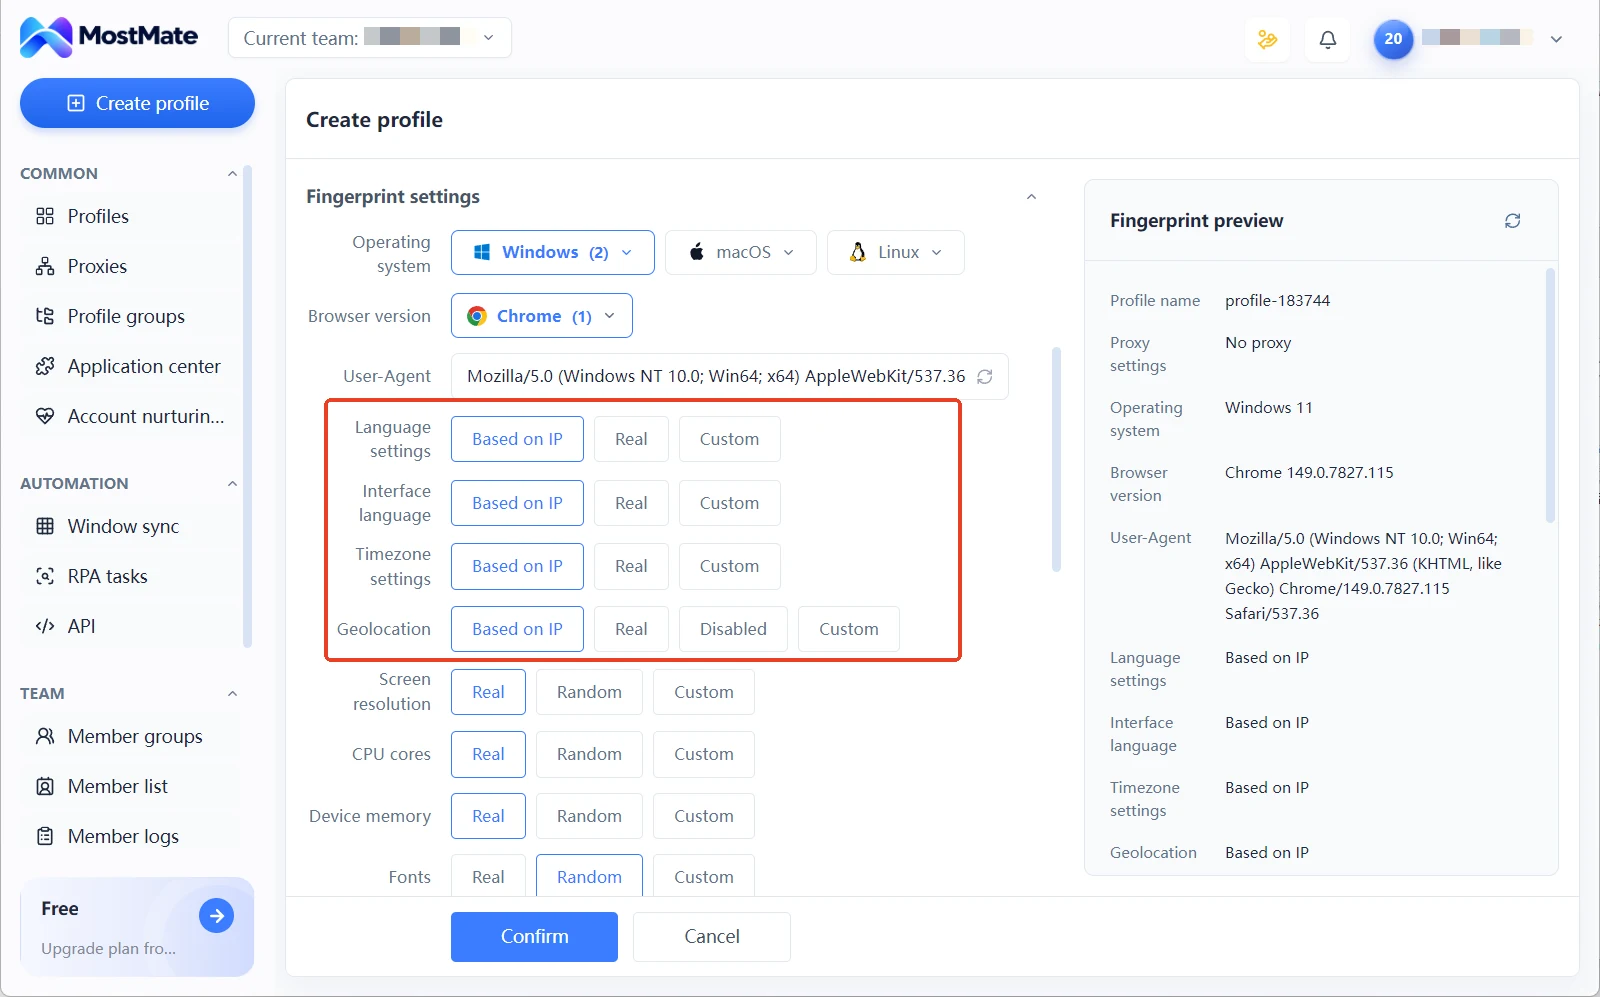
Język, język interfejsu, strefa czasowa i lokalizacja, te cztery pozycje domyślnie działają w trybie konfiguracji na podstawie IP. Jak tylko wyjście jest ustalone, wartości dopasowują się same. Przy zmianie wyjścia oszczędzasz rundę ręcznego sprawdzania. System operacyjny i wersję przeglądarki wybierz jako jedną kombinację i zatrzymaj, UA generuje się z niej i przez cały cykl zadania zostaje. Rozdzielczość ekranu, liczbę rdzeni CPU, pamięć urządzenia i listę czcionek trzymaj na prawdziwych wartościach, zgodnych z deklarowanym systemem.
Sposób traktowania parametrów renderowania zasługuje na osobną uwagę. Canvas, WebGL i podobne wyjścia graficzne oraz audio dostają w interfejsie tryb szumu: do prawdziwej wartości dokłada lekki szum, zachowując przy tym oryginalną logikę urządzenia. Strona sprawdzająca dostaje mimo wszystko wewnętrznie spójny zestaw danych. Dlaczego losowe wartości są wręcz niebezpieczne, zrozumiesz z argumentacji w artykule dlaczego parametry fingerprintu nie powinny być losowe.
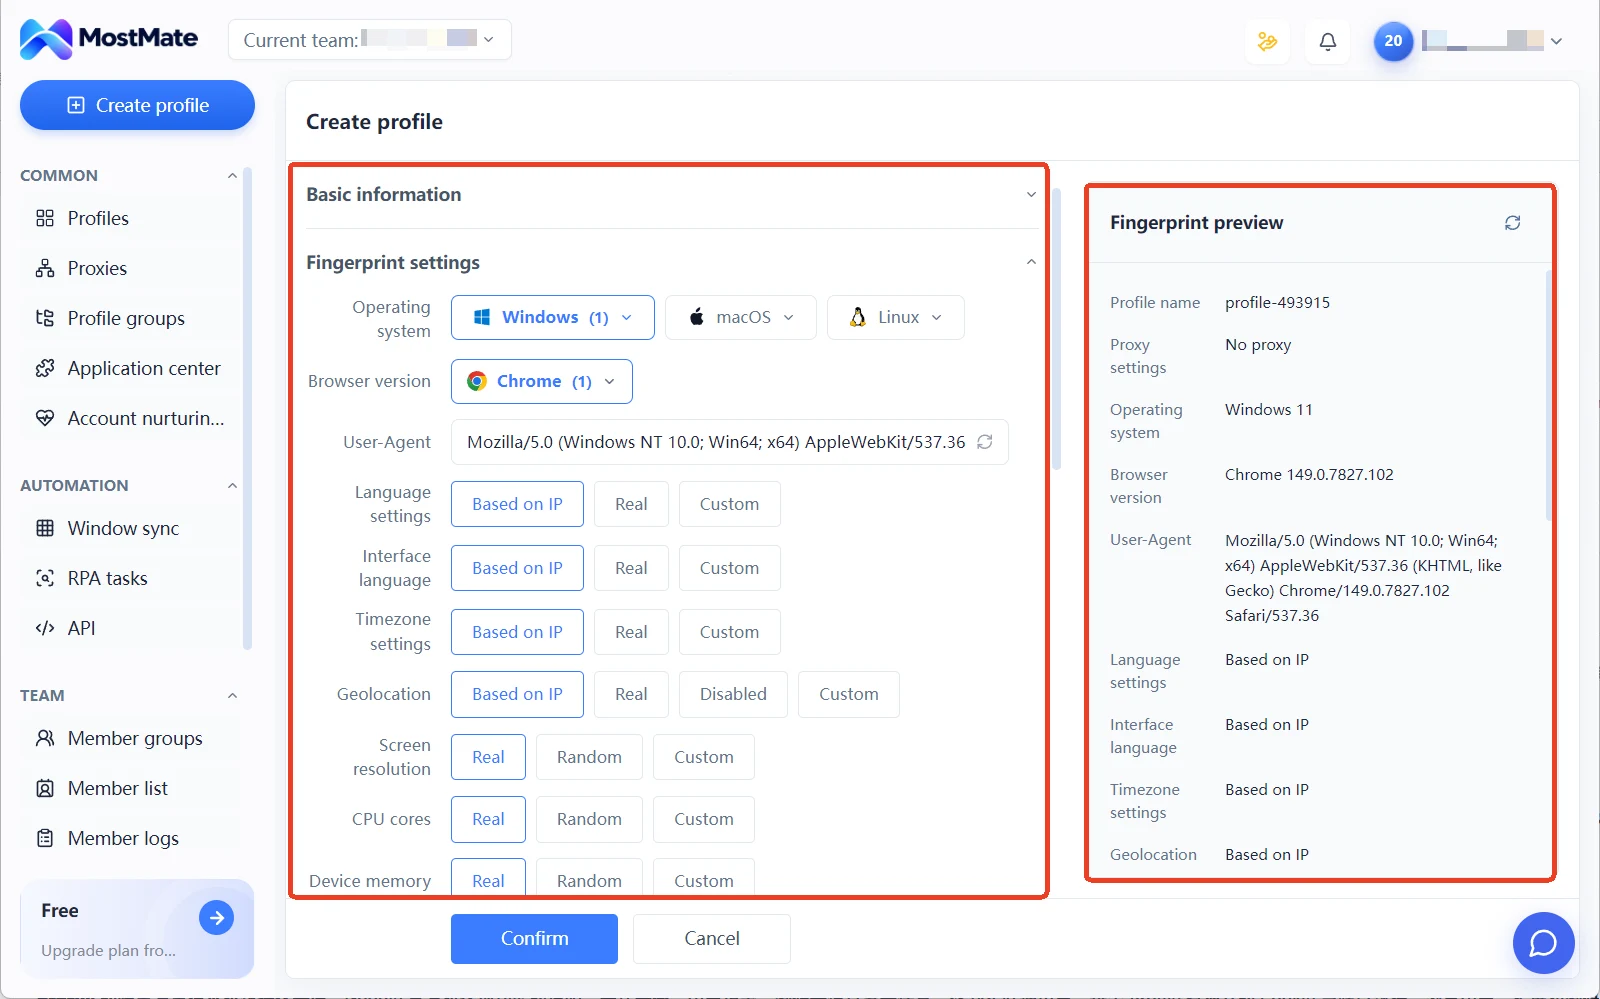
W praktyce środowiska scrapingowego to bardzo konkretne: parametry renderowania na tryb szumu, nie tryb losowy. Po ustawieniu parametrów nie musisz też sprawdzać ich na wyczucie: po prawej stronie formularza tworzenia środowiska jest panel podglądu fingerprintu, gdzie strefa czasowa, poziom Canvas i podobne wartości widnieją obok siebie na żywo. Rzuć okiem przed zapisaniem, ewidentne przesunięcie wyłapiesz od ręki.
Rytm i stan logowania: ogranicz niepewność warstwy zachowania
Próbną rundę nowego zadania możesz przeprowadzić w trzech krokach:
1. Ustal punkt startowy: pojedyncze zapytania równoległe, odstępy rzędu sekund, najpierw przez dzień lub dwa. Notuj, kiedy pojawiają się captche i jaki jest odsetek nietypowych odpowiedzi. 2. Znajdź granicę: gdy tylko pojawi się captcha, wróć o jeden poziom częstotliwości niżej. Ten poziom jest właśnie obecną bezpieczną granicą tego wyjścia. 3. Dopiero potem dodawaj: po kilku dniach stabilnej pracy w granicach zwiększ równoległość o niewielką ilość. Do odstępów dodaj losowy jitter, żeby rytm zapytań nie był idealnie równy.
Stan logowania trzymaj w środowisku. Dane dostępne dopiero po zalogowaniu: po jednym logowaniu Cookie i sesja zostaje zachowana w środowisku. Przy następnym otwarciu kontynuuje się od tego miejsca. Oszczędzasz koszty weryfikacji przy powtarzanych logowaniach, a samo częste logowanie nie staje się podejrzanym sygnałem. Zanim zaczniesz, ustal zakres scrapingu. Protokół robots i regulamin decydują, czy zadanie może chodzić długo; szczegóły protokołu znajdziesz w haśle robots.txt na MDN. Ten punkt stoi przed wszystkimi parametrami konfiguracji.
Podłącz środowiska do skryptu przez Local API
Gdy środowisk przybywa, ręczne włączanie i wyłączanie nie nadąża za tempem skryptu. MostMate daje Local API: interfejs lokalny plus klucz API, po włączeniu weryfikacji bezpieczeństwa każde zapytanie musi nieść ze sobą Key. Skrypt scrapingowy może przez to uruchamiać i zamykać środowiska, odpytywać ich status i przekazać kodowi decyzję, w którym środowisku zadanie ma iść. Porównanie tego, do czego pasują window sync, RPA i API, znajdziesz w poradniku wyboru automatyzacji wielu kont; czysto skryptowy scraping odpowiada głównie linii API.
Scraping na poziomie strony często prowadzi przeglądarkę przez framework automatyzacji; instalację i start z Playwright opisuje oficjalna dokumentacja. Sposób współpracy jest prosty: skrypt najpierw przez Local API otwiera wskazane środowisko, potem framework przejmuje operacje na stronach w tym środowisku, a po zakończeniu zbierania środowisko zostaje zamknięte.
Zapytania o strony wychodzą z pełnego środowiska przeglądarki, Cookie, pamięć i parametry fingerprintu zostają w środowisku, więc zachowanych cech jest znacznie więcej niż przy gołych zapytaniach HTTP. Całościowe relacje pojęć środowisko, proxy i fingerprint w produkcie systematycznie opisuje strona czym jest MostMate; przeczytaj ją przed pisaniem skryptu, a pola odpowiedzi interfejsu zaczną się szybko układać.
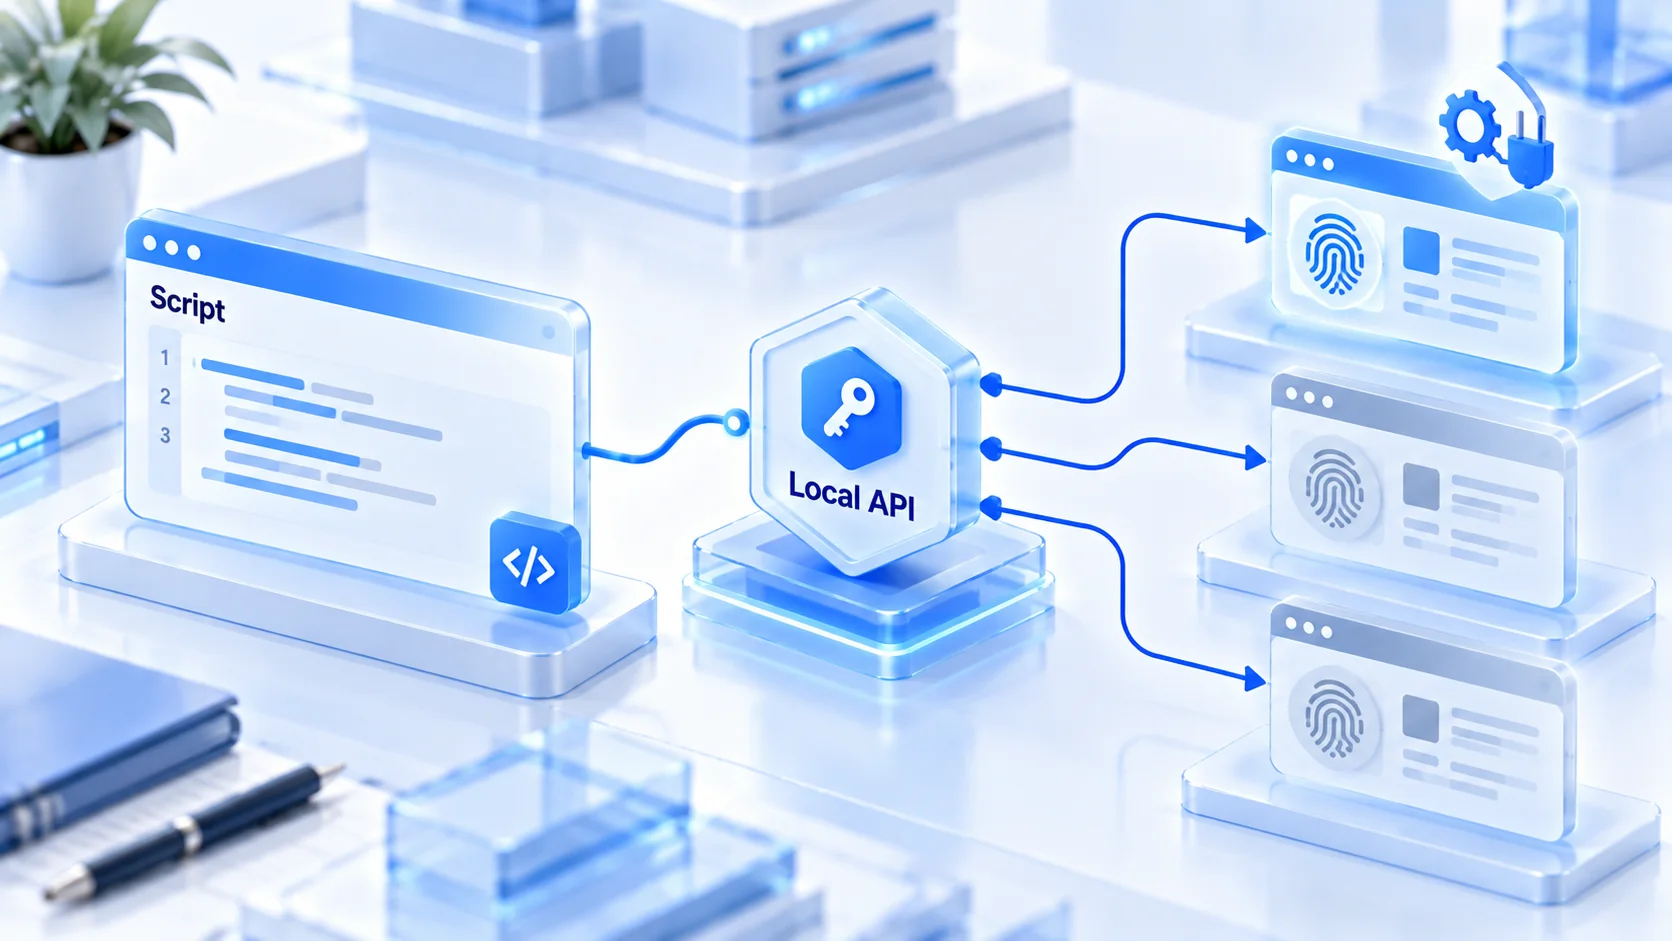
Liczba wywołań Local API zależy od progu pakietu, interfejs oznacza, że dostępne od pakietów półrocznych i dłuższych. Zanim napiszesz skrypt, sprawdź cykl pakietu, żeby nie okazało się po zbudowaniu procesu, że wywołania są limitowane.
Częste pytania
Czy każde zadanie scrapingu potrzebuje osobnego proxy?
Oceniaj według siły kontroli strony i wolumenu zadań. Przy surowej kontroli i ciężkich zadaniach warto mieć wyjście na wyłączność. Rzadkie drobne zadania mogą dzielić jedno wyjście, ale lepiej, by dzielące zadania były biznesowo niezwiązane. Jedno oflagowane łatwo pociąga pozostałe na tym samym wyjściu.
Czy parametry fingerprintu trzeba okresowo wymieniać?
Nie. Celem jest właśnie to, by parametry jednego środowiska długo pozostały stałe; częsta wymiana psuje ciągłość cech urządzenia. Ruszaj tylko tę pozycję, której dotyczy zmiana wyjścia albo wykryte rozjechanie parametrów.
Czy nie wystarczą bezpośrednie zapytania przez requests?
Proste API tak. Biblioteki typu requests nie wykonują skryptów strony, więc nie zbierzesz przez nie pełnych cech przeglądarki. Takie biblioteki pasują tylko do otwartych API niewymagających renderowania. Scraping na poziomie strony albo surowsze mechanizmy kontroli bezpieczniej prowadzić w pełnym środowisku przeglądarki.
Dane nagle wracają puste. Co sprawdzić najpierw?
Najpierw traktuj to jak problem częstotliwości. Zmniejsz tempo i obserwuj dzień lub dwa. Gdy dalej jest nieprawidłowo, zweryfikuj spójność wyjścia i fingerprintu, potem otwórz tę samą stronę ręcznie w środowisku przeglądarki. Odróżnisz, czy zmieniła się struktura strony, czy wizyty są blokowane. Dopiero na końcu rozważ wymianę wyjścia.
Podsumowanie
Czy scraping pójdzie długo, zależy od tego, czy konfiguracja trzech warstw stoi jednocześnie: stabilne wyjście, spójny fingerprint, wstrzemięźliwy rytm. Rozchwianie którejkolwiek warstwy mnoży koszty pozostałych dwóch. MostMate zbiera proxy, fingerprint i stan logowania w każdym środowisku; środowisko jest jednostką wykonawczą zadania, a z Local API podłączysz to wprost do istniejącego skryptu scrapingowego.
Chcesz zbudować pierwsze zadanie scrapingu: zacznij od pobrania MostMate, przeprowadź monitoring jednej małej strony na środowiskach wersji darmowej, a potem stopniowo przenoś to na kolejne zadania.

MOSTMATE
Bezpieczne zarządzanie wieloma kontami, bez komplikacji
Zacznij od pierwszego konta i z MostMate buduj bezpieczniejsze, inteligentniejsze i wydajniejsze operacje obejmujące wiele kont.
- Niezależne profile. Spójne tożsamości.
- Automatyzacja AI · Kondycja kont · Praca zespołowa



