
Fingerprint en proxy instellen voor web scraping? De configuratieaanpak die het risico op blokkades verkleint
Kernconclusie: De oorzaken van een blokkade bij scraping zitten zelden op één punt; meestal spreiden ze zich over drie lagen: proxy, fingerprint en scraptempo. De volgorde van configureren is belangrijker dan het aantal parameters. Zet eerst het proxy-exitpunt van elke taak vast. Geef elke omgeving daarna een logisch consistente set fingerprintparameters. Druk tot slot de requestfrequentie terug naar een niveau dat de doelsite accepteert. Dit artikel geeft in die volgorde een configuratiechecklist en laat zien hoe je omgevingsbeheer via Local API in je scraping-script koppelt.
“Twaalf proxies gekocht.” Toch komen de blokkades sneller dan ooit. Teams die scrapen steken het budget vaak in proxies, maar het probleem hoeft niet in het aantal te zitten. Requests gaan met hoge frequentie in en uit hetzelfde exitpunt, alle sessies dragen dezelfde browserkenmerken, en na een captcha blijft het script gewoon op het oude plan lopen. Eén laag uit balans is genoeg om alle gekochte exits mee omlaag te trekken.
Wat het product betreft, valt MostMate in de categorie fingerprintbrowsers: elk account krijgt een eigen browseromgeving, en proxy, fingerprintparameters en loginstatus worden binnen die omgeving beheerd. In een scrapingscenario is een omgeving de werkeenheid van één taak, en omgevingen delen geen exit en geen apparaatkenmerken. De proxy bepaalt via welke lijn requests naar buiten gaan, de fingerprint bepaalt welk apparaat de doelsite ziet. Pas als die twee lagen stabiel staan, krijgt tempocontrole ruimte om iets te doen.
De signalen van blokkade situeren zich op drie lagen, en dat bepaalt de configuratievolgorde
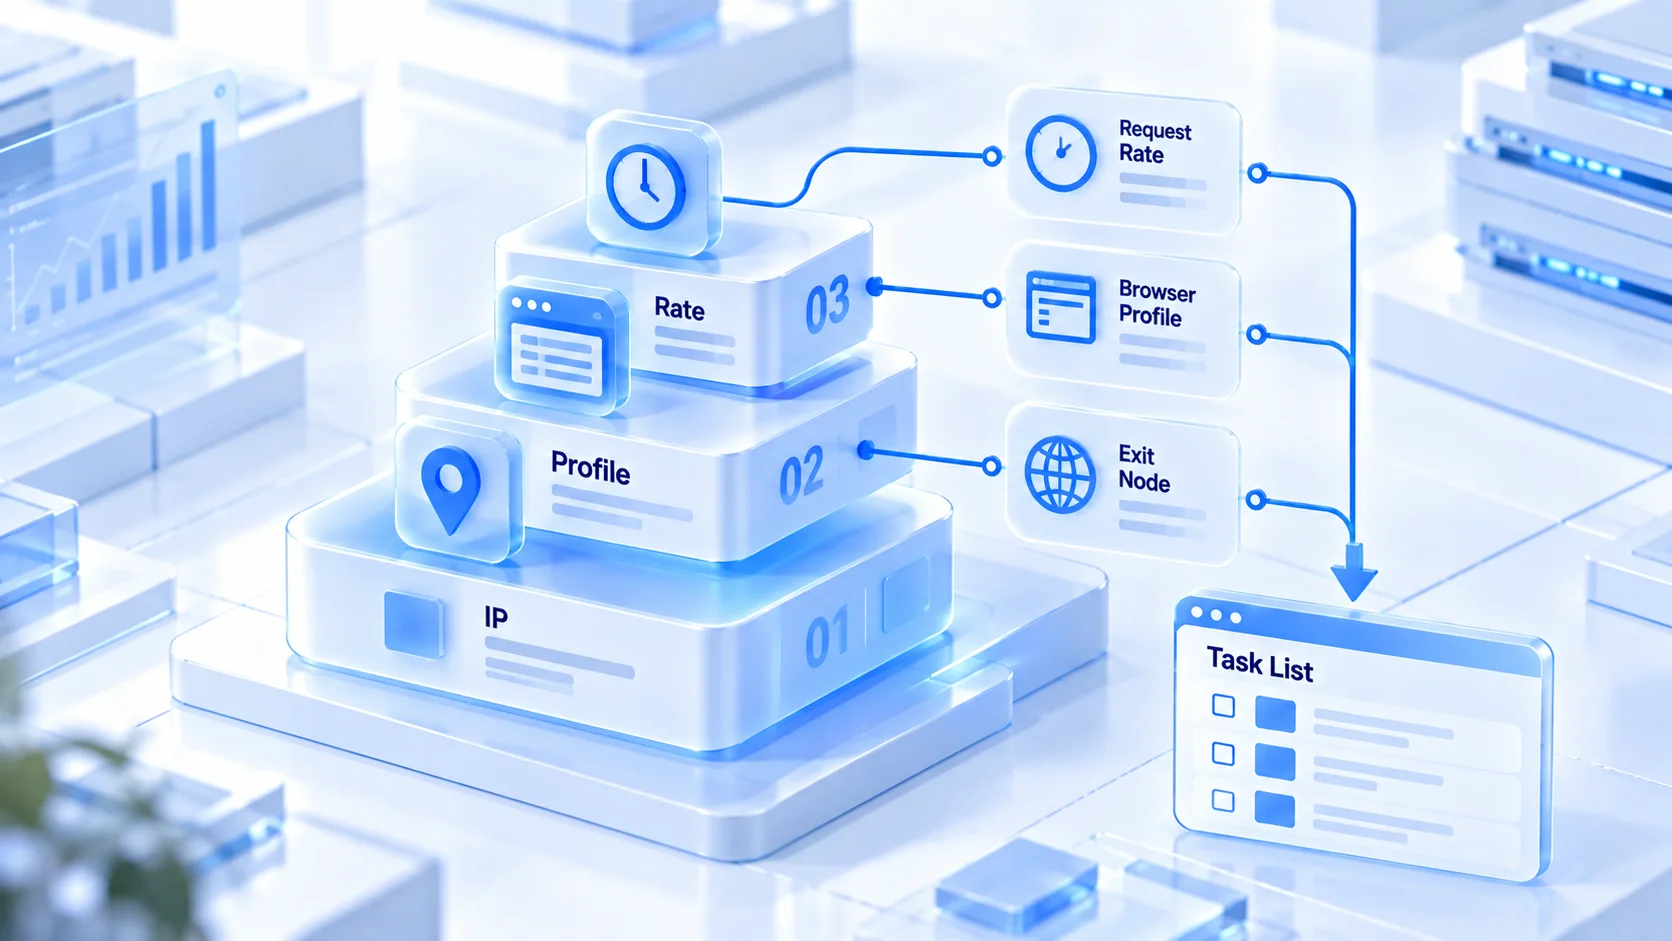
Anti-scraping controleert een bezoek grofweg langs drie lagen. Elke laag kijkt naar iets anders, dus de configuratiestappen verschillen ook:
- Verbindingslaag: de doelsite kijkt eerst vanaf welk IP het request komt en van welk type het is. Hoogfrequent verkeer door één exit of belanden in een gemarkeerd netwerksegment wordt het snelst tegengehouden.
- Apparaatlaag: paginascripts lezen Canvas, WebGL, lettertypelijst, tijdzone en dergelijke en beoordelen of de bezoeker een echt, normaal apparaat is.
- Gedragslaag: interval tussen requests, bezoekpad, actietempo na het inloggen. Langdurig mechanisch gelijkpatroon houdt de argwaan voortdurend hoog.
De volgorde waarin de lagen uit balans raken, bepaalt de configuratievolgorde. Zonder vastgelegde exit hebben taal, tijdzone en locatie, parameters die aan het IP hangen, nergens houvast; zonder vastgelegde apparaatkenmerken ziet de doelsite, hoe natuurlijk je het tempo ook maakt, nog steeds dezelfde machine met hoogfrequente bezoeken. De volgorde is dus: eerst proxy, dan fingerprint, ten slotte tempo. De volgende secties volgen die lijn.
Proxy configureren: een stabiele exit telt zwaarder dan het aantal
Voor elke scrapingtaak één eigen vaste exit kiezen komt dichter bij stabiel scrapen dan een stapel roterende IP's. Delen meerdere taken één exit, dan wordt als één taak de riskcontrole triggert vaak het hele exitpunt meegetrokken. Zodra de exits gescheiden zijn, trekken taken elkaar op zijn minst op verbindingsniveau niet meer mee, en bij troubleshooting zie je direct op welke lijn het probleem zit.
Kies het exittype naar de strengheid van de riskcontrole. Bij soepele controles is de prijs van datacenter-IP's genoeg. Op grote webshops en social media leeft residential-IP doorgaans langer. Het verschil in vertrouwen, de kostenstructuur en de toepassingsgebieden van beide typen beoordeel je met de vergelijking in de gids voor kiezen tussen residential- en datacenter-IP, niet op gevoel.
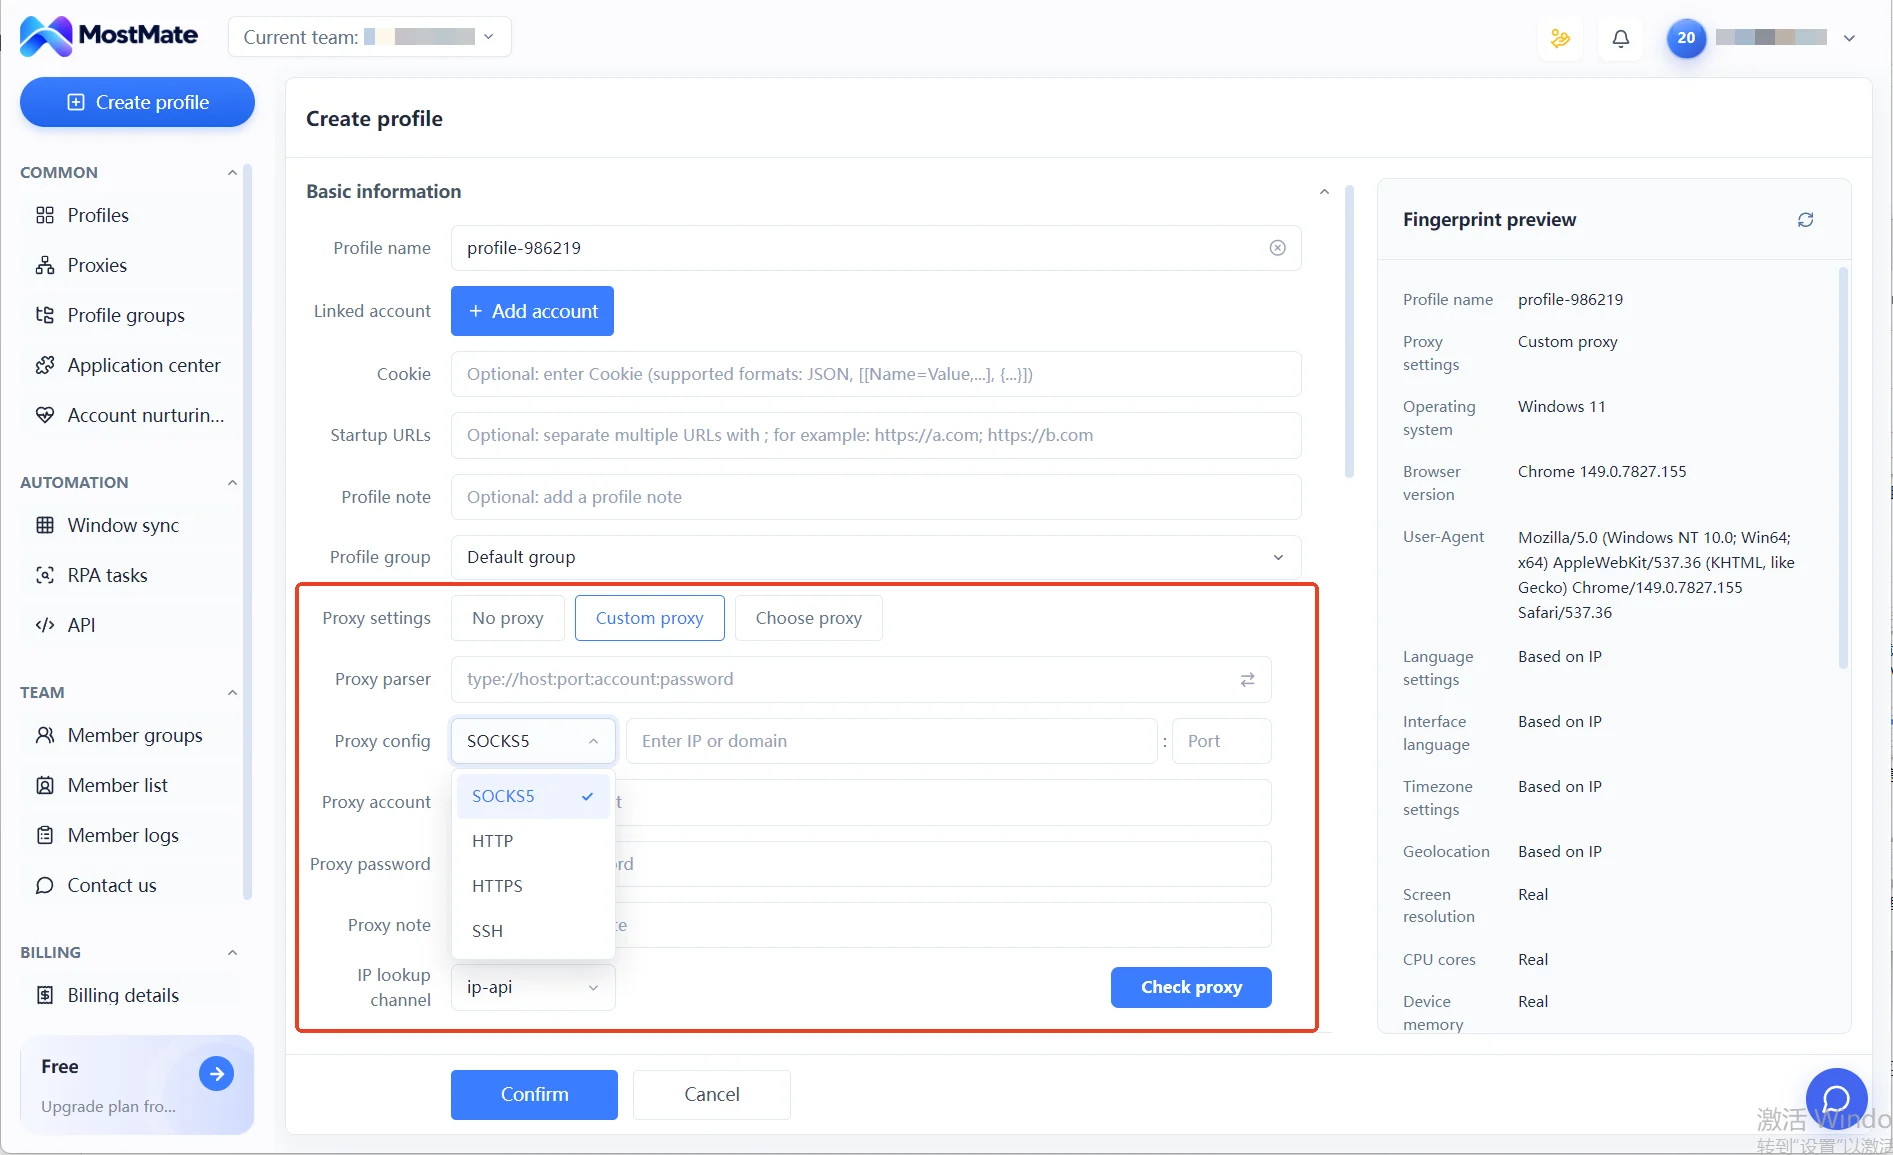
Bij MostMate beheer je proxies apart in de proxybeheerlijst. Voor alle vier de protocollen, HTTP, HTTPS, SOCKS5 en SSH, is er een invoerveld, en elk ingevulde proxy test je met de knop Check proxy direct op bereikbaarheid en op welk exit-IP eruit komt. Na een geslaagde test wijs je de proxy toe aan een omgeving. De proxy-instelling in het omgevingsformulier kent drie standen: geen proxy, eigen proxy, proxy uit de lijst kiezen. Voor een scrapeomgeving is de derde stand aan te raden. Alle exits staan centraal in de lijst, dus in één oogopslag is te zien welke taak op welke lijn loopt.
Is de proxylaag afgerond, dan volgen de apparaatkenmerken.
Fingerprintparameters bepalen: consistentie eerst, randomiseren met voorzichtigheid
Het fingerprintdoel van een scrapeomgeving: dezelfde omgeving toont lange tijd de kenmerken van hetzelfde, normale apparaat. Rond dat doel vallen parameters in twee groepen: wat aan de exit hangt laat je automatisch uitlijnen, en de apparaateigen parameters zet je vast als één set die lang niet meer verandert.
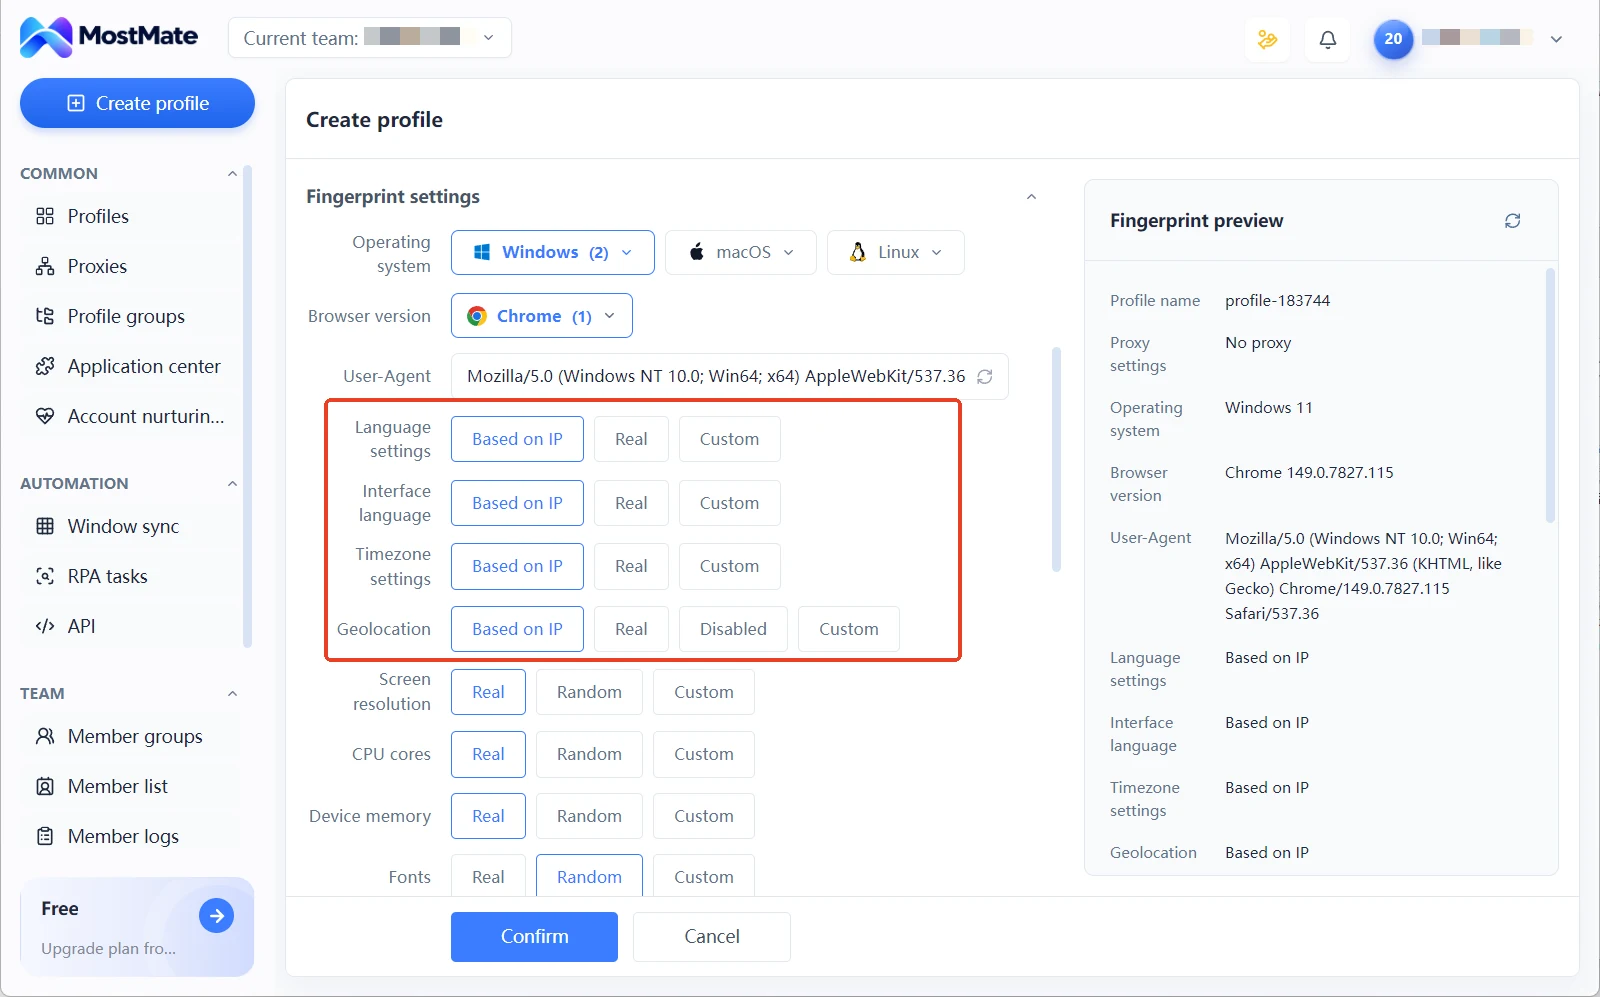
Taalinstelling, interfacetaal, tijdzone en locatie: deze vier staan standaard op configuratie op basis van IP. Zodra de exit vastligt, schuiven de waarden vanzelf mee. Bij een wissel van exit bespaar je een ronde handmatige controle. Kies één combinatie van besturingssysteem en browserversie en zet die vast; de UA volgt daaruit en verandert gedurende de hele taak niet. Houd schermresolutie, aantal CPU-kernen, apparaatgeheugen en de lettertypelijst op echte waarden, afkomstig uit hetzelfde systeem als het aangegeven.
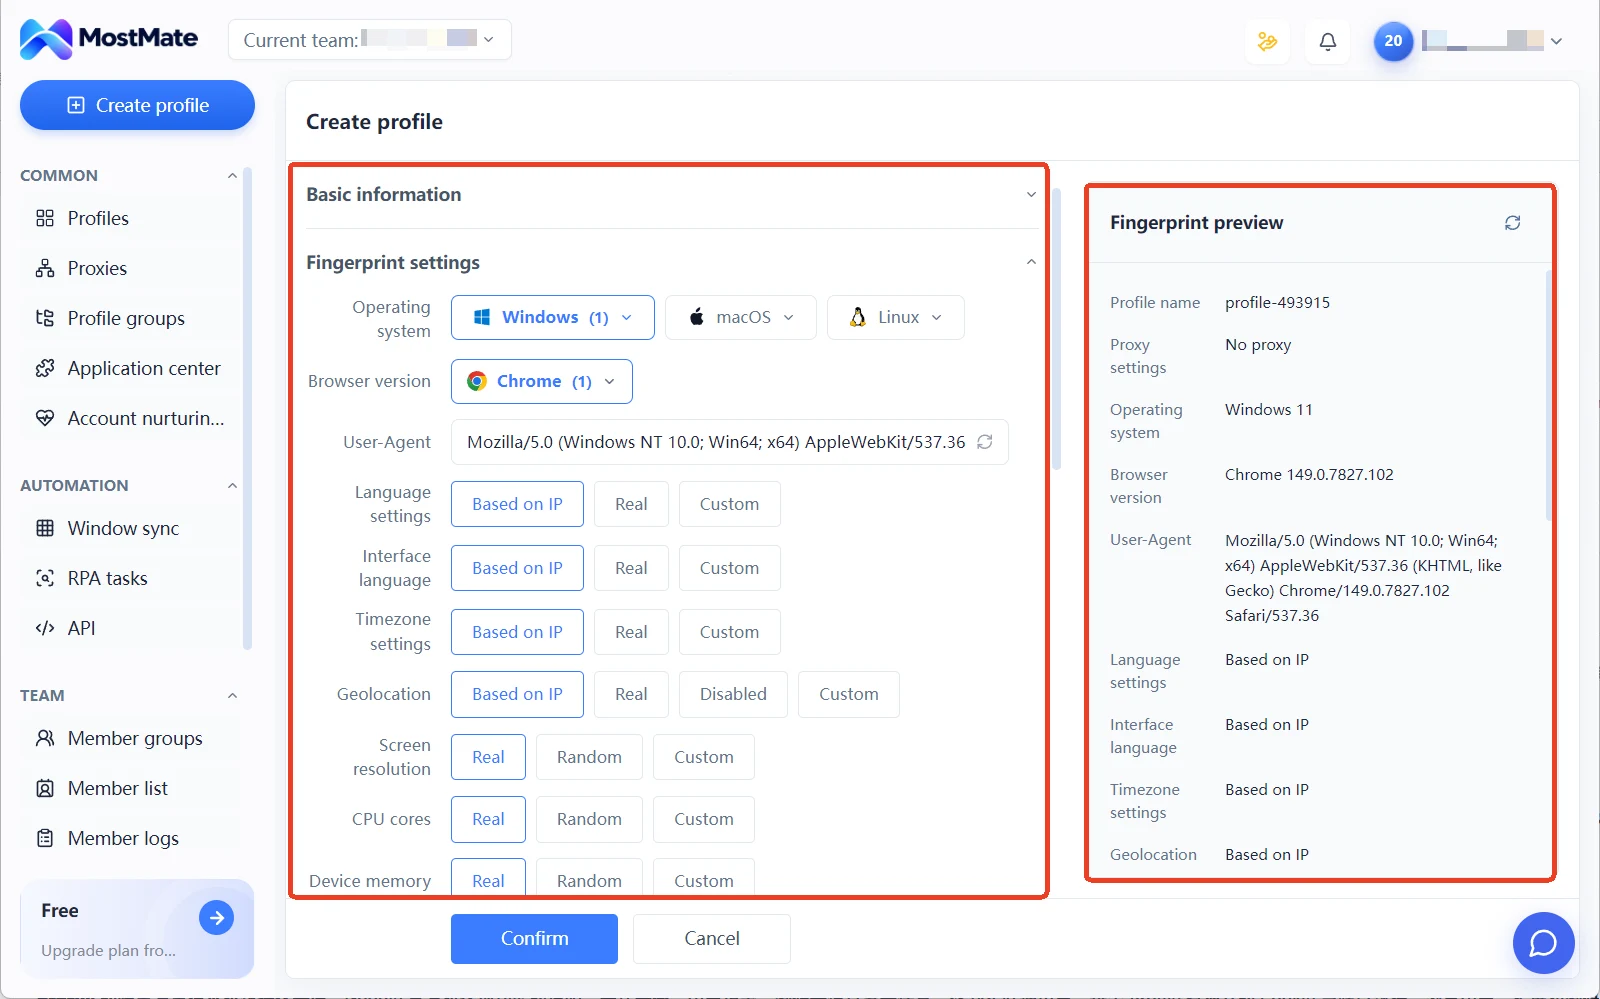
De omgang met renderingparameters verdient extra aandacht. Canvas, WebGL en dergelijke beeld- en audio-uitvoer krijgt in de interface de ruismodus: op de echte waarde komt een lichte verstoring, terwijl de oorspronkelijke logica van het apparaat behouden blijft. Wie detecteert, krijgt nog steeds een zelfconsistent geheel. Waarom willekeurige waarden juist gevaarlijk zijn, lees je in de onderbouwing van waarom fingerprintparameters niet willekeurig mogen zijn.
Voor een scrapeomgeving is de aanpak concreet: kies voor renderingparameters de ruismodus, niet de willekeurige modus. Na het instellen hoef je ook niet op gevoel te controleren: rechts in het formulier voor een nieuwe omgeving zit het fingerprint-previewpaneel, waar tijdzone, Canvas-stand en dergelijke waarden live onder elkaar staan. Gooi voor het opslaan een blik erover, opvallende misstanden vang je meteen.
Tempo en loginstatus: haal de onzekerheid uit de gedragslaag
Een proefrun van een nieuwe taak kun je in drie stappen doen:
1. Bepaal het startpunt: een klein aantal parallelle requests, seconden als interval, eerst een dag of twee draaien. Noteer wanneer captchas opduiken en hoe groot het aandeel afwijkende antwoorden is. 2. Zoek de grens: zodra er een captcha opduikt, stap je een niveau terug in frequentie. Dat niveau is de huidige veilige grens van deze exit. 3. Pas daarna opbouwen: draait het binnen de grens enkele dagen stabiel, verhoog dan de gelijktijdigheid met een klein stapje. Voeg op de basisinterval wat willekeurige jitter toe, zodat het requestritme niet keurig gelijkmatig is.
Houd de loginstatus binnen de omgeving. Voor gegevens die pas na het inloggen zichtbaar zijn, geldt: log één keer in, daarna bewaart de omgeving Cookie en sessie. Bij het volgende openen gaat het daar gewoon verder. Je bespaart de verificatiekosten van herhaald inloggen, en het veelvuldige inloggen zelf wordt geen verdacht signaal. Bepaal vóór je begint de reikwijdte van je scraping. Het robots-protocol en de voorwaarden bepalen of een taak lang kan blijven lopen; voor de details van het protocol kun je het artikel over robots.txt op MDN raadplegen. Dat punt staat vóór alle configuratieparameters.
Koppel omgevingen via Local API aan je scraping-script
Worden het veel omgevingen, dan houden handmatig aan- en uitzetten het tempo van het script niet bij. MostMate biedt Local API: een lokaal interface plus API-sleutel; na het inschakelen van de securitycontrole moet elk request de Key meedragen. Je script kan er omgevingen mee starten en stoppen, hun status opvragen en de beslissing in welke omgeving gedraaid wordt aan de code overlaten. Voor wat window sync, RPA en API elk geschikt zijn, staat een vergelijking in de gids voor automatisering van meerdere accounts; puur scriptmatig scrapen hoort vooral bij de API-route.
Scraping op paginaniveau stuurt de browser vaak aan met een automationframework; de installatie en eerste stappen van Playwright staan compleet in de officiële documentatie. De samenwerking is eenvoudig: het script opent eerst via Local API de gekozen omgeving, daarna neemt het framework de pagina-acties binnen die omgeving over, en na afronden wordt de omgeving gesloten.
Paginarequests vertrekken vanuit de volledige browseromgeving, Cookie, opslag en fingerprintparameters blijven in de omgeving, dus de behouden kenmerken zijn veel completer dan bij kale HTTP-requests. Hoe omgeving, proxy en fingerprint zich in het product tot elkaar verhouden, beschrijft de pagina wat is MostMate systematisch; lees die eerst door voordat je gaat scripten, dan begrijp je de velden in de API-antwoorden veel sneller.
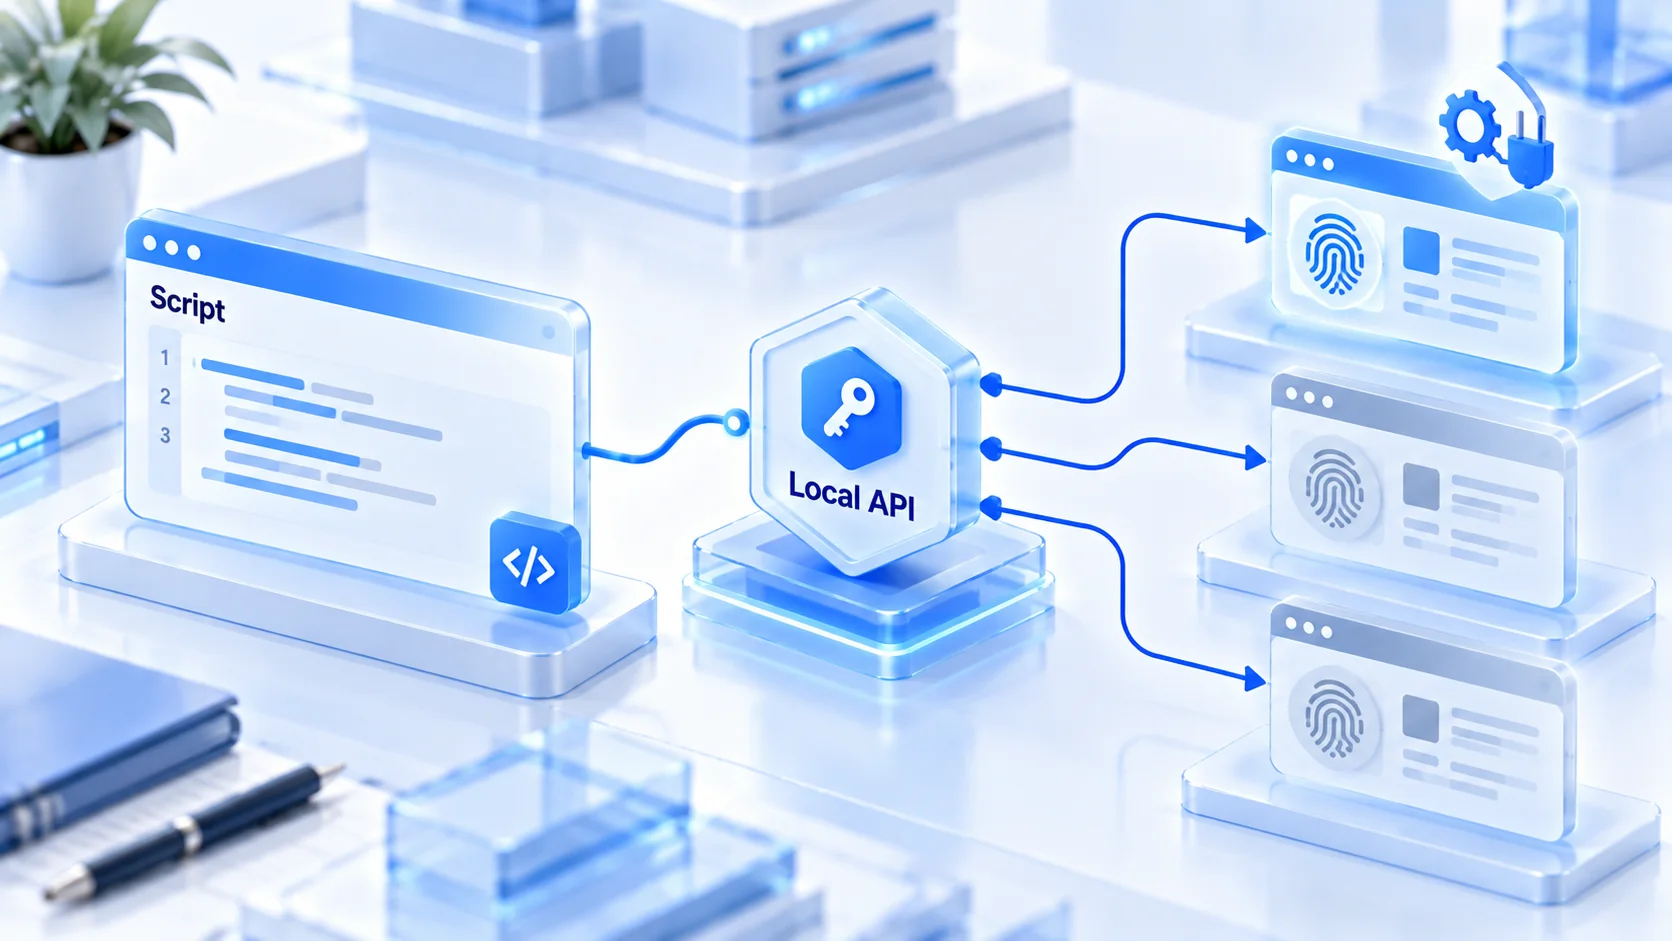
Het aantal Local API-aanroepen kent een pakketdrempel; in de interface staat dat het openstaat voor pakketten van een halfjaar of langer. Controleer vóór het schrijven van je script de pakketperiode, zodat je niet achteraf merkt dat de aanroepen beperkt zijn.
Veelgestelde vragen
Heeft elke scrapingtaak een eigen proxy nodig?
Oordeel naar de strengheid van de riskcontrole van de doelsite en het taakvolume. Bij strenge controles en zware taken is een exit voor eigen gebruik het waard. Kleine taken met lage frequentie kunnen één exit delen, maar delen werkt het best als de taken zakelijk niets met elkaar te maken hebben. Wordt er één gemarkeerd, dan trekken de andere taken op hetzelfde exitpunt gemakkelijk mee.
Moeten fingerprintparameters periodiek worden vervangen?
Nee. Juist het doel is dat de parameters van één omgeving lang vast blijven; vaak wisselen maakt de apparaatkenmerken onsamenhangend. Raak alleen dat ene item aan als de exit wisselt of als een parameter verkeerd lijkt te staan.
Volstaat direct requests gebruiken niet?
Voor eenvoudige API's wel. Requestbibliotheken zoals requests voeren geen paginascripts uit en komen zo niet aan de volledige browserkenmerken. Dit soort bibliotheken past alleen bij open API's die geen rendering nodig hebben. Scraping op paginaniveau of sites met strenge controles draait stabieler in een volledige browseromgeving.
De data komen plotseling leeg terug. Wat check je eerst?
Behandel het eerst als een frequentieprobleem. Verlaag het tempo en observeer een dag of twee. Blijft het afwijkend, controleer dan de consistentie van exit en fingerprint en open dezelfde pagina handmatig in een browseromgeving. Zo onderscheid je of de sitestructuur veranderde of dat de bezoeken tegengehouden worden. Pas als laatste overweeg je een andere exit.
Tot slot
Of scraping lang kan blijven lopen hangt ervan af of de configuratie van drie lagen tegelijk klopt: stabiele exit, consistente fingerprint, gematigd tempo. Rijdt één laag uit balans, dan groeien de kosten van de andere twee. MostMate bundelt proxy, fingerprint en loginstatus in elke omgeving; de omgeving is de werkeenheid van de taak, en met Local API koppel je dat rechtstreeks aan je bestaande scraping-script.
Wil je een eerste scrapingtaak opzetten: begin met MostMate downloaden, draai eerst met de omgevingen van de gratis versie de monitoring van één kleine site, en breid dat daarna stap voor stap uit naar andere taken.

MOSTMATE
Veilig meerdere accounts beheren, heel eenvoudig
Begin met je eerste account en bouw met MostMate aan veiligere, slimmere en efficiëntere multiaccountactiviteiten.
- Onafhankelijke profielen. Consistente identiteiten.
- AI-automatisering · Accountgezondheid · Teamwerk



