
Paano i-set up ang fingerprint at proxy para sa web scraping: gabay sa configuration para sa stable na scraping
Pangunahing konklusyon: bihirang nakasentro sa isang punto ang dahilan ng pagkaban sa scraping; kadalasan, nahahati ito sa tatlong layer: proxy, fingerprint, at ritmo ng scraping. Mas mahalaga ang pagkakasunod ng configuration kaysa dami ng parameters. I-fix muna ang proxy exit ng bawat task. Pagkatapos, bigyan ang environment ng isang lohikal na magkatugmang set ng fingerprint parameters. Sa huli, i-pressure ang request frequency sa saklaw na tatanggapin ng target site. Sundan ng artikulong ito ang order na ito sa configuration checklist, at ipapakita rin kung paano i-konekta sa scraping script ang environment management gamit ang Local API.
"Halos sampu na ang binili kong proxy." Mas dumalas pa ang mga ban. Madalas ilagay ng mga scraping team ang budget sa proxy, pero hindi naman laging sa dami ng proxy nakasalalay ang problema. Mataas na frequency sa iisang exit, iisang set ng browser features sa lahat ng session, at tuloy pa rin sa orihinal na plano pagkatapos ma-trigger ang verification: kahit isang layer lang ang magulo, sabay-sabay na lulubog ang mga biniling exit.
Sa pananaw ng product form, ang MostMate ay kabilang sa kategorya ng fingerprint browser: may kanya-kanyang browser environment ang bawat account, at doon sa environment naka-manage ang proxy, fingerprint parameters, at login state. Kapag inilipat sa scraping scenario, ang isang environment ang running unit ng isang scraping task, at hindi nagbabahagi ng exit at device features ang mga environment sa isa't isa. Ang proxy ang nagpapasya kung saang line lalabas ang mga request, at ang fingerprint ang nagpapasya kung anong device ang nakikita ng target site. Kapag stable ang dalawang layer na ito, saka may puwang ang pagkontrol sa ritmo.
Tatlong layer ang mga senyales ng ban, at mula rito napagpapasyahan ang pagkakasunod ng configuration
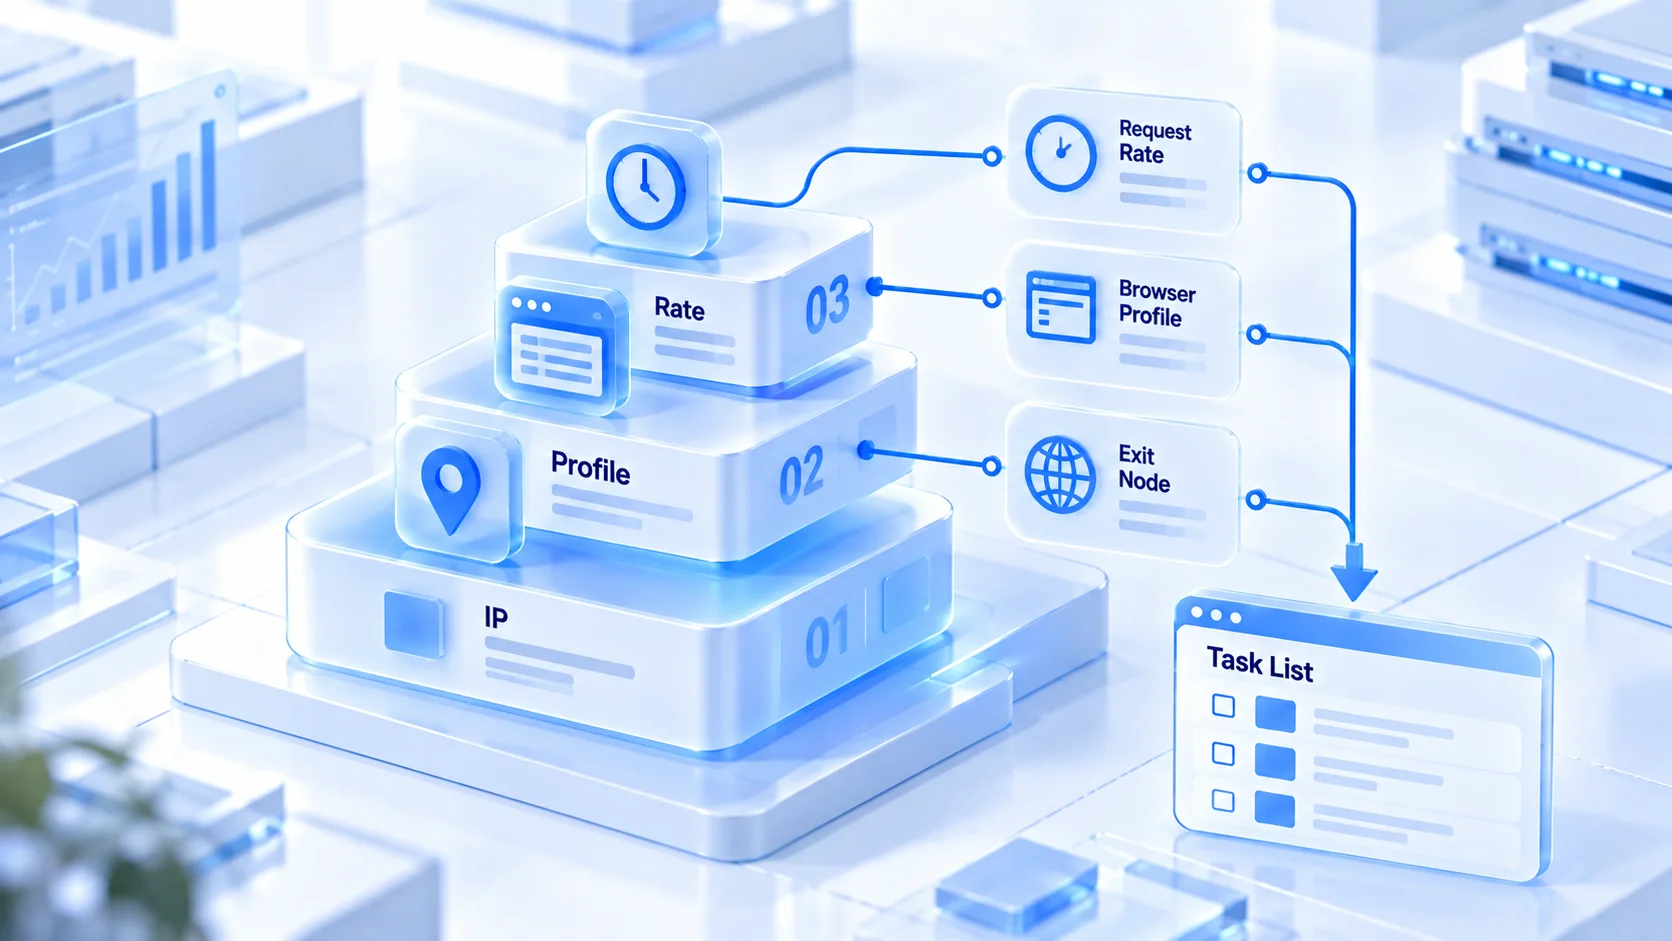
Tinatantya ng anti-scraping ang isang visit sa humigit-kumulang tatlong layer. Magkaiba ang tinitingnan ng bawat layer, kaya magkaiba rin ang mga aksyon sa configuration:
- Connection layer: tinitingnan muna ng target site kung saang IP nagmula ang request at anong uri ito. Pinakamabilis na ma-block ang mataas na frequency sa iisang exit o ang pagkahulog sa mga marked network segment.
- Device layer: binabasa ng page scripts ang Canvas, WebGL, font list, timezone at iba pang parameters para hulaan kung totoo at normal na device ang bisita.
- Behavior layer: request interval, sunod-sunod na pagbisita, tempo ng mga aksyon pagkatapos mag-login. Ang matagal na mekanikal at pare-parehong pattern ay tuloy-tuloy na nagpapataas ng suspetsa.
Ang order ng pagkagulo ng tatlong layer ang nagtatakda ng order ng configuration. Habang hindi pa naka-fix ang exit, walang pagkakabitan ang mga parameter na naka-link sa IP tulad ng wika, timezone, at geographic location; at habang hindi pa naka-fix ang device features, kahit gaano ka-natural ang ritmo, iisa pa ring device na mataas ang frequency ang nakikita ng target site. Kaya ang ayos ng paggawa: proxy muna, fingerprint sunod, ritmo sa huli; ang mga susunod na bahagi ay sumusunod sa linyang ito.
Paano i-set up ang proxy: mas mahalaga ang stable na exit kaysa dami
Mas malapit sa stable na scraping ang pagkakaroon ng hiwalay at fixed na exit sa bawat scraping task kaysa pagbuno ng maraming rotating IP. Kapag maraming task ang naghahati sa iisang exit, kapag may na-trigger na risk control ang isang task, madalas nadadamay ang iba pang task sa parehong exit. Pagkatapos paghiwalayin ang mga exit, hindi na nagtutulakan ang mga task kahit man lang sa connection layer, at sa troubleshooting, diretso mong makikita kung saang line nanggaling ang problema.
Uri ng exit, base sa lakas ng risk control. Sa mga site na maluwag ang control, sapat na ang gastusin ng datacenter IP. Sa mga pangunahing e-commerce at social media site, mas matagal kadalasang nabubuhay ang residential IP. Ang pinagkaiba ng trust level, cost structure at angkop na senaryo ng dalawang uri, pinakamainam na hatulan gamit ang paghahambing sa residential vs. datacenter IP selection guide, hindi ang pakiramdam lang.
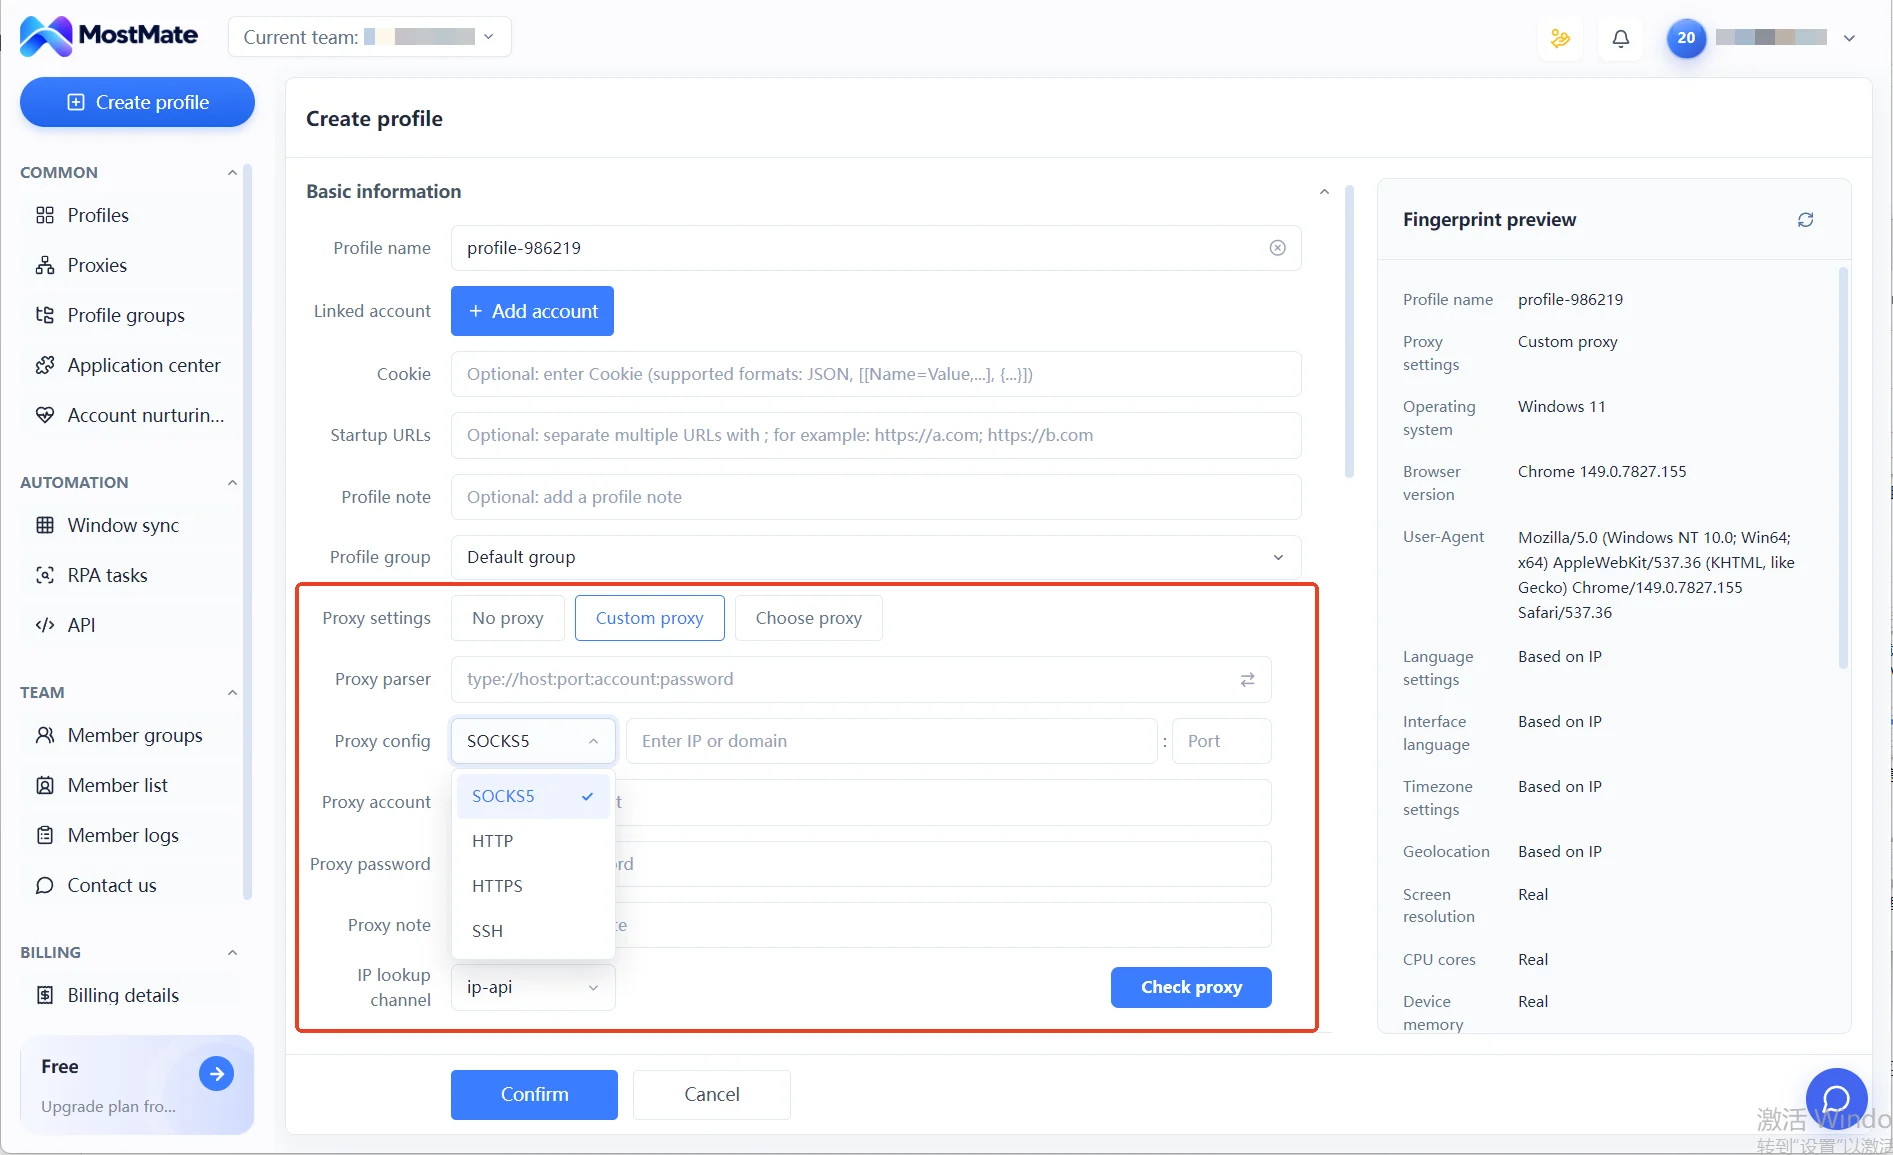
Sa konkretong MostMate, hiwalay na naka-manage ang mga proxy sa proxy management list. May entry point ang apat na protocol: HTTP, HTTPS, SOCKS5 at SSH, at bawat entry ay maaaring subukan agad gamit ang Check proxy button para sa connectivity at kung saang exit ito naka-attribute. Kapag pumasa sa test, ipapasa na sa environment. Tatlong antas ang proxy setting sa environment form: walang proxy, custom proxy, at pagpili ng proxy. Sa mga scraping environment, inirerekomenda ang third option. Magkakasama sa listahan ang lahat ng exit, at makikita sa isang tingin kung anong line ang ginagamit ng anong task.
Kapag tapos na ang proxy layer, tingnan naman natin ang device features.
Paano itakda ang fingerprint parameters: konsistensiya muna, iwas ang random
Ang layunin ng fingerprint ng scraping environment ay para sa mahabang panahon, ipakita ng parehong environment ang mga feature ng parehong normal na device. Sa paligid ng layuning ito, hinahati ang mga parameter sa dalawang uri: ang naka-link sa exit, ipapasa sa automatic alignment, at ang mga sariling device feature, i-fix sa isang set na hindi na gagalawin sa mahabang panahon.
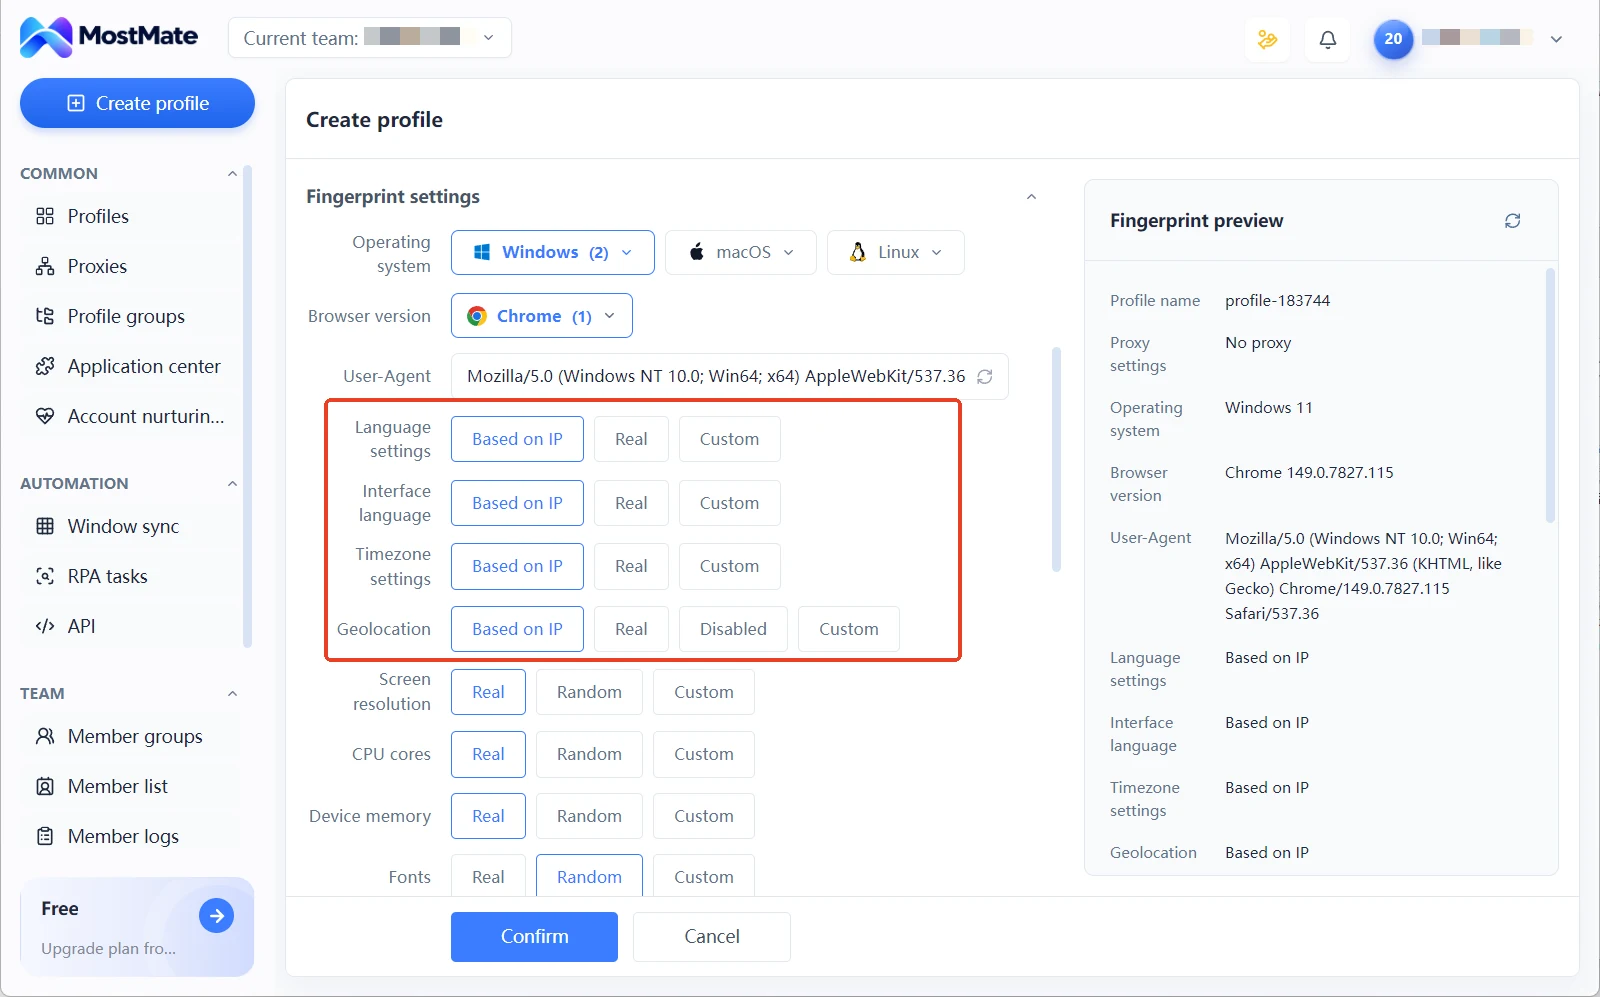
Apat na setting: language, interface language, timezone at geographic location, default na naka-set sa IP-based configuration. Kapag na-fix ang exit, awtomatikong nag-a-align ang mga value, at sa pagpalit ng exit, hindi na kailangan ng isang round ng manual checking. Pumili ng isang combination ng OS at browser version at i-fix ito, gagawa ang UA nang umaayon, at hindi na gagalawin sa buong task cycle. Panatilihing totoo ang screen resolution, CPU core count, device memory at font list, at dapat galing sa parehong system na idineklara.
Ang paghawak sa rendering parameters ang higit na dapat pagtuonan. Sa Canvas, WebGL at iba pang image at audio output, noise level ang iniaalok ng interface: bahagyang pag-iba sa ibabaw ng totoong halaga, habang pinapanatili ang orihinal na lohika ng device. Ang natatanggap pa rin ng tagasuri ay isang self-consistent na set ng output; kung bakit mas delikado ang random na value, mainam na unawain gamit ang argumento sa Bakit hindi dapat gawing random ang fingerprint parameters.
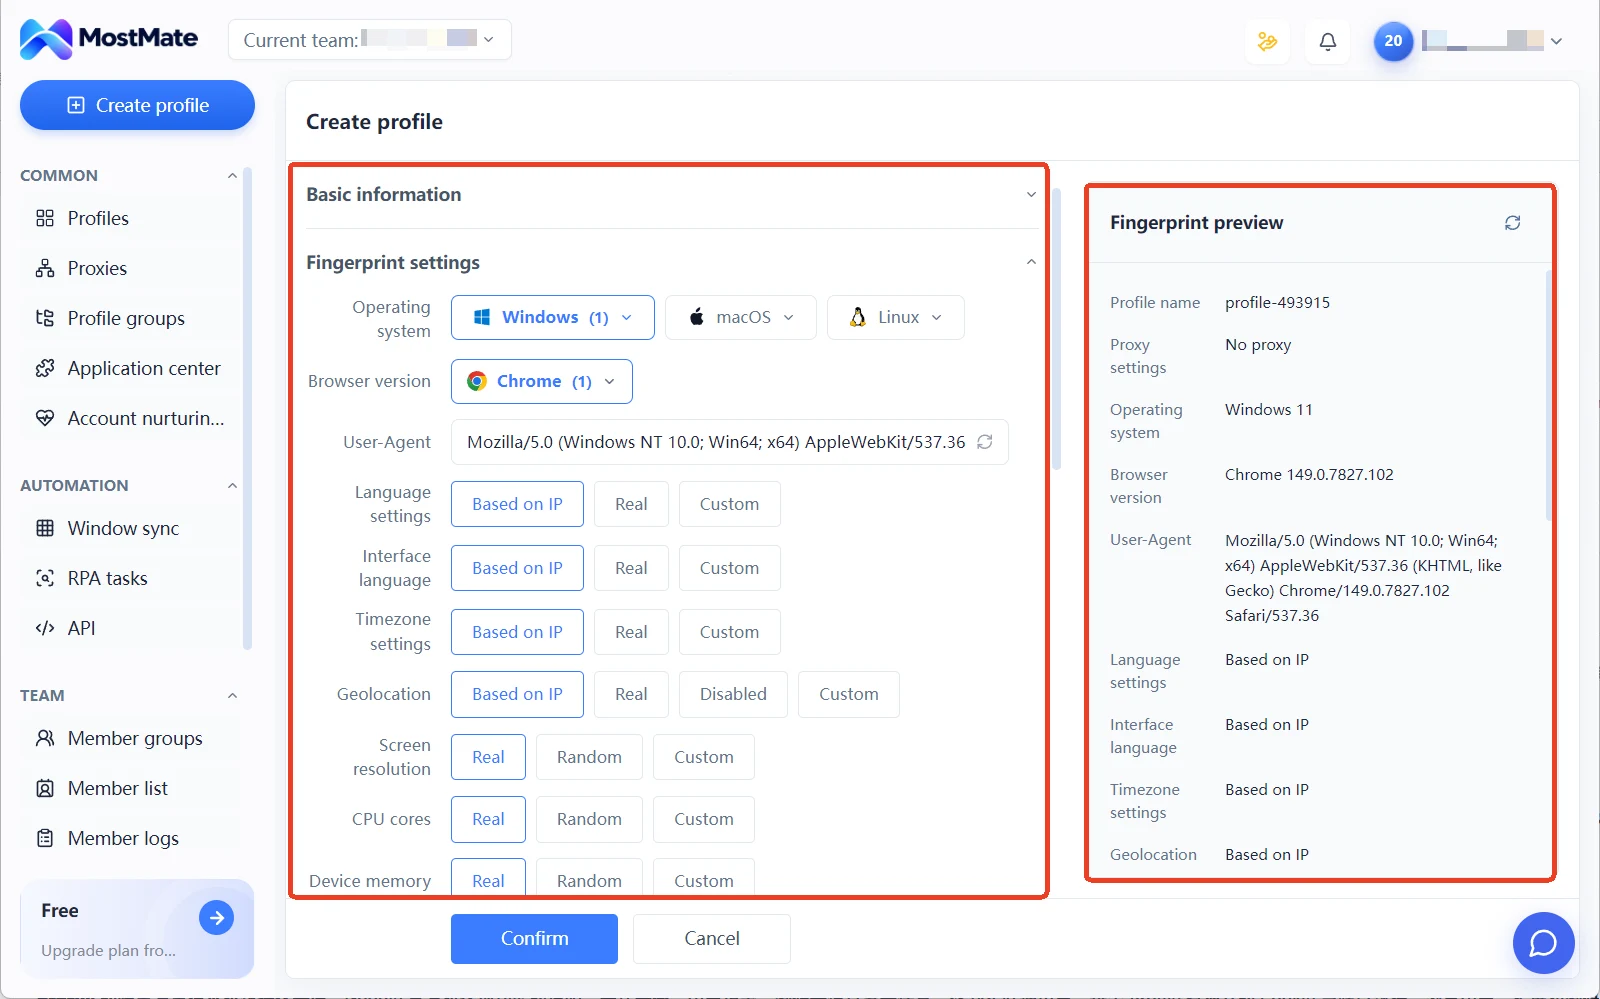
Napakakonkreto ng paraan sa mga scraping environment: piliin ang noise level sa rendering parameters, hindi random mode. Pagkatapos i-set up ang parameters, hindi rin kailangang tiyakin sa pakiramdam: sa kanang bahagi ng form para sa paggawa ng environment, may fingerprint preview panel, kung saan magkakasamang nakalista sa real time ang mga value mula timezone hanggang Canvas level. Isang sulyap bago i-save, at makikita agad ang malinaw na misalignment.
Ritmo at login state: paano ibaba ang kawalan ng katiyakan sa behavior layer
Ang trial run ng bagong task ay maaaring sundan ang tatlong hakbang:
1. Itakda ang panimulang punto: iisang digit na concurrency, segundong antas ng interval, magpatakbo muna ng isang araw o dalawa. Itala ang paglitaw ng captcha at proporsyon ng abnormal na responses. 2. Hanapin ang hangganan: kapag lumitaw ang captcha, bumalik sa nakaraang antas ng frequency. Ang antas na ito ang kasalukuyang safety boundary ng exit. 3. Pagkatapos, dagdagan ang volume: matapos ang ilang araw ng stable na pagtakbo sa loob ng hangganan, dagdagan nang paunti-unti ang concurrency. Magdagdag ng random jitter sa base interval para hindi uniform ang request rhythm.
Ilagay sa environment ang login state. Sa mga data na nangangailangan ng login, sapat na ang isang login: naka-save sa environment ang Cookie at session, at gagamitin muli sa susunod na pagbubukas. Nakakatipid ito sa verification cost ng paulit-ulit na pag-login, at iniiwasan ding maging kahina-hinalang senyales ang mismong madalas na pag-login. Bago magsimula, kumpirmahin muna ang saklaw ng scraping. Ang robots protocol at terms of service ang nagpapasya kung maaaring matagal tumakbo ang isang task; ang detalye ng protocol ay nasa robots.txt entry ng MDN, at ang item na ito ay nauuna sa lahat ng configuration parameters.
Pagkonekta ng environment sa scraping script gamit ang Local API
Kapag dumami ang environment, hindi na kayang humabol ng manual na pagbukas at pagsara ang script. Nagbibigay ang MostMate ng Local API: lokal na interface at API key; kapag naka-on ang security check, kailangang dala ng bawat request ang Key. Dito, maaaring simulan at ihinto ng scraping script ang mga environment, tingnan ang kanilang status, at ipasa sa code ang desisyon kung aling environment ang gagamitin. Kung aling senaryo ang angkop sa window sync, RPA at API, may paghahambing sa multi-account automation selection guide; ang pure script scraping ay pangunahing tumutugma sa API line.
Karaniwang ginagamit ang automation framework sa page-level scraping para patakbuhin ang browser; kumpleto ang paliwanag sa pag-install at pagsisimula ng Playwright sa official documentation. Direkta ang kombinasyon: bubuksan muna ng script ang tinukoy na environment gamit ang Local API, pagkatapos, hahawakan ng automation framework ang mga page operation sa environment na ito, at isasara ang environment pagkatapos ng scraping.
Ang mga page request ay nagmumula sa kumpletong browser environment, at naiwan dito ang Cookie, storage at fingerprint parameters, kaya mas kumpleto ang mga feature na napanatili kaysa sa hubad na HTTP request. Ang kabuuang ugnayan ng mga konseptong environment, proxy at fingerprint sa produkto, may sistematikong pagpapakilala sa pahina ng Ano ang MostMate; basahin ito bago magsulat ng script, at mas mabilis mong mauunawaan ang mga field na ibinabalik ng interface.
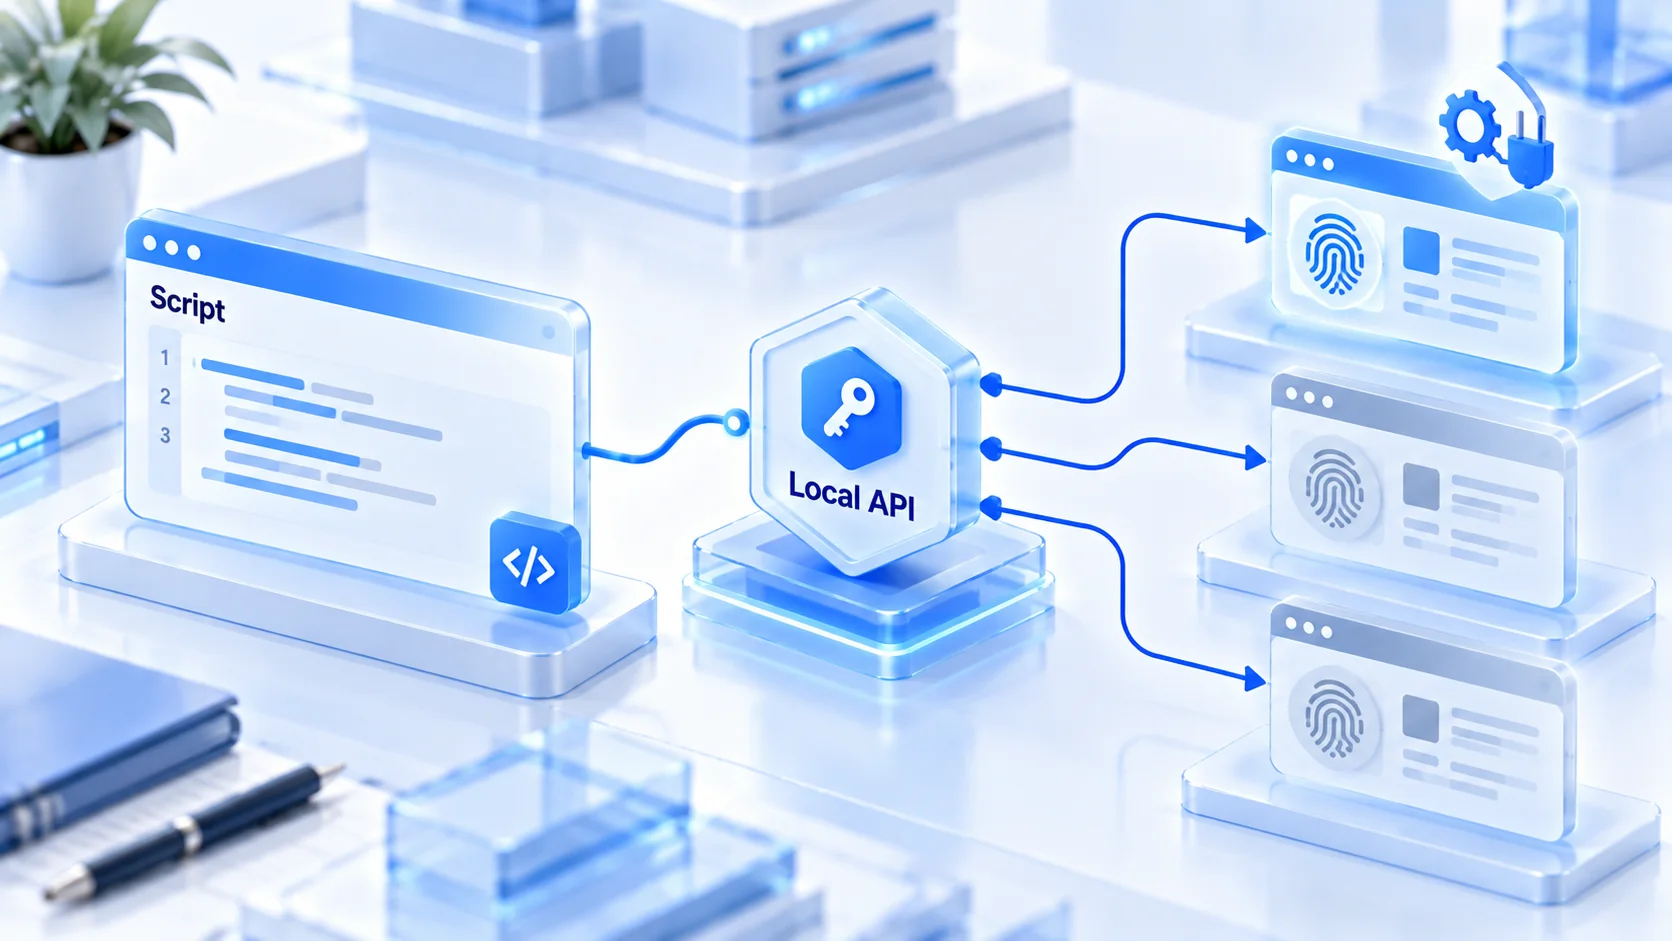
May threshold sa plan ang bilang ng mga Local API call; nakasaad sa interface na available ito sa mga plan na anim na buwan pataas. Kumpirmahin muna ang tagal ng plan bago magsulat ng script. Para hindi mo matuklasan pagkatapos buuin ang daloy na limitado pala ang mga call.
Mga Madalas Itanong
Kailangan bang may hiwalay na proxy ang bawat scraping task?
Hatulan ayon sa lakas ng risk control ng target site at dami ng mga task. Sa mga site na mahigpit ang control at mabigat ang task, sulit ang isang eksklusibong exit. Maaaring maghati ang mga maliit at mababang frequency na task sa isang exit, pero mainam na hindi magkaugnay sa negosyo ang mga task na nagbabahagi. Kapag may namarka, madaling madamay ang iba pang task sa parehong exit.
Kailangan bang palitan paminsan-minsan ang fingerprint parameters?
Hindi. Ang layunin ay panatilihing fixed sa mahabang panahon ang parameters ng parehong environment; ang madalas na pagbabago ay nagpapawala ng continuity ng device features. Lamang kapag napalitan ang exit o natukoy ang misaligned parameter, saka gagalawin ang partikular na item na iyon.
Hindi ba pwedeng direktang mag-request gamit ang requests?
Para sa mga simpleng interface, pwede. Ang mga request library tulad ng requests ay hindi nagpapatakbo ng page scripts, kaya hindi nito nakukuha ang kumpletong browser features. Ang mga ganitong library ay angkop lang sa mga open interface na hindi nangangailangan ng rendering. Sa page-level scraping o mahigpit ang risk control na mga site, mas stable na patakbuhin sa kumpletong browser environment.
Bigla na lang blangko ang ibinabalik na data: ano ang unang susuriin?
Ituring munang problema sa frequency. Bawasan ang frequency at magmasid nang isang araw o dalawa. Kapag may abnormal pa rin, i-cross-check ang konsistensiya ng exit at fingerprint, pagkatapos manually na bisitahin ang parehong page gamit ang browser environment. Para makita kung pagbabago ng site structure o naka-block ang access. Sa huli lang isipin ang pagpalit ng exit.
Konklusyon
Ang pagpapatuloy ng scraping sa mahabang panahon ay nakasalalay sa sabay-sabay na pagtupad ng tatlong layer ng configuration: stable na exit, konsistenteng fingerprint, at may pagpipigil na ritmo. Kapag nagulo ang kahit isang layer, lumalaki ang gastos ng iba pang dalawa. Isinasama ng MostMate sa bawat environment ang proxy, fingerprint at login state; ang environment ang running unit ng task, at gamit ang Local API, direktang maaaring ikonekta sa umiiral na scraping script.
Para buuin ang unang scraping task, maaari kang magsimula sa pag-download ng MostMate, patakbuhin muna gamit ang libreng environment ang monitoring ng isang maliit na site, at dahan-dahang gayahin sa iba pang mga task.

MOSTMATE
Ligtas na Pamamahala ng Maraming Account, Pinadali
Magsimula sa unang account at gamitin ang MostMate upang bumuo ng mas ligtas, mas matalino, at mas mahusay na operasyon ng maraming account.
- Mga hiwalay na profile. Mga magkakatugmang identidad.
- AI Automation · Kalagayan ng Account · Mga Operasyon ng Team



