
¿Cómo configurar la huella digital y el proxy de un scraper web? Guía de configuración contra bloqueos
Conclusión clave: cuando una recolección es bloqueada, la causa rara vez se concentra en un solo punto; casi siempre se reparte en las tres capas de proxy, huella digital y ritmo de recolección. El orden de configuración importa más que la cantidad de parámetros. Primero fija la salida del proxy de cada tarea. Después dota al entorno de un conjunto de parámetros de huella coherente. Por último, reduce la frecuencia de peticiones hasta el rango que el sitio objetivo tolera. Este artículo ofrece una lista de configuración en ese orden y explica cómo usar la Local API para integrar la gestión de entornos en tu script de scraping.
«Compré una docena de proxies.» Y aun así, los bloqueos llegan con más frecuencia. Los equipos de scraping suelen concentrar el presupuesto en los proxies, pero el problema no siempre está en su cantidad. Peticiones que entran y salen a alta frecuencia por la misma salida, sesiones que llevan todas las mismas huellas de navegador, o scripts que siguen el plan original tras activarse una verificación: cualquier capa desequilibrada arrastra por delante todas las salidas compradas.
Por su forma de producto, MostMate pertenece a la categoría de navegadores antidetect: cada cuenta recibe un entorno de navegador independiente, y el proxy, los parámetros de huella y el estado de sesión se gestionan dentro del entorno. Trasladado al scraping, cada entorno equivale a la unidad de ejecución de una tarea, y los entornos no comparten salidas ni características de dispositivo. El proxy decide por qué línea salen las peticiones; la huella decide qué tipo de equipo ve el sitio objetivo. Con estas dos capas bien asentadas, el control del ritmo tiene margen para funcionar.
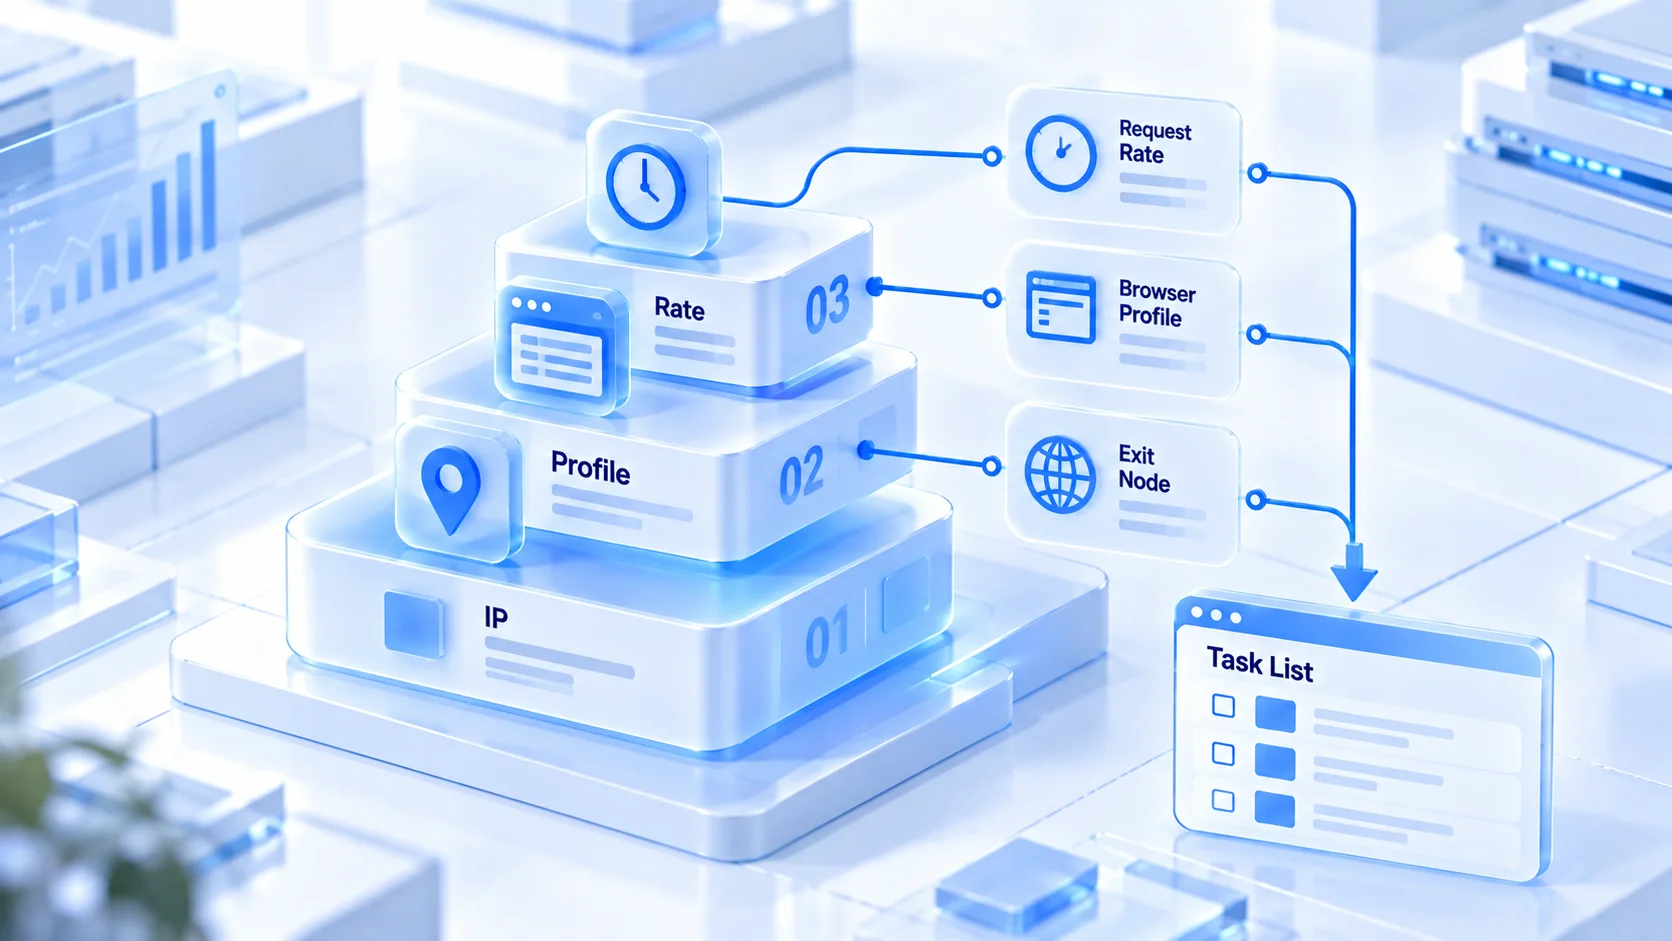
Las señales de bloqueo se reparten en tres capas, y de ahí sale el orden de configuración
La revisión que hace el sistema antibot de una visita se despliega, a grandes rasgos, en tres capas. Cada capa observa objetos distintos y exige acciones de configuración distintas:
- Capa de conexión: el sitio objetivo mira primero desde qué IP llega la petición y de qué tipo. Entrar y salir a alta frecuencia por la misma salida, o caer en un rango de red marcado, es lo que antes se bloquea.
- Capa de dispositivo: los scripts de la página leen parámetros como Canvas, WebGL, la lista de fuentes o la zona horaria para decidir si el visitante es un equipo real y normal.
- Capa de comportamiento: el intervalo entre peticiones, la ruta de navegación, el ritmo de las acciones tras iniciar sesión. Un patrón mecánicamente uniforme eleva la sospecha de forma continua.
El orden en que se desequilibran las tres capas determina el orden de configuración. Si la salida no está fijada, los parámetros ligados a la IP, como el idioma, la zona horaria o la geolocalización, no tienen dónde apoyarse; si las características del dispositivo no están fijadas, por natural que sea el ritmo, el sitio objetivo sigue viendo a la misma máquina visitando a alta frecuencia. Por eso el orden de trabajo es proxy primero, huella después y ritmo al final; las siguientes secciones siguen esta línea.
Cómo configurar el proxy: estabilidad de la salida frente a cantidad
Fijar una salida independiente para cada tarea de recolección acerca más a una recopilación estable que acumular IP rotativas. Cuando varias tareas comparten la misma salida, una que activa el control de riesgo arrastra a las demás del mismo canal. Con salidas independientes, las tareas al menos no se contaminan en la capa de conexión, y al diagnosticar puedes identificar directamente en qué línea está el problema.
El tipo de salida se elige según la intensidad del control de riesgo. En sitios poco estrictos, el coste de las IP de centro de datos basta. En grandes comercios electrónicos y redes sociales, las IP residenciales suelen sobrevivir más tiempo. Las diferencias de confianza, la estructura de costes y los escenarios de ambas se pueden valorar con la comparación de la guía para elegir entre IP residenciales y de centro de datos, sin dejarlo al criterio de la intuición.
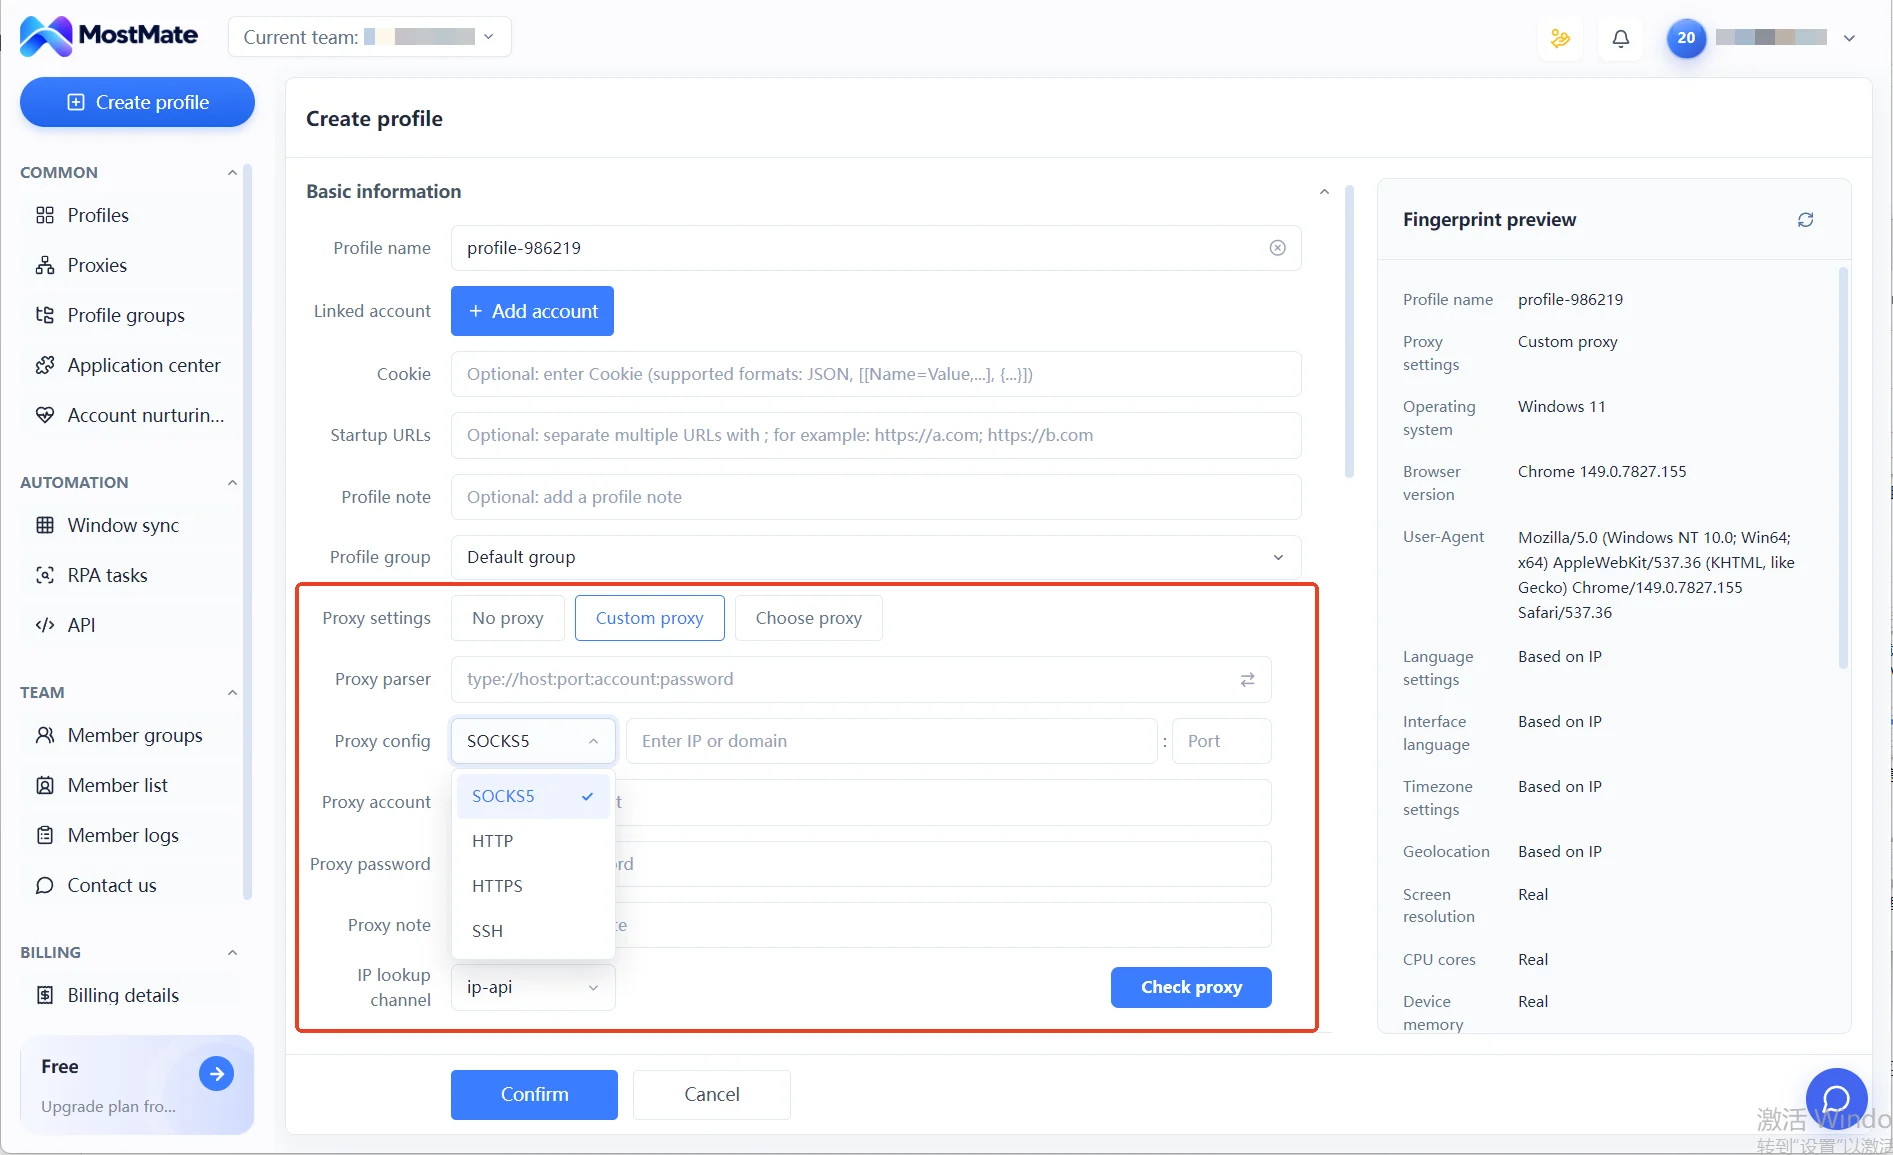
Concretamente en MostMate, los proxies se mantienen por separado en la lista de gestión de proxies. Los cuatro protocolos HTTP, HTTPS, SOCKS5 y SSH están disponibles, y cada proxy se puede probar al momento con el botón Check proxy para verificar la conectividad y la salida. Tras pasar la prueba, se asigna al entorno. La configuración de proxy del formulario de entorno tiene tres niveles: sin proxy, proxy personalizado y proxy de la lista. Para entornos de recolección se recomienda el tercero. Con todas las salidas centralizadas en la lista, se ve de un vistazo qué tarea usa cada línea.
Configurada la capa de proxy, pasamos a las características del dispositivo.
Cómo definir los parámetros de huella: coherencia primero, aleatoriedad con cautela
El objetivo de huella de un entorno de recolección es que ese entorno presente de forma sostenida las características de un mismo equipo normal. Con ese fin, los parámetros se tratan en dos grupos: los ligados a la salida se dejan al ajuste automático, y los propios del dispositivo se fijan en un conjunto estable a largo plazo.
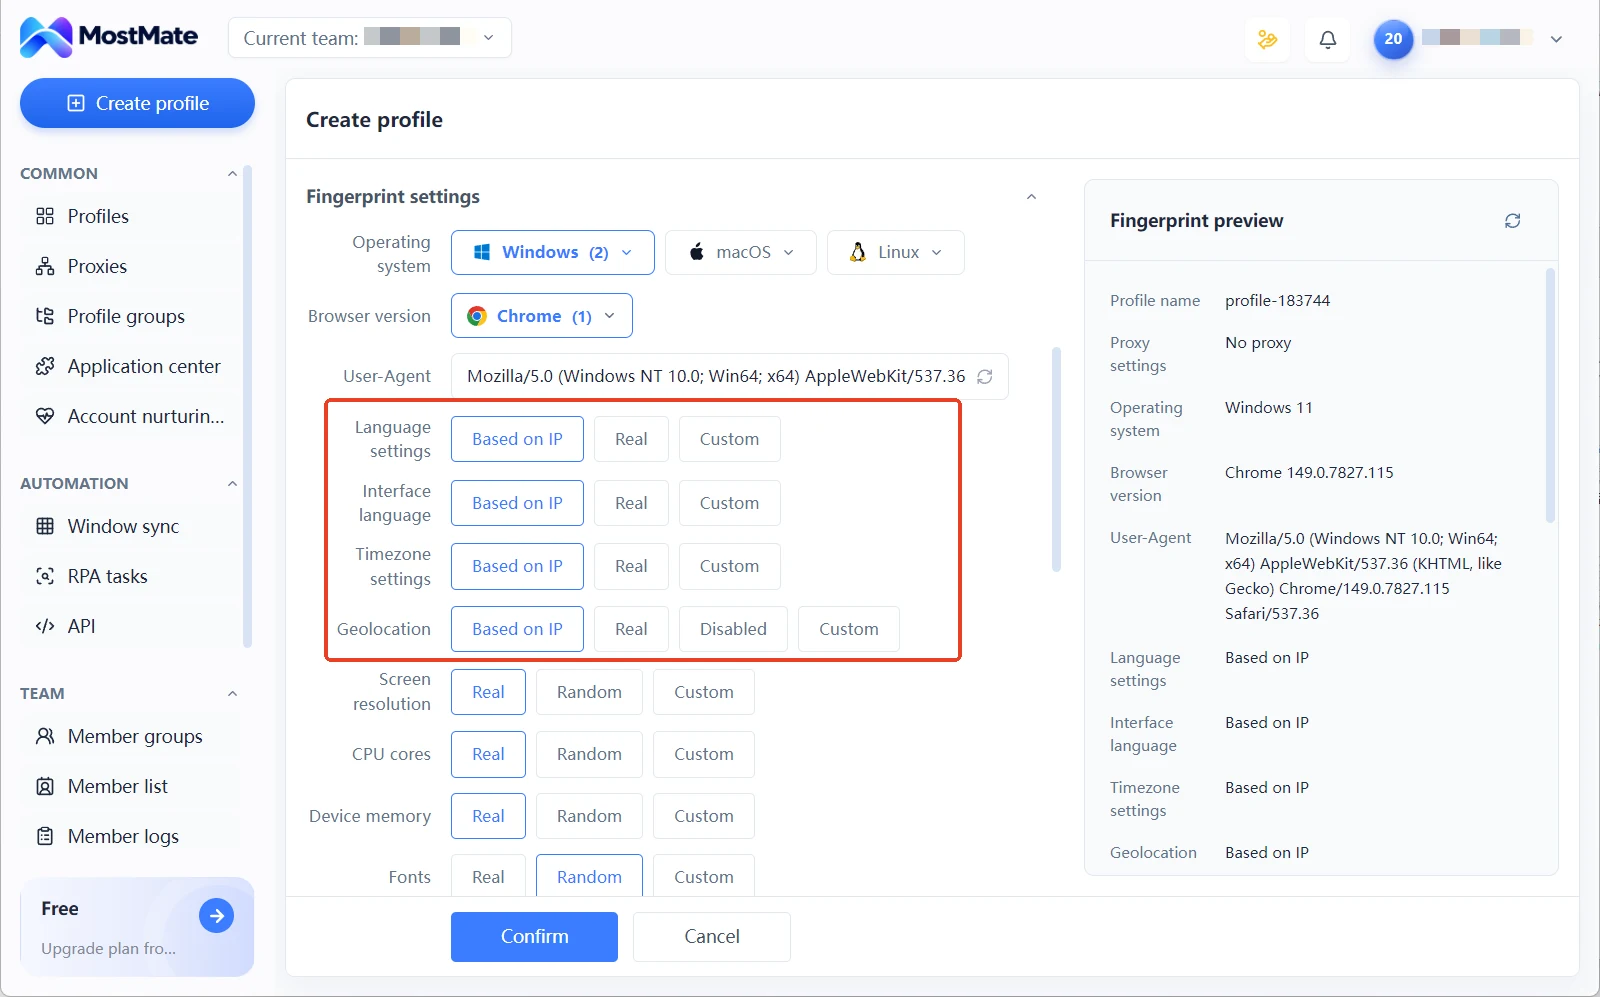
Idioma, idioma de la interfaz, zona horaria y geolocalización se basan en la IP por defecto. Fijada la salida, sus valores se alinean solos, y al cambiar de salida te ahorras una ronda de comprobación manual. Sistema operativo y versión del navegador se eligen como una combinación y quedan fijos; el UA se genera en consecuencia y no se toca durante todo el ciclo de la tarea. Resolución de pantalla, núcleos de CPU, memoria del equipo y lista de fuentes mantienen valores reales, coherentes con el sistema declarado.
El tratamiento de los parámetros de renderizado merece más atención. Para la imagen y la salida de audio, como Canvas y WebGL, la interfaz ofrece un nivel de ruido que añade una perturbación ligera sobre el valor real conservando la lógica original del dispositivo; lo que recibe el detector sigue siendo un conjunto de datos autoconsistente. Por qué los valores aleatorios son más peligrosos, se entiende con el argumento de por qué no aleatorizar los parámetros de huella.
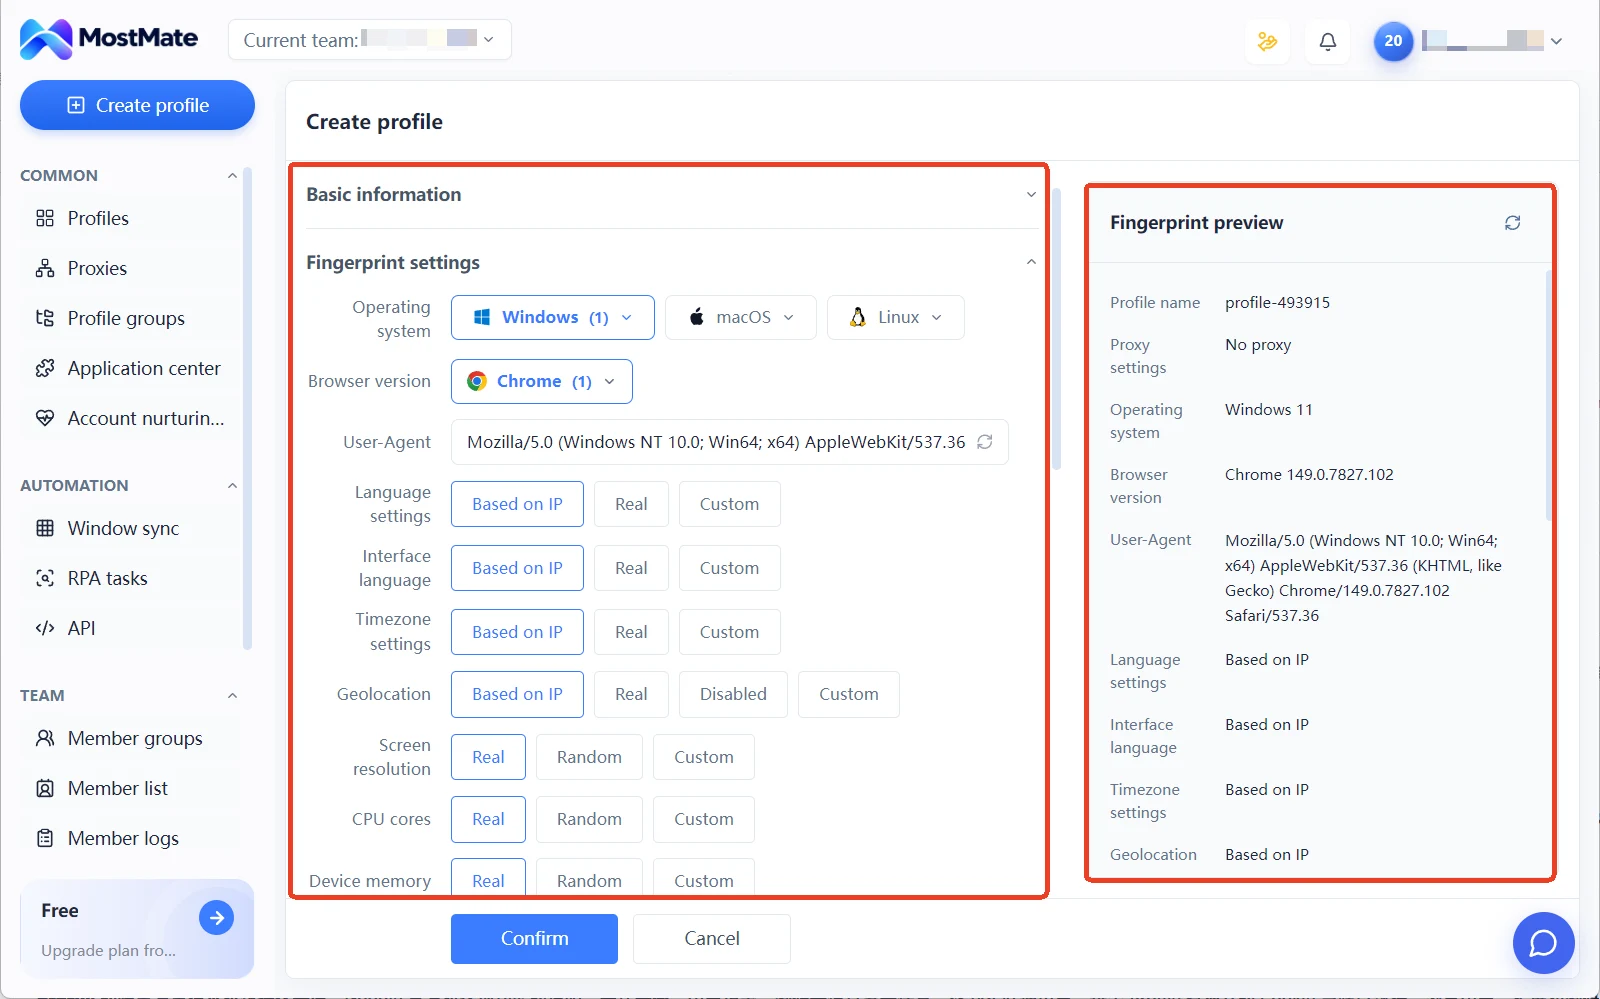
En la práctica, para entornos de recolección la regla es concreta: en los parámetros de renderizado, elegir el nivel de ruido, no el nivel aleatorio. Y tras configurar los parámetros no hace falta verificar a ojo: el formulario de creación de entorno tiene a la derecha un panel de vista previa de huella donde la zona horaria, el nivel de Canvas y otros valores aparecen listados en tiempo real. Un vistazo antes de guardar y los desajustes evidentes se detectan al instante.
Ritmo y estado de sesión: reducir la incertidumbre de la capa de comportamiento
La prueba inicial de una tarea nueva puede seguir tres pasos:
1. Marcar el punto de partida: concurrencia de un dígito e intervalos de segundos durante uno o dos días. Anota cuándo aparecen verificaciones y qué proporción de respuestas anómalas hay. 2. Buscar el límite: en cuanto aparezca una verificación, vuelve al nivel de frecuencia anterior. Ese nivel es, por ahora, el límite seguro de esa salida. 3. Aumentar la carga: tras varios días de funcionamiento estable dentro del límite, sube la concurrencia poco a poco. Añade jitter aleatorio al intervalo base para evitar un ritmo de peticiones perfectamente uniforme.
El estado de sesión se conserva dentro del entorno. Para los datos que requieren inicio de sesión, basta con iniciar sesión una vez: las Cookie y la sesión quedan guardadas en el entorno, y la siguiente apertura continúa donde quedó. Así se ahorra el coste de verificación de iniciar sesión una y otra vez, y se evita que el propio inicio frecuente sea una señal sospechosa. Antes de poner manos a la obra, define el alcance de la recolección. El protocolo robots.txt y los términos de servicio deciden si una tarea puede funcionar a largo plazo; los detalles del protocolo se pueden consultar en la entrada robots.txt de MDN, y este punto va antes que cualquier parámetro de configuración.
Integrar los entornos en el script de scraping con la Local API
Cuando los entornos se multiplican, abrirlos y cerrarlos a mano no sigue el ritmo del script. MostMate ofrece la Local API: interfaz local más clave de API; tras activar la verificación de seguridad, cada petición debe llevar su Key. Mediante la API, el script puede iniciar y cerrar entornos, consultar su estado y dejar en manos del código la decisión de qué entorno usar. Qué conviene en cada caso entre sincronización de ventanas, RPA y API está comparado en la guía para elegir automatización multicuenta; la recolección por script puro corresponde principalmente a la línea de la API.
La recolección a nivel de página suele usar frameworks de automatización para manejar el navegador; la instalación y los primeros pasos con Playwright están explicados en su documentación oficial. La forma de combinarlos es directa: el script abre primero el entorno indicado por la Local API, después el framework de automatización toma el control de las operaciones de página dentro de ese entorno y, al terminar, cierra el entorno.
Las peticiones de página salen de un entorno de navegador completo, con las Cookie, el almacenamiento y los parámetros de huella dentro del entorno, y conservan mucho más que las peticiones HTTP simples. La relación global entre entorno, proxy y huella en el producto está expuesta de forma sistemática en la página qué es MostMate; repásala antes de escribir el script y comprenderás mucho más rápido los campos que devuelve la interfaz.
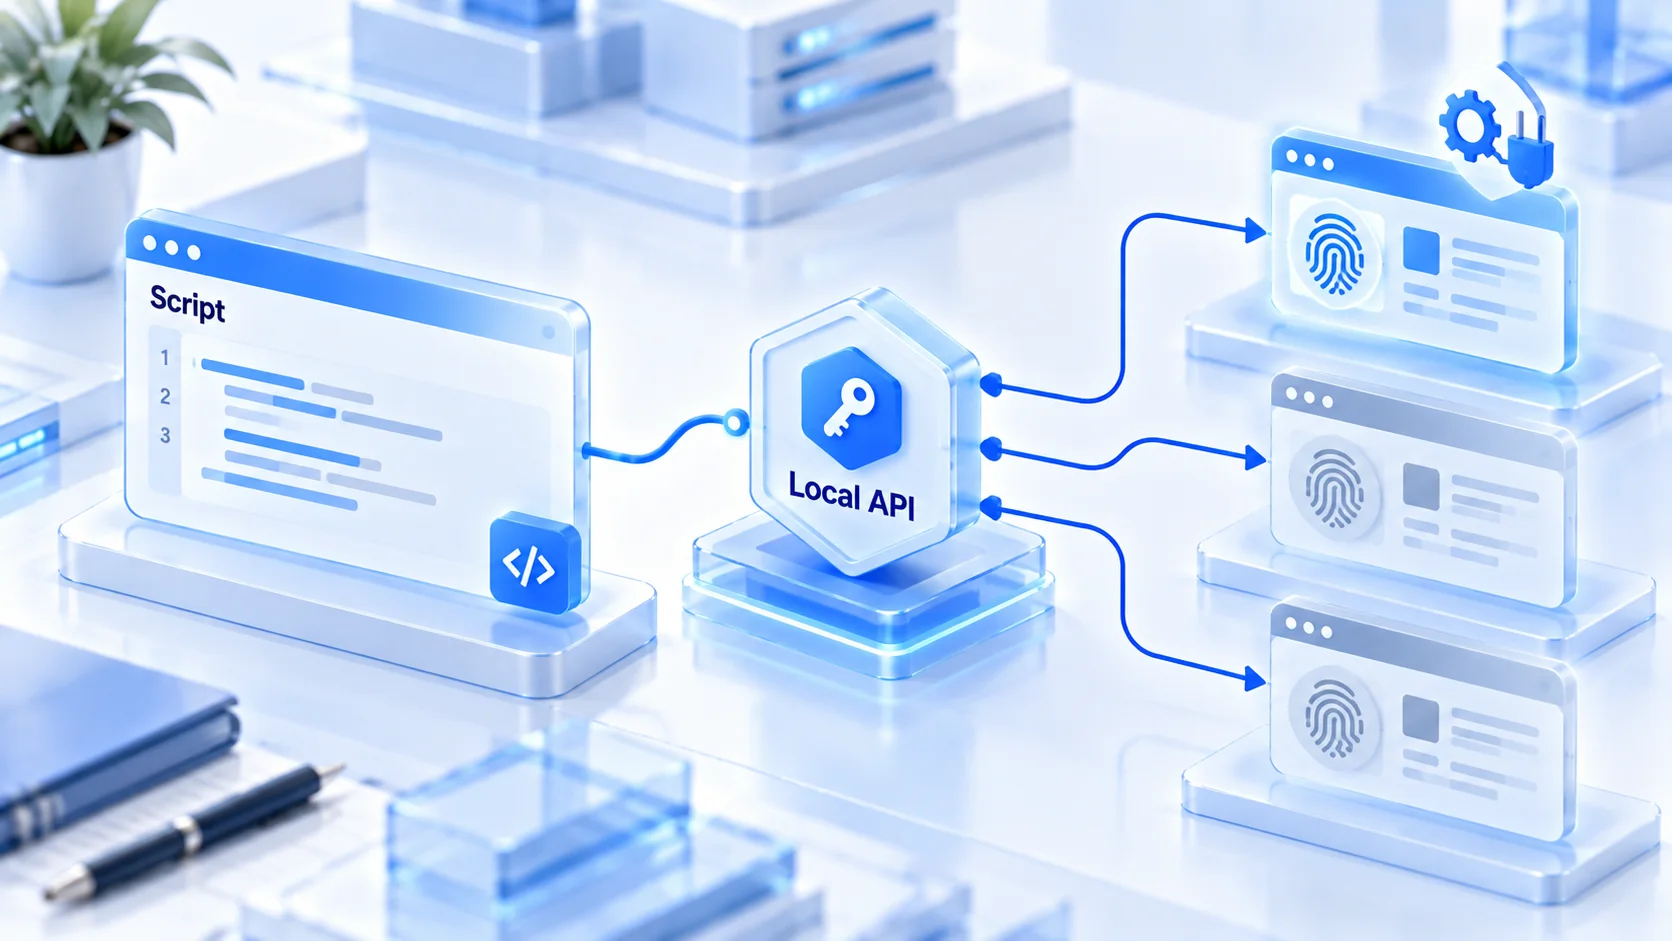
El número de llamadas a la Local API queda limitado según el plan contratado; la interfaz lo indica como disponible en planes de medio año o superiores. Comprueba la duración de tu plan antes de escribir el script, y evita descubrir la limitación cuando el flujo ya esté montado.
Preguntas frecuentes
¿Cada tarea de recolección necesita su propio proxy?
Depende de la intensidad del control de riesgo del sitio objetivo y del volumen de tareas. En sitios estrictos con carga alta, vale la pena una salida exclusiva. Las tareas pequeñas de baja frecuencia pueden compartir una, aunque conviene que sean de negocios sin relación entre sí: si una queda marcada, es fácil que arrastre a las demás del mismo canal.
¿Hay que renovar los parámetros de huella periódicamente?
No. La meta es que los parámetros de un mismo entorno permanezcan fijos a largo plazo; cambiarlos con frecuencia rompe la continuidad de las características del dispositivo. Solo se toca el parámetro correspondiente si se cambia de salida o al detectar un desajuste.
¿No basta con hacer peticiones directamente con requests?
Para interfaces simples, sí. Las bibliotecas de peticiones como requests no ejecutan los scripts de la página y no obtienen las características completas del navegador; solo sirven para API abiertas que no requieren renderizado. Para recolección a nivel de página o sitios con control estricto, es más estable trabajar con un entorno de navegador completo.
Los datos vuelven de repente vacíos: ¿qué revisar primero?
Trátalo primero como un problema de frecuencia. Reduce la velocidad y observa uno o dos días. Si la anomalía persiste, comprueba la coherencia entre salida y huella y visita manualmente la misma página con el entorno de navegador, para distinguir si cambió la estructura del sitio o el acceso fue bloqueado. Cambiar de salida es el último recurso.
Conclusión
Que la recolección funcione a largo plazo depende de que las tres capas se cumplan a la vez: salida estable, huella coherente, ritmo moderado. Cualquier capa desequilibrada encarece las otras dos. MostMate reúne el proxy, la huella y el estado de sesión en cada entorno; el entorno es la unidad de ejecución de la tarea y, con la Local API, se conecta directamente a los scripts de scraping existentes.
Para montar tu primera tarea de recolección, empieza por descargar MostMate: con los entornos de la versión gratuita, deja primero funcionando la monitorización de un sitio pequeño y repítelo después en las demás tareas.

MOSTMATE
Gestión segura de varias cuentas, sin complicaciones
Empieza con tu primera cuenta y utiliza MostMate para crear operaciones multicuenta más seguras, inteligentes y eficientes.
- Perfiles independientes. Identidades coherentes.
- Automatización con IA · Estado de las cuentas · Operaciones en equipo



