
フォントフィンガープリントとは?Webサイトはフォントリストでどう環境を識別するのか
環境やプロキシを入れ替えても、ページの見た目には微妙な差が残ります。同じWebサイトなのに、ある環境ではボタンの文字が別の環境より2ピクセルだけ広い、という具合です。この違いを生む要素の一つがフォントです。各マシンにどんなフォントが入っているかは、Webサイトに一度測られるとおおよそ分かってしまい、ここからフォントリストがブラウザフィンガープリントのパラメータの一つとして扱われるようになりました。本稿で扱うのは3点です。Webサイトがフォントをどう測るのか、測定結果をどこまで信用できるのか、そしてフォントリストの3モード(実フォント/ランダム/カスタム)をそれぞれどんな場面で選ぶべきか。指紋全体の中でのフォントの位置づけは、MostMateのフィンガープリント設定で基本パラメータの一つとされており、製品の全体像はMostMateとはをご覧ください。
フォントフィンガープリントとは:サイトは「どんなフォントが入っているか」を推測している
フォントフィンガープリントは、フォントファイルを丸ごと送らせる仕組みではありません。Webサイトは一連のテストで「このマシンは特定のフォントを表示できるか」を推測しているだけです。OSは出荷時に一定のフォントを搭載し、ユーザーやソフトウェアがそこへ追加していきます。Officeをインストールすればフォントが一式増え、中国語版WindowsならSimSun(宋体)とMicrosoft YaHei(微软雅黑)が最初から入っています。2台のマシンでフォント集合が一致する確率は低く、この差分こそが情報になります。EFFは2010年のトラッキング調査でフォントを識別可能なパラメータに挙げており、以降、この種の検出は主要サイトで使い続けられています。
他の指紋パラメータとの違いは変化の頻度です。CanvasやWebGLはハードウェアとレンダリングエンジンで決まるため、通常は数か月単位でしか動きません。一方、フォントリストはソフトウェアのインストールに連動し、オフィスソフトを1本入れる、フォントファイルを1つ消す、といった操作で変わります。変化の速いパラメータは、情報が漏れるのも速い。ソフトを1つ入れるだけで、リストは元の姿から逸れてしまいます。
サイトはフォントをどう測るのか:3つの方法、いずれも「ある・ない」の判定
Webサイトはシステムのフォント一覧を直接読めず、間接的に推測するしかありません。代表的な方法は次の3つです。
- 幅の差分測定。ページ内に決まった文字列を置き、まず代替フォント(monospaceなど)で幅を測り、次にターゲットのフォントを指定して測ります。2つの幅が一致すればターゲットフォントは存在せず、ずれれば存在します。検出スクリプトは一般的なフォント名を100以上、順番に試して「存在/不在」のリストを組み立てます。
- Canvasレンダリングの比較。Canvasで同じ文字列をフォントを変えて描画し、ピクセルの差異を比べます。このときレンダリングエンジンの違いも一緒に拾い上げます。
- Font Loading API。モダンブラウザは document.fonts.check('12px "Segoe UI"') のようなインターフェースを備え、フォントが利用可能かを直接返してくれます。幅を測るより手間がかかりません。
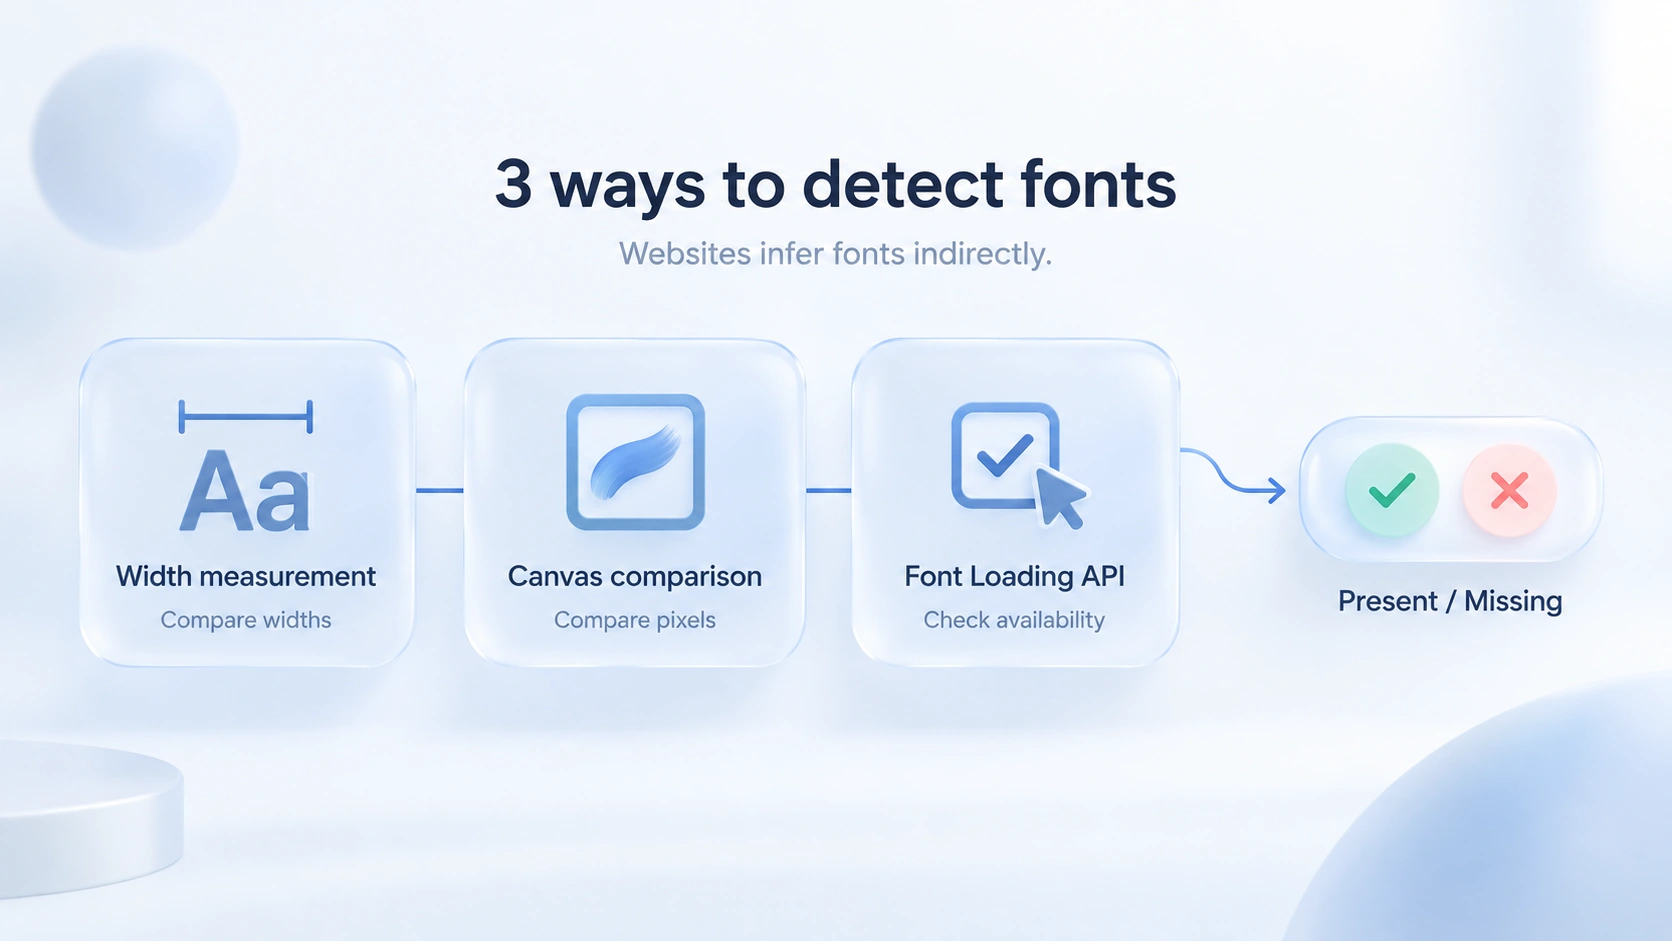
3つの方法が判定しているのは「このフォント名がこのマシンで使えるか」までで、フォントファイルそのものは見えていません。実際の検出は併用が一般的で、幅の差分測定を主軸に、Canvasでクロスチェックします。インターフェースの詳細はMDNのDocument.fontsドキュメント、テスト対象のフォント名一覧と判定ロジックはFingerprintJSのフォント検出ソースコードで確認できます。
検出結果はもともと不完全:全リストは手に入らない
まず、ありがちな誤解を一つ解いておきます。Webサイトが測れるのはインストール済みフォントの一部だけで、自分が用意した名簿に載っている分に限られます。検出結果の正体は、「よく使われるフォントの名簿 ∩ あなたのマシン」という積集合にすぎません。
影響は2つあります。1つ目は、フォント集合が異なる2台のマシンが同じ結果を取り得ることです。AマシンにはフォントAとB、BマシンにはAとCが入っていても、検出側がAとDしか試さなければ、2台とも「Aはあり、Dはなし」となり、ハッシュ値は同一になります。フォントフィンガープリントが一致しても、デバイスが同一だと逆算はできません。分かるのは「テスト名簿の範囲内で挙動が一致する」ことまでです。
2つ目は、名簿の外側が完全に見えないことです。フォントを300個入れたデザイン用ワークステーションと、まっさらな状態のマシンが並んでいても、テスト名簿が一般的な150フォントしかカバーしていなければ、残りの150個は検出側の視界に入りません。
複数アカウントの運用にとって、この不完全さは好都合とリスクの両方をはらみます。フォントだけで本人特定はできませんが、リスク管理はフォントを他のシグナルと突き合わせてきます。リストがOSや言語設定と食い違った瞬間、目立つ異常として浮上します。検出ツールが表示するフォント数やハッシュ値は、「同じ環境では安定、環境が違えば違う値」と読めば十分で、特定の数値を目指す必要はありません。
フォントリストを形作る4つの要素
フォント集合は4つの層が積み重なってできており、どの層も「一見同じに見える」2台のマシンの違いを露呈させ得ます。
- OSとそのバージョン。Windows、macOS、Linuxでは出荷時のフォントセットが異なり、同じWindowsでも10と11で差があります。フォントリストとUAが宣言するプラットフォームを相互に裏付けられるのは、このおかげです。
- システムの言語と地域。中国語版WindowsはSimSunやMicrosoft YaHeiを標準搭載しますが、欧米のマシンの大半にはありません。日本語版・韓国語版も同様の構造です。環境の実際の地域背景は、フォントリストから先に漏れることが少なくありません。
- アプリが持ち込むフォント。Office、Adobe、WPSはいずれも独自フォントをシステムに追加します。デザイン作業用のマシンと、ブラウザを動かすだけのマシンでは、フォント集合の差が大きくなります。
- ブラウザエンジンのフォールバック規則。同じフォント名でも、ChromiumとFirefoxでは代替フォントの選び方が違い、測定される幅も変わります。環境のエンジンバージョンが変われば、細部の結果も付きいて変わり得ます。
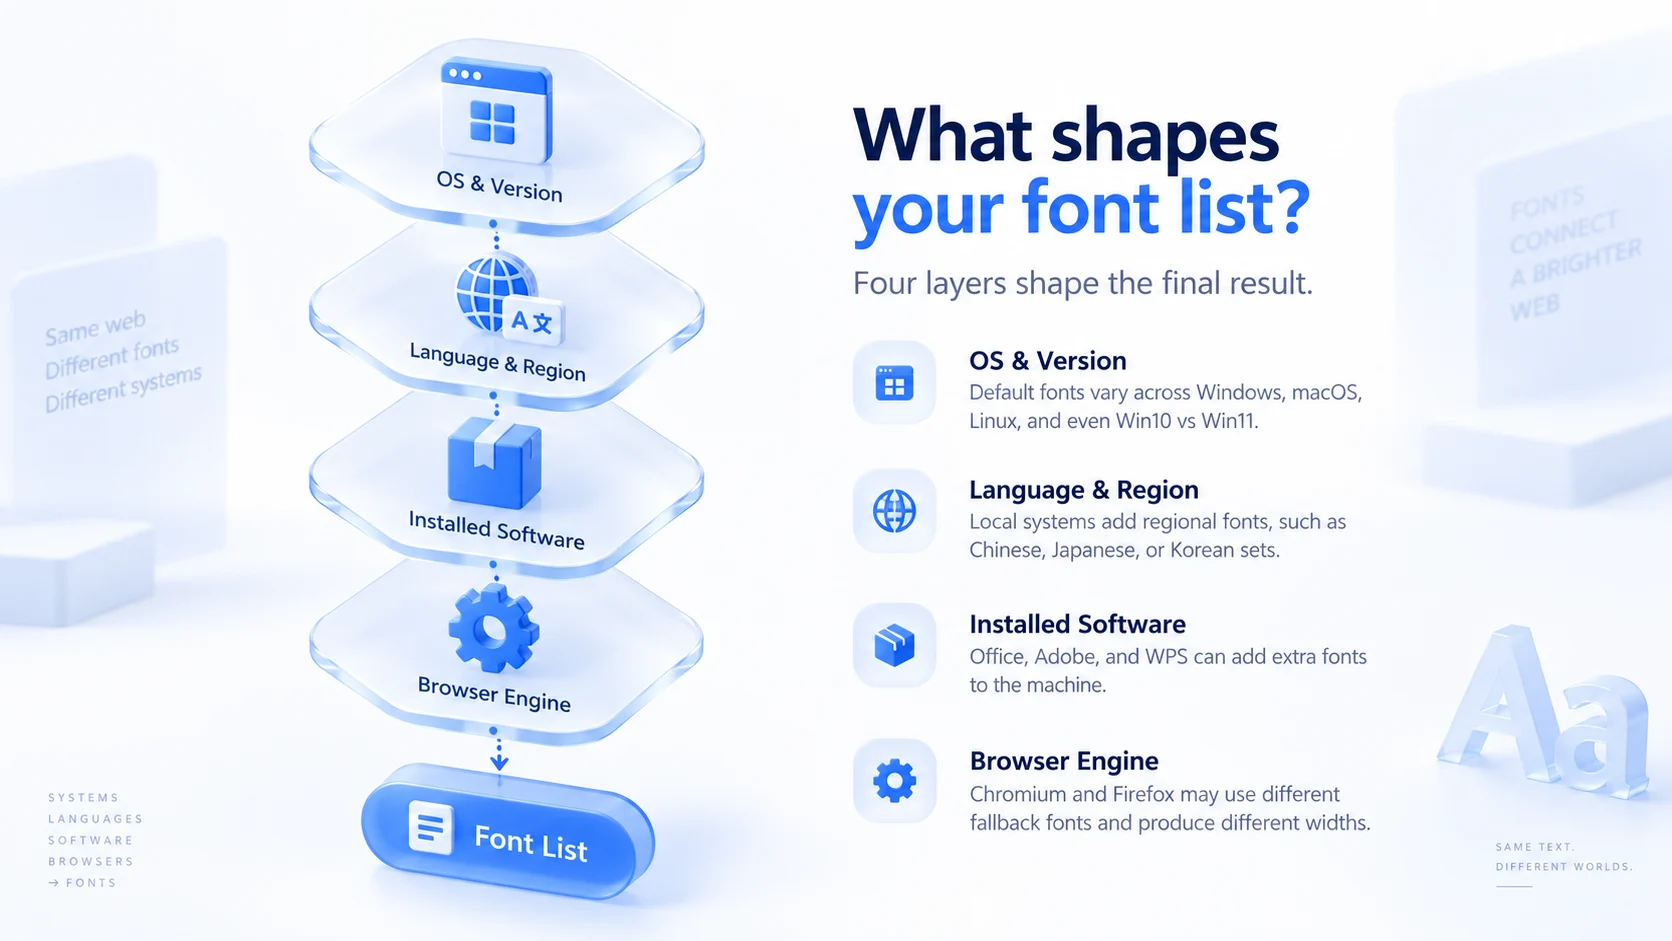
4層の重なりは、あるある現象も説明してくれます。IP、タイムゾーン、言語をそろえた環境でも、フォントリストに「出身地」の痕跡が残る――英語(米国)環境を名乗りながら、リストの中にMicrosoft YaHeiが寝ている、という具合です。クロスチェックの場面では、こうした食い違いは単一パラメータの異常よりはるかに雄弁です。
一貫性の判断基準:3条件と3ステップの自己点検
環境管理に置き換えると、フォントパラメータは次の3条件を満たす必要があります。
- 環境ごとの安定性。同じ環境で繰り返し検出しても、フォント数とハッシュ値が変わらないこと。環境の使用期間中に、むやみにソフトを入れたりフォントを消したりしない。
- 環境同士の差別化。別々の地域を名乗る環境なら、フォントリストに見て分かる差があること。「アメリカ人」と「ドイツ人」の2環境がまったく同じフォントハッシュを出したら、疑わしいシグナルです。
- 申告情報との整合。Windows環境にmacOS専用フォントが現れる、英語環境に中国語フォントがずらり並ぶ――いずれも目につく不整合です。パラメータのランダム化が抱えるリスクはなぜフィンガープリントのランダム化がかえって危険なのかで専ら論じています。フォントはその論理の最も典型的な例で、ランダムに組み合わせたフォントセットは実世界ではほぼ存在しません。
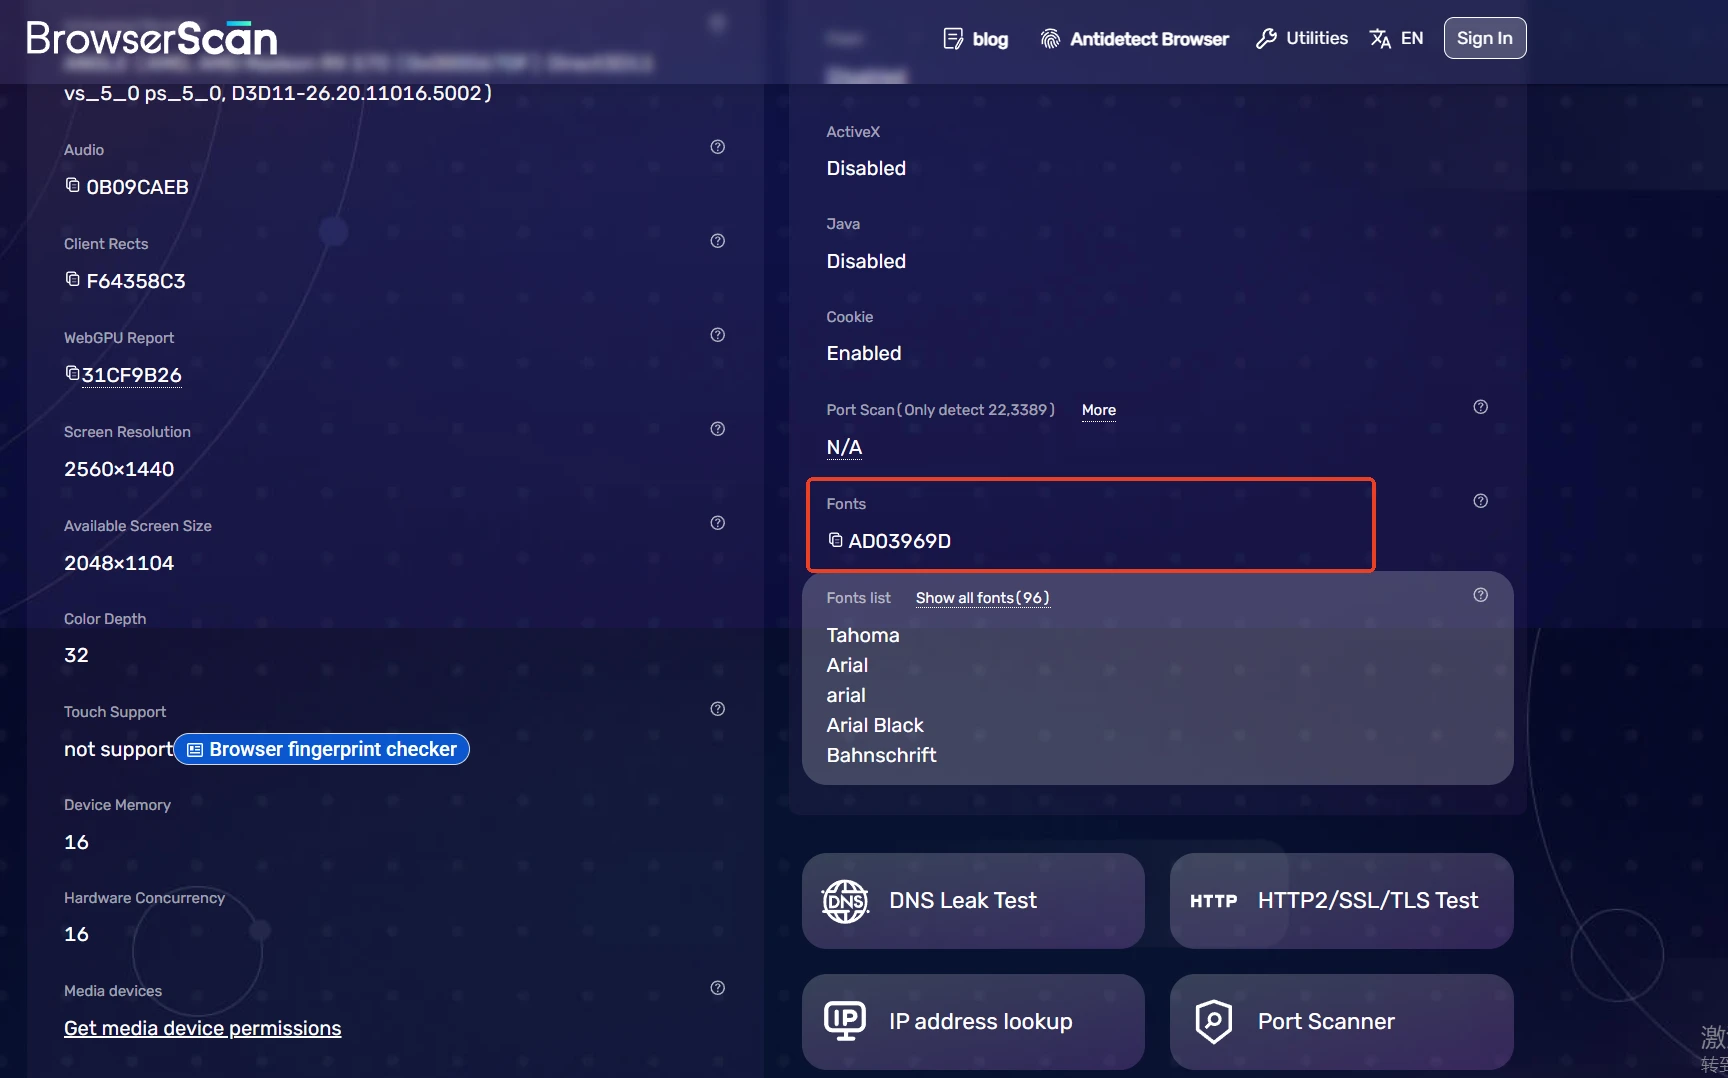
3ステップの自己点検:BrowserScanかIpheyの検出結果ページを開き、フォント(Fonts)の数値を控えます。同じ環境で2〜3回リロードして、数値が安定しているか確かめます。2つ目の環境を立ち上げて同じ検査を行い、差分がそれぞれのペルソナに合っているか比べます。
MostMateのフォントリスト3モードの選び方
MostMateのフィンガープリント設定では、フォントリストに実フォント・ランダム・カスタムの3モードが用意され、それぞれ向き不向きが分かれています。
- 実フォント:環境はホストマシンの現在のフォントリストをそのまま使います。検出結果は、ブラウザを手動で開いた場合と一致します。ホストマシンの構成がきれいで、ペルソナの地域がホストOSと一致している場合に向いています。たとえば手元が英語版Windowsで、まさに米国環境を作るというケースです。
- ランダム:環境がフォントの組み合わせを生成します。前提として、ランダム化アルゴリズムがOSと言語の範囲に沿って組み立てるため、集合はそのペルソナにとって妥当な範囲に収まります。環境をまとめて量産し、フォントの細部を1件ずつ確認する必要がない、日常の大量展開に向いています。
- カスタム:フォントリストを手動で選択します。対象プラットフォームのリスク管理が厳しい場合や、ペルソナとホストマシンの差が大きい環境に向いています。ペルソナに合わせて該当OSのフォントセットを補い、設定時には前節の3条件と突き合わせて1項目ずつ確認します。
3モードの入口は、いずれも環境作成フォームのフィンガープリント設定エリアにあります。設定後は、指紋プレビューパネルの「フォントリスト」欄で現在値を確認し、検出サイトで再測定して仕上げます。設定の一連の流れは、MostMateの始め方で解説しています。
おわりに
フォントフィンガープリントの本質は、Webサイトが限られたテスト名簿からマシンのフォント集合を推測することにあります。全リストは見えませんが、クロスチェックの場面で食い違いを暴くには十分です。運用で押さえるべきは3点、同一環境での安定、環境間での差別化、そしてフォントリストを申告するOS・地域との整合です。環境をゼロから立ち上げたい方は、まずMostMateをダウンロードしてください。各パラメータの一貫性の考え方は、MostMateの4つの設計原則で大半の対応する説明が見つかります。
FAQ
フォントフィンガープリントだけで1台の端末を特定できますか?
できません。検出結果はテスト名簿の範囲に制約され、フォント構成の異なる2台が同じ結果を取り得ます。リスク管理では通常、フォントをUA、Canvas、言語などと並べてクロスチェックします。フォント単独では、身元の根拠になりません。
ブラウザが違えばフォントフィンガープリントも同じになりますか?
フォント集合が同じなら大筋は一致しますが、エンジンごとにフォールバック規則とレンダリングの細部が異なるため、幅の数値には差が出ます。同じマシンでもChromeとFirefoxの検出結果には細かい違いがよくあり、これはエンジン差によるものです。
フォントをたくさん入れるほど識別されやすくなりますか?
増えたフォントは、検出名簿に含まれる場合にしか見えません。数量そのものの影響は限定的です。例外はニッチなフォントで、マイナーなデザインフォントが一度引っかかると、そのリストは統計的に珍しいものと映ります。
Cookieを消せばフォントフィンガープリントも消せますか?
消えません。フォントリストはローカルマシンのインストール状況から来るもので、サイト側の保存データではありません。Cookieやキャッシュの削除は影響しません。変えたい場合は、環境レベルでフォント設定を差し替える必要があります。

MOSTMATE
安全な複数アカウント管理を、もっと簡単に
最初のアカウントから、MostMate でより安全でスマート、効率的な複数アカウント運用を始めましょう。
- 独立したプロファイル。一貫した識別情報。
- AI 自動化 · アカウント健全性 · チーム運用



